IA generativa en proyectos personales: Día 1
 Jeshua Romero Guadarrama
- 45 Min para leer
- 01 Jan, 2026
Índice de contenido
Resumen:
Un modelo generativo no decide entre etiquetas: aprende cómo se distribuyen los datos y produce ejemplos nuevos a partir de esa distribución. En esta primera entrada construirá a mano el modelo generativo más sencillo posible, un modelo de bigramas entrenado con las 12 notas de estudio de Sofía, muestreará frases con él y medirá su perplejidad. Al terminar sabrá distinguir generar de clasificar, ubicar los hitos de la IA generativa y hacer su primera llamada a Claude desde Python leyendo cuántos tokens consume y cuánto cuesta.
¿Cómo citar el presente artículo?
Romero, J. (1 de enero de 2026). IA generativa en proyectos personales: Día 1. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_1/.
IA generativa en proyectos personales: Día 1 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_1/.
Modelos, precios y regulación revisados en octubre de 2026.
Día 1. Qué es la IA generativa y por qué cabe en un proyecto personal
Introducción
Durante los próximos 24 días aprenderá a aplicar herramientas de IA generativa en proyectos personales. No se trata de una colección de trucos para pedirle cosas a un asistente, sino de un recorrido con código, cifras y decisiones de diseño: cada entrada explica un concepto, lo calcula en Python con un ejemplo pequeño y reproducible, y lo convierte en una pieza de un proyecto real que crece día a día.
Ese proyecto se llama Cuaderno Vivo. Lo construye Sofía, una estudiante de posgrado que toma notas de estadística, de Python, de historia del arte y de música, que dibuja en los márgenes de sus apuntes y que toca la guitarra por las noches. Sofía quiere un asistente personal de estudio y diario creativo que resuma sus notas, le haga preguntas de repaso, le proponga portadas para cada semana y, más adelante, le lea en voz alta un resumen de lo que estudió. Tiene una laptop, ganas de aprender y una restricción muy concreta: no puede gastar más de 10 USD al mes en servicios de IA.
A su lado está Diego, un amigo ingeniero que desconfía de todo lo que suene a magia. Diego aparecerá en cada entrada con preguntas incómodas: ¿Cuánto cuesta esto al mes?, ¿A dónde van sus notas cuando las envía a una API?, ¿Y si alguien usa su voz? Sus preguntas no son un adorno: son la mirada de riesgos que la serie trata a fondo en el módulo 5.
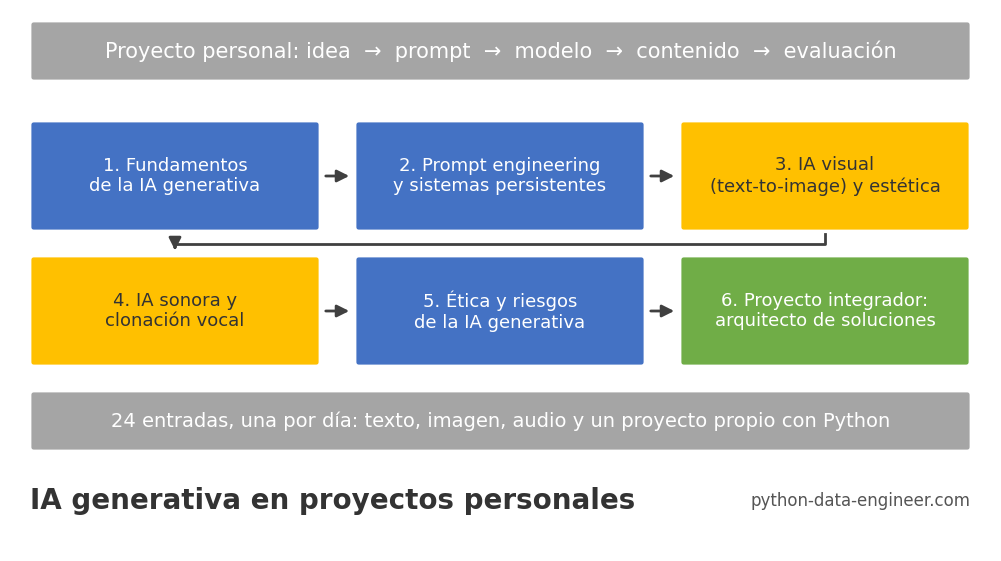
El recorrido se divide en seis módulos de cuatro días cada uno:
- Módulo 1/6, Fundamentos de la IA generativa (días 1 a 4): qué es generar, cómo se representa el texto, cómo elige un modelo la siguiente palabra y qué herramientas existen.
- Módulo 2/6, Prompt engineering y sistemas persistentes (días 5 a 8): cómo se escribe una instrucción para un modelo, cómo se obtienen salidas estructuradas y cómo se le da memoria al asistente.
- Módulo 3/6, IA visual (días 9 a 12): cómo nace una imagen a partir de ruido y cómo se diseñan portadas con una guía de estilo.
- Módulo 4/6, IA sonora (días 13 a 16): el sonido como datos, la síntesis de voz y la clonación de la voz propia con consentimiento.
- Módulo 5/6, Ética y riesgos (días 17 a 20): alucinaciones, sesgos, privacidad, inyección de instrucciones, autoría y procedencia.
- Módulo 6/6, Proyecto integrador (días 21 a 24): arquitectura, orquestación, evaluación con presupuesto y la entrega final como pieza de portafolio.
En la presente entrada, descubrirá qué distingue a un modelo generativo de uno que solo clasifica, construirá con sus propias manos un modelo de lenguaje de bigramas a partir de las notas de Sofía, lo usará para inventar frases nuevas y medirá qué tan sorprendido queda ante una frase que nunca vio. Verá también por qué unas pocas palabras dominan cualquier texto (la ley de Zipf), repasará en una línea de tiempo los hitos que llevaron a los asistentes actuales y, al final, hará su primera llamada a Claude desde Python. La pieza que el Cuaderno Vivo gana hoy es modesta pero fundamental: un generador de frases de juguete y la primera conexión con un modelo real, con su coste medido en fracciones de centavo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Distinguir un modelo discriminativo, que estima $p(y \mid x)$, de uno generativo, que aprende $p(x)$ y produce muestras nuevas.
- Construir a mano el modelo generativo más simple posible (bigramas) y muestrear frases con él.
- Reconocer las modalidades de la IA generativa (texto, imagen, audio, código) y sus hitos históricos.
- Presentar el proyecto hilo Cuaderno Vivo, su presupuesto y el plan de los 24 días.
- Hacer una primera llamada a Claude desde Python y leer su consumo de tokens.
Generar frente a clasificar
Casi todo el aprendizaje automático que se enseña en un primer curso es discriminativo: dado un ejemplo $x$, el modelo decide a qué clase $y$ pertenece. Un filtro de correo no deseado recibe un mensaje y responde “spam” o “no spam”; un modelo de riesgo crediticio recibe el historial de un cliente y responde “aprobar” o “rechazar”. En términos de probabilidad, lo que estos modelos estiman es la probabilidad condicional de la etiqueta dado el ejemplo:
$$ \text{discriminativo:}\quad p(y \mid x) \qquad\qquad \text{generativo:}\quad p(x) $$
Un modelo generativo hace algo distinto y más ambicioso: aprende cómo se distribuyen los propios ejemplos, $p(x)$. Ya no responde a la pregunta ¿de qué clase es este correo?, sino a la pregunta ¿qué aspecto tiene un correo típico? Y una vez que sabe responderla, puede producir correos nuevos que se parecen a los que vio. El filtro de spam y un redactor automático de correos pueden entrenarse con exactamente los mismos mensajes; lo que cambia es la pregunta que el modelo aprende a contestar.
La lógica detrás de esta distinción es múltiple:
- La primera parte, $p(y \mid x)$, solo necesita aprender la frontera entre clases. Al filtro de spam le basta con saber que “gratis” y “urgente” empujan hacia una clase; no necesita saber cómo se escribe una frase completa.
- La segunda parte, $p(x)$, necesita aprender todo el objeto: qué palabras aparecen, en qué orden, con qué frecuencia y en qué combinaciones. Es una tarea mucho más difícil, porque el espacio de frases posibles es astronómicamente grande.
- En conclusión, un modelo generativo carga con más trabajo, pero a cambio puede crear: escribir, dibujar, componer o programar algo que no estaba en sus datos de entrenamiento.
Existe una relación entre ambas familias. Por la regla de Bayes, $p(y \mid x) = p(x \mid y),p(y) / p(x)$, de modo que un modelo generativo de cada clase permite, en principio, clasificar. Lo contrario no es cierto: un clasificador no sabe generar. Por eso los modelos generativos grandes también clasifican bastante bien cuando se les pide (lo verá en el Día 6), mientras que ningún filtro de spam ha escrito jamás un correo.
Generar es aprender la distribución completa de los datos, no solo la frontera entre clases. Esa es la idea que sostiene toda la serie.
Un modelo generativo es una distribución de la que se puede muestrear
Si un modelo generativo es una distribución de probabilidad, ¿cómo se obtiene de él una frase, una imagen o un sonido? La respuesta es el muestreo: se lanza un dado cargado con las probabilidades que el modelo aprendió, y el resultado del dado es el ejemplo nuevo. Si la distribución dice que, después de “la”, la palabra “guitarra” tiene probabilidad $0.18$ y la palabra “media” también $0.18$, el dado elegirá una de las dos con esa frecuencia a la larga, y alguna otra palabra el resto de las veces.
Dos consecuencias prácticas se derivan de esta idea y conviene tenerlas presentes desde el primer día:
- El resultado es aleatorio: la misma petición puede dar respuestas distintas. Eso es lo que hace que un asistente “suene natural”, pero también lo que complica las pruebas.
- La aleatoriedad se puede fijar con una semilla: si el generador de números aleatorios arranca siempre en el mismo punto, el dado cae siempre igual y los resultados son reproducibles. En toda la serie se usa la semilla
2026.
Los grandes modelos de lenguaje funcionan con la misma lógica a una escala enorme: en cada paso calculan una distribución sobre miles de posibles fragmentos de texto y muestrean uno. El Día 3 abre esa caja (softmax, temperatura, top-k y top-p). Hoy basta con construir un dado cargado a mano.
Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie usando el siguiente código:
# Importaciones base y semilla global de la serie en Python:
import warnings
warnings.filterwarnings('ignore')
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

rng = np.random.default_rng(2026)
print('numpy', np.__version__, '| pandas', pd.__version__)
numpy 2.4.6 | pandas 3.0.3
El bloque imprime las versiones de numpy y pandas con las que se ejecutó esta entrada. Si usted usa versiones distintas, las cifras deberían coincidir, pero el formato de algunas salidas puede variar ligeramente. El objeto rng es el generador aleatorio moderno de numpy; todo el muestreo del día pasará por él.
Las notas de Sofía: un corpus de juguete
Un modelo generativo necesita datos de los que aprender. Los grandes modelos se entrenan con billones de palabras; el Cuaderno Vivo empieza con un corpus (conjunto de textos) diminuto: las 12 notas cortas que Sofía escribió durante su primera semana de estudio. Hay tres notas por cada uno de sus cuatro intereses, y cada una tiene entre 17 y 21 palabras, como puede consultar en la Tabla 1. Estas notas reaparecerán en los días 2, 5, 6, 7, 8, 18, 19 y 23, así que conviene familiarizarse con ellas.
Tabla 1. Las 12 notas de estudio de Sofía.
| Id | Tema | Texto | Palabras |
|---|---|---|---|
| 1 | estadística | La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra. | 21 |
| 2 | estadística | La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos. | 21 |
| 3 | estadística | Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra. | 21 |
| 4 | python | En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos. | 20 |
| 5 | python | Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas. | 21 |
| 6 | python | Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código. | 19 |
| 7 | historia del arte | El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura. | 17 |
| 8 | historia del arte | El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta. | 19 |
| 9 | historia del arte | El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro. | 19 |
| 10 | música | Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra. | 19 |
| 11 | música | Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones. | 21 |
| 12 | música | Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable. | 20 |
Las notas son de un personaje ficticio, escritas para esta serie. Fíjese en que comparten muchas palabras pequeñas (“la”, “de”, “un”, “y”) y en que algunos temas tienen palabras propias que se repiten (“media” en estadística, “guitarra” en música, “perspectiva” en historia del arte). Esa repetición es justamente lo que un modelo generativo puede aprovechar.
Carguemos las notas en un DataFrame de pandas y contemos sus palabras con el siguiente código:
# Corpus de juguete: las 12 notas de estudio de Sofía en Python:
notas = [
    ('estadística', 'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.'),
    ('estadística', 'La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos.'),
    ('estadística', 'Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra.'),
    ('python', 'En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos.'),
    ('python', 'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.'),
    ('python', 'Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código.'),
    ('historia del arte', 'El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura.'),
    ('historia del arte', 'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.'),
    ('historia del arte', 'El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro.'),
    ('música', 'Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra.'),
    ('música', 'Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones.'),
    ('música', 'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'),
]
datos = pd.DataFrame(notas, columns = ['tema', 'texto'])
datos.insert(0, 'id', range(1, len(datos) + 1))
datos['palabras'] = datos['texto'].str.split().str.len()

# Primeras notas y total de palabras del corpus:
print(datos[['id', 'tema', 'palabras']].head())
print('Total de palabras:', datos['palabras'].sum())
print('Promedio por nota:', round(datos['palabras'].mean(), 1))
   id         tema  palabras
0   1  estadística        21
1   2  estadística        21
2   3  estadística        21
3   4       python        20
4   5       python        21
Total de palabras: 238
Promedio por nota: 19.8
El corpus completo tiene $238$ palabras, con un promedio de $19.8$ palabras por nota. Por tema, estadística suma $63$ palabras, Python $60$, música $60$ e historia del arte $55$: un reparto bastante equilibrado, lo cual evita que un solo tema domine lo que el modelo aprenda.
Para ponerlo en perspectiva, $238$ palabras caben en media página. Los modelos de lenguaje actuales se entrenan con corpus del orden de $10^{13}$ fragmentos de texto, unas cuarenta mil millones de veces más. Nada de lo que hoy construya competirá con un asistente comercial, y no es ese el objetivo: el objetivo es ver, con números que se pueden comprobar a mano, cada pieza del mecanismo que esos asistentes repiten a escala gigantesca.
El modelo de bigramas
Una frase es una secuencia de palabras $w_1, w_2, \dots, w_T$. Un modelo generativo de frases debe asignar una probabilidad a cada secuencia posible. La regla de la cadena de la probabilidad permite descomponer esa tarea en pasos: la probabilidad de la frase es el producto de la probabilidad de cada palabra dadas todas las anteriores. El modelo de bigramas hace una simplificación drástica: supone que cada palabra solo depende de la palabra inmediatamente anterior (una suposición de Markov de orden uno).
$$ p(w_1, \dots, w_T) = \prod_{t=1}^{T} p(w_t \mid w_1, \dots, w_{t-1}) \approx \prod_{t=1}^{T} P(w_t \mid w_{t-1}) $$
¿Y de dónde sale cada $P(w_t \mid w_{t-1})$? De contar. Si en el corpus la palabra “de” aparece $11$ veces seguida de algo, y $4$ de esas veces la siguiente palabra es “la”, el modelo estima que después de “de” viene “la” con probabilidad $4/11$. Es el estimador de máxima verosimilitud:
$$ P(w_t \mid w_{t-1}) = \frac{c(w_{t-1}, w_t)}{c(w_{t-1})} $$
La lógica detrás de esta fórmula es múltiple:
- La primera parte, el numerador $c(w_{t-1}, w_t)$, cuenta cuántas veces aparece el par exacto de palabras consecutivas (el bigrama) en el corpus. Es la evidencia directa de que esa transición existe.
- La segunda parte, el denominador $c(w_{t-1})$, cuenta cuántas veces aparece la palabra anterior seguida de cualquier cosa. Dividir entre ella convierte los conteos en una distribución: las probabilidades de todas las palabras que pueden seguir a $w_{t-1}$ suman $1$.
- En conclusión, el modelo de bigramas es una tabla de frecuencias relativas: para cada palabra, qué palabras la siguieron y en qué proporción. No hay gradientes, ni redes, ni entrenamiento iterativo; solo conteo.
Para que el modelo sepa cómo empiezan y cómo terminan las frases, se añaden dos marcas artificiales: <s> al inicio y </s> al final. Así, $P(\text{la} \mid \texttt{})$ es la probabilidad de que una nota empiece por “la”, y $P(\texttt{} \mid \text{muestra})$ es la probabilidad de que una nota termine después de “muestra”.
Puede tokenizar las notas y contar sus bigramas en Python usando la clase Counter del módulo collections, como se hace en el siguiente código:
# Tokenización por palabras y conteo de bigramas en Python:
import re
from collections import Counter

def tokenizar(texto):
    # Minúsculas, solo palabras y marcas de inicio y fin de frase:
    return ['<s>'] + re.findall(r'\w+', texto.lower()) + ['</s>']

frases = [tokenizar(texto) for texto in datos['texto']]
bigramas = Counter()
for frase in frases:
    bigramas.update(zip(frase[:-1], frase[1:]))

vocabulario = sorted({palabra for frase in frases for palabra in frase})
print('Tamaño del vocabulario:', len(vocabulario))
print('Bigramas distintos:', len(bigramas), '| bigramas totales:', sum(bigramas.values()))
print('Bigramas que aparecen una sola vez:', sum(1 for v in bigramas.values() if v == 1))
for (anterior, siguiente), conteo in bigramas.most_common(10):
    print(f'{anterior:>10} -> {siguiente:<10} {conteo}')
Tamaño del vocabulario: 132
Bigramas distintos: 221 | bigramas totales: 250
Bigramas que aparecen una sola vez: 201
        de -> la         4
        la -> media      3
     ayuda -> a          3
       con -> un         3
        el -> mismo      3
       <s> -> el         3
      tono -> tono       3
        la -> guitarra   3
       <s> -> la         2
        de -> datos      2
El vocabulario tiene $132$ símbolos: $130$ palabras distintas más las dos marcas. Las 12 notas producen $250$ bigramas en total (las $238$ palabras más una transición final por nota), de los cuales $221$ son distintos, y $201$ de esos $221$ aparecen una sola vez. Dicho de otro modo, nueve de cada diez pares de palabras distintos se vieron una única vez. El bigrama más repetido es “de la”, con $4$ apariciones, y entre los diez primeros aparecen huellas claras de cada tema: “la media” (estadística), “la guitarra” y “tono tono” (música), “el mismo” (que comparten el cubismo, las funciones de Python y los acordes).
Observe también la decisión de tokenización: la expresión regular \w+ separa por cualquier carácter que no sea letra o dígito, de modo que las comas y los puntos desaparecen y “Python” y “python” se funden en una sola palabra. Es una decisión cómoda y discutible a la vez; en el Día 2 verá por qué los modelos reales prefieren trocear el texto en subpalabras.
Matriz de transición
Con los conteos en la mano, el modelo completo es una matriz de transición: una fila por cada palabra actual, una columna por cada palabra siguiente y, en cada celda, la probabilidad $P(\text{columna} \mid \text{fila})$. Cada fila suma $1$. La función pandas.crosstab con normalize = 'index' calcula exactamente eso en una línea. Como la matriz completa tiene $131 \times 131$ celdas, conviene mirar un fragmento: el de las palabras más frecuentes, como se muestra en la Tabla 2 y en el mapa de calor de abajo.
Puede construir la matriz y dibujar su mapa de calor usando el siguiente código:
# Matriz de transición normalizada por filas y mapa de calor en Python:
pares = pd.DataFrame([(a, b) for frase in frases for a, b in zip(frase[:-1], frase[1:])],
                     columns = ['anterior', 'siguiente'])
transicion = pd.crosstab(pares['anterior'], pares['siguiente'], normalize = 'index')

# Las 12 palabras más frecuentes (sin las marcas de frase):
frecuencias = Counter(p for frase in frases for p in frase if p not in ('<s>', '</s>'))
top = [p for p, _ in frecuencias.most_common(12)]
submatriz = transicion.reindex(index = top, columns = top, fill_value = 0)
print(submatriz.iloc[:6, :6].round(2))
print('Celdas vacías de la matriz completa:', f'{(transicion.values == 0).mean():.1%}')
print('Tras "la":', transicion.loc['la'].sort_values(ascending = False).head(3).round(2).to_dict())

fig, ax = plt.subplots(figsize = (7.5, 6.2))
imagen = ax.imshow(submatriz.values, cmap = 'Blues', vmin = 0)
ax.set_xticks(range(len(top)))
ax.set_xticklabels(top, rotation = 45, ha = 'right')
ax.set_yticks(range(len(top)))
ax.set_yticklabels(top)
ax.set_xlabel('Palabra siguiente')
ax.set_ylabel('Palabra actual')
ax.set_title('Matriz de transición de bigramas', fontsize = 16)
fig.colorbar(imagen, ax = ax, label = 'P(siguiente | actual)')
plt.tight_layout()

# Probabilidad de pasar de cada palabra frecuente a otra:
plt.show()
siguiente    la    un   de    y   en    el
anterior
la         0.00  0.00  0.0  0.0  0.0  0.00
un         0.00  0.00  0.0  0.0  0.0  0.00
de         0.36  0.00  0.0  0.0  0.0  0.00
y          0.18  0.00  0.0  0.0  0.0  0.00
en         0.25  0.12  0.0  0.0  0.0  0.12
el         0.00  0.00  0.0  0.0  0.0  0.00
Celdas vacías de la matriz completa: 98.7%
Tras "la": {'guitarra': 0.18, 'media': 0.18, 'perspectiva': 0.12}
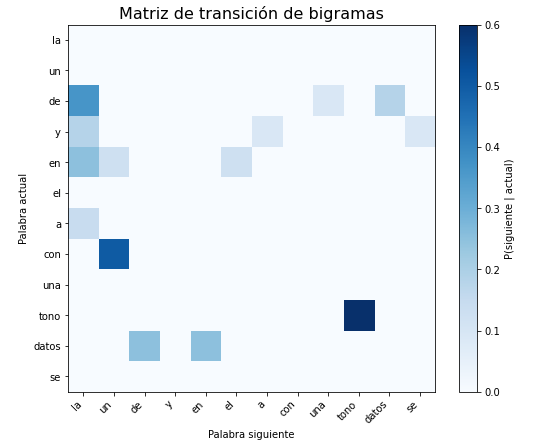
La salida impresa es el fragmento de $6 \times 6$ que recoge la Tabla 2: las seis palabras más frecuentes del corpus, como palabra actual (filas) y como palabra siguiente (columnas).
Tabla 2. Fragmento de la matriz de transición: P(siguiente | actual) para las seis palabras más frecuentes.
| Actual \ Siguiente | la | un | de | y | en | el |
|---|---|---|---|---|---|---|
| la | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| un | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| de | 0.36 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| y | 0.18 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
| en | 0.25 | 0.12 | 0.00 | 0.00 | 0.00 | 0.12 |
| el | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 | 0.00 |
La tabla parece casi vacía, y esa es la lección. Las palabras más frecuentes son artículos y preposiciones, y en español un artículo casi nunca va seguido de otro artículo: después de “la” viene un sustantivo (“guitarra”, “media”, “perspectiva”), no “un” ni “de”. Las únicas celdas con valor son las combinaciones gramaticales naturales: “de la” con $0.36$ ($4$ de $11$), “en la” con $0.25$, “y la” con $0.18$. La fila de “la” muestra el reparto que se le escapa a la tabla: tras “la”, el modelo elige “guitarra” o “media” con probabilidad $0.18$ cada una y “perspectiva” con $0.12$.
En la matriz completa, el $98.7%$ de las celdas está vacío. El mapa de calor lo hace visible: unas pocas celdas oscuras sobre un mar blanco. La más intensa es “tono” seguido de “tono”, con probabilidad $0.6$, una huella directa de la nota 10, que describe el patrón de la escala mayor; la siguiente es “con” seguido de “un” ($0.5$). Un modelo de bigramas solo conoce las transiciones que vio; cualquier par ausente del corpus tiene probabilidad cero. Esa limitación tiene consecuencias serias, como verá en la sección de perplejidad.
Muestrear frases nuevas
El modelo ya está construido. Para generar una frase basta con aplicar la idea del dado cargado: se empieza en <s>, se lanza el dado de esa fila para elegir la primera palabra, se pasa a la fila de esa palabra, se vuelve a lanzar, y así hasta que salga </s> o se alcance un tope de seguridad de $15$ palabras.
Puede muestrear cinco frases con la semilla de la serie usando el siguiente código:
# Muestreo de frases nuevas con la matriz de transición en Python:
def muestrear_frase(transicion, rng, maximo = 15):
    palabra, generadas = '<s>', []
    while len(generadas) < maximo:
        fila = transicion.loc[palabra]
        palabra = rng.choice(fila.index, p = fila.values)
        if palabra == '</s>':
            break
        generadas.append(palabra)
    return ' '.join(generadas)

rng = np.random.default_rng(2026)
for i in range(1, 6):
    print(f'{i}. {muestrear_frase(transicion, rng)}')
1. el patrón tono semitono tono tono tono semitono y crea una tabla de una lista
2. un intervalo de dos grupos
3. la paleta
4. la luz al aire libre con pocas líneas
5. practicar la proporción del arte clásico para sumar los datos en la media resume un
Estas cinco frases no están en ninguna nota de Sofía, y sin embargo cada par de palabras consecutivas sí lo está. La frase 1 empieza en la nota de la escala mayor y, al llegar a “y”, salta a la nota de pandas (“y crea una tabla”). La frase 4 mezcla el impresionismo (“la luz al aire libre con”) con la nota de pandas (“con pocas líneas”). La frase 5 alcanza el tope de $15$ palabras sin llegar a </s>, por eso termina en “resume un”, a media idea.
La lectura correcta de este resultado tiene dos caras:
- Lo que sí logra el modelo: cada transición local es plausible, la gramática a corto plazo se respeta y las frases son nuevas. Eso es, en miniatura, generar.
- Lo que no logra: no hay coherencia global. El modelo no recuerda de qué estaba hablando dos palabras atrás, así que “practicar la proporción del arte clásico para sumar los datos” mezcla música, arte y Python sin el menor reparo.
- En conclusión, la calidad de un modelo generativo depende de cuánto contexto puede tener en cuenta. Los bigramas miran una palabra atrás; los transformadores del Día 3 miran miles.
Diego leyó las cinco frases y comentó, medio en broma, que la frase 4 sonaba a poesía. Tiene razón en algo importante: esas frases no son de Sofía. Son recombinaciones de su texto hechas por un procedimiento estadístico. La pregunta de a quién pertenece un texto generado, y cómo debe etiquetarse, se trata a fondo en el Día 20.
¿Qué tan sorprendido está el modelo? La perplejidad
Muestrear frases permite juzgar un modelo a ojo, pero se necesita una medida objetiva. La más usada en modelos de lenguaje es la perplejidad (o PP, por sus siglas en inglés: “Perplexity”). La idea es medir cuánta probabilidad asigna el modelo a un texto de prueba: si el modelo “esperaba” esas palabras, la probabilidad será alta y la perplejidad baja; si cada palabra lo toma por sorpresa, la perplejidad será alta.
Hay un problema previo. Con el estimador de conteos, cualquier bigrama que no apareció en las notas tiene probabilidad $0$, y basta un solo cero para que la probabilidad de toda la frase sea $0$ y su logaritmo, menos infinito. La solución clásica es el suavizado de Laplace: sumar una pequeña cantidad $\alpha$ a todos los conteos, vistos o no, y repartir esa masa extra entre las $V$ palabras posibles:
$$ P_{\alpha}(w_t \mid w_{t-1}) = \frac{c(w_{t-1}, w_t) + \alpha}{c(w_{t-1}) + \alpha V} $$
Con esa probabilidad suavizada, la perplejidad de un texto de $N$ transiciones se define como:
$$ PP = 2^{-\frac{1}{N}\sum_{t=1}^{N} \log_2 P_{\alpha}(w_t \mid w_{t-1})} $$
La lógica detrás de esta métrica es múltiple:
- La primera parte, $\log_2 P$, convierte cada probabilidad en una medida de sorpresa en bits: una palabra con probabilidad $1/2$ cuesta $1$ bit; una con probabilidad $1/128$ cuesta $7$ bits. Sumar logaritmos equivale a multiplicar probabilidades, pero sin que el producto se vuelva diminuto.
- La segunda parte, dividir entre $N$ y cambiar el signo, da la sorpresa promedio por palabra, de modo que frases cortas y largas se pueden comparar.
- La tercera parte, elevar $2$ a ese promedio, devuelve el resultado a una escala intuitiva: una perplejidad de $60$ significa que el modelo está tan indeciso como si, en cada paso, eligiera al azar entre $60$ palabras igual de probables.
- En conclusión, la perplejidad es el número efectivo de opciones que el modelo considera en cada paso. Cuanto menor sea la perplejidad, mejor predice el modelo ese texto.
Dos detalles de implementación. Primero, las palabras que el modelo nunca vio se sustituyen por un símbolo especial <unk> (“desconocida”). Segundo, $V$ cuenta todas las palabras que pueden aparecer como siguiente: las $130$ palabras del corpus, la marca </s> y <unk>, es decir, $V = 132$ (la marca <s> nunca se predice). Con $\alpha = 1$, el suavizado es fuerte: la probabilidad de “la” tras “de” baja de $4/11 = 0.36$ a $(4 + 1)/(11 + 132) = 0.035$. Tenga presente esa cifra al leer el resultado.
Puede calcular la perplejidad de una nota que el modelo vio y de una frase nueva usando el siguiente código:
# Perplejidad de una frase con suavizado de Laplace en Python:
conteo_anterior = Counter(a for frase in frases for a in frase[:-1])
vocabulario_suavizado = set(vocabulario) | {'<unk>'}
V = len(vocabulario_suavizado) - 1  # sin contar '<s>', que nunca se predice

def perplejidad(texto, alpha):
    tokens = [t if t in vocabulario_suavizado else '<unk>' for t in tokenizar(texto)]
    log_suma = 0.0
    for anterior, siguiente in zip(tokens[:-1], tokens[1:]):
        p = (bigramas[(anterior, siguiente)] + alpha) / (conteo_anterior[anterior] + alpha * V)
        log_suma += np.log2(p)
    N = len(tokens) - 1
    return 2 ** (-log_suma / N)

nota_vista = datos.loc[11, 'texto']
frase_nueva = 'La música ayuda a estudiar estadística'
print('V =', V)
print('Nota vista:', round(perplejidad(nota_vista, 1.0), 1))
print('Frase nueva:', round(perplejidad(frase_nueva, 1.0), 1))
V = 132
Nota vista: 60.1
Frase nueva: 96.4
Con $\alpha = 1$, la nota 12 (“Practicar la guitarra cada día…”) obtiene una perplejidad de $60.1$ y la frase nueva “La música ayuda a estudiar estadística” una de $96.4$. El orden es el esperado: el modelo está menos sorprendido ante un texto que ya vio que ante uno nuevo, en el que “música”, “estudiar” y “estadística” son palabras desconocidas.
Ahora bien, $60.1$ es una cifra alta para una nota que el modelo leyó palabra por palabra. Equivale a dudar entre $60$ opciones en cada paso, cuando en realidad casi todas las transiciones de esa nota aparecieron una sola vez y el modelo podría predecirlas con mucha seguridad. La culpa es de $\alpha = 1$: con un vocabulario de $132$ palabras y conteos tan pequeños, sumar $1$ a cada celda reparte la mayor parte de la probabilidad entre transiciones que nunca ocurrieron. ¿Qué pasa si se suaviza menos?
Puede barrer varios valores de $\alpha$ y graficar las dos perplejidades usando el siguiente código:
# Barrido del parámetro de suavizado alpha en Python:
alphas = [0.01, 0.1, 0.5, 1]
resultados = pd.DataFrame({
    'alpha': alphas,
    'nota_vista': [perplejidad(nota_vista, a) for a in alphas],
    'frase_nueva': [perplejidad(frase_nueva, a) for a in alphas]
})
print(resultados.round({'nota_vista': 1, 'frase_nueva': 1}).to_string(index = False))

fig, ax = plt.subplots(figsize = (6.4, 4.8))
ax.plot(resultados['alpha'], resultados['nota_vista'], 'o-', color = '#2a78d6', linewidth = 2, markersize = 8, label = 'Nota vista (id 12)')
ax.plot(resultados['alpha'], resultados['frase_nueva'], 's-', color = '#eb6834', linewidth = 2, markersize = 8, label = 'Frase nueva')
ax.set_xscale('log')
ax.set_yscale('log')
ax.set_xticks(alphas)
ax.set_xticklabels([str(a) for a in alphas])
ax.set_xlabel('Suavizado de Laplace (alpha)')
ax.set_ylabel('Perplejidad')
ax.set_title('Perplejidad según el suavizado', fontsize = 16)
ax.grid(True, which = 'major', color = '#e5e5e5', linewidth = 0.8)
ax.legend()
plt.tight_layout()

# Perplejidad de la nota vista y de la frase nueva para cada alpha:
plt.show()
 alpha  nota_vista  frase_nueva
  0.01         4.1         85.5
  0.10        13.4         70.7
  0.50        40.4         85.8
  1.00        60.1         96.4
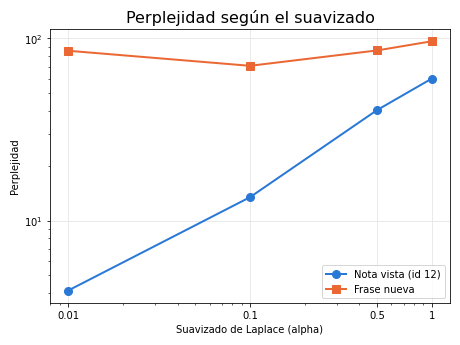
El gráfico muestra dos comportamientos muy distintos, y entenderlos es entender el dilema central de todo modelo generativo:
- En primer lugar, la perplejidad de la nota vista crece sin parar con $\alpha$: pasa de $4.1$ con $\alpha = 0.01$ a $60.1$ con $\alpha = 1$. Con poco suavizado, el modelo casi reproduce de memoria el texto de entrenamiento; con mucho, lo olvida.
- En segundo lugar, la perplejidad de la frase nueva no es monótona: baja de $85.5$ a un mínimo de $70.7$ en $\alpha = 0.1$ y vuelve a subir hasta $96.4$. Con $\alpha = 0.01$ el modelo castiga con dureza cada transición que no vio (“la música”, “a estudiar”); con $\alpha = 1$ aplana tanto la distribución que deja de distinguir lo plausible de lo absurdo.
Si siguiera aumentando $\alpha$, todas las probabilidades tenderían a $1/V$ y ambas perplejidades convergerían a $V = 132$: el modelo equivaldría a elegir palabras al azar. Note la conexión con la entrada de evaluación de pronósticos del blog: la nota vista hace el papel del error de entrenamiento, que siempre mejora cuando el modelo se ajusta más a sus datos, y la frase nueva el del error de prueba, que es el que importa. Un modelo que recuerda sus datos de memoria no es un buen modelo generativo; uno que lo olvida todo, tampoco. El valor útil de $\alpha$ se elige con texto que el modelo no vio, nunca con el de entrenamiento.
Atención aquí: La comparación anterior usa una sola frase nueva de seis palabras, así que el mínimo en $\alpha = 0.1$ es ilustrativo y no una medición fiable. Para elegir $\alpha$ en serio se necesita un conjunto de validación con muchas frases y, sobre todo, nunca comparar perplejidades calculadas con vocabularios distintos: si cambia $V$ o la forma de tokenizar, las cifras dejan de ser comparables, del mismo modo que un MSE solo se compara con otro MSE sobre el mismo conjunto de datos.
La ley de Zipf en un cuaderno
Ya vio que “la” aparece $17$ veces y que la mayoría de las palabras aparece una sola. No es una peculiaridad de las notas de Sofía. En 1949, el lingüista George Kingsley Zipf observó que en cualquier texto suficientemente largo la frecuencia de una palabra es aproximadamente inversamente proporcional a su posición (su rango) en la lista ordenada de frecuencias. La palabra más frecuente aparece el doble que la segunda, el triple que la tercera, y así sucesivamente:
$$ f(r) \approx \frac{f(1)}{r^{s}} \quad\Longleftrightarrow\quad \log f(r) \approx \log f(1) - s \log r, \qquad s \approx 1 $$
La lógica detrás de esta ley es múltiple:
- La primera parte dice que la frecuencia $f(r)$ cae como una potencia del rango $r$. Unas pocas palabras (artículos, preposiciones, conjunciones) acaparan buena parte del texto.
- La segunda parte, la versión con logaritmos, dice que en una gráfica log-log los puntos deberían formar una recta de pendiente $-s$, con $s$ cercana a $1$ en textos grandes.
- En conclusión, el lenguaje tiene una cola larga: muchísimas palabras raras que aparecen una o dos veces. Cualquier modelo que trabaje con palabras completas pasará la mayor parte del tiempo lidiando con palabras que casi nunca vio.
Puede ordenar las frecuencias, ajustar la pendiente y comparar con la recta de Zipf usando el siguiente código:
# Ley de Zipf: frecuencia frente a rango en escala log-log en Python:
conteos = np.array(sorted(frecuencias.values(), reverse = True))
rangos = np.arange(1, len(conteos) + 1)
pendiente, intercepto = np.polyfit(np.log10(rangos), np.log10(conteos), 1)
print('Palabras distintas:', len(conteos))
print('Las 5 más frecuentes:', frecuencias.most_common(5))
print('Pendiente ajustada:', round(pendiente, 2))
print('Palabras que aparecen una sola vez:', int((conteos == 1).sum()))

fig, ax = plt.subplots(figsize = (6.4, 4.8))
ax.loglog(rangos, conteos, 'o', color = '#2a78d6', markersize = 5, label = 'Corpus de Sofía')
ax.loglog(rangos, conteos[0] / rangos, '-', color = '#eb6834', linewidth = 2, label = 'Zipf: pendiente $-1$')
ax.set_xlabel('Rango de la palabra')
ax.set_ylabel('Frecuencia')
ax.set_title('Ley de Zipf en el cuaderno', fontsize = 16)
ax.grid(True, which = 'major', color = '#e5e5e5', linewidth = 0.8)
ax.legend()
plt.tight_layout()

# Frecuencia de cada palabra frente a su rango:
plt.show()
Palabras distintas: 130
Las 5 más frecuentes: [('la', 17), ('un', 11), ('de', 11), ('y', 11), ('en', 8)]
Pendiente ajustada: -0.62
Palabras que aparecen una sola vez: 102
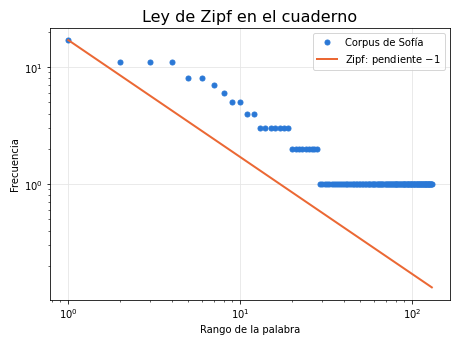
Las cinco palabras más frecuentes son “la” ($17$), “un”, “de” e “y” ($11$ cada una) y “en” ($8$): ninguna de ellas dice nada sobre estadística, Python, arte o música. Entre las cinco suman $58$ apariciones, casi la cuarta parte de las $238$ palabras del corpus. En el otro extremo, $102$ de las $130$ palabras distintas aparecen una sola vez, es decir, el $78%$ del vocabulario.
La pendiente ajustada es $-0.62$, lejos del $-1$ teórico, y la gráfica explica por qué: la cola de palabras únicas forma una larga meseta horizontal en frecuencia $1$ que aplana la recta. Con $238$ palabras no hay texto suficiente para que la ley se manifieste con limpieza; con un libro entero, la nube de puntos se pegaría mucho más a la recta naranja. Aun así, la forma general ya está ahí: unas pocas palabras muy frecuentes arriba a la izquierda y una cola larga abajo a la derecha.
¿Por qué importa esto para la IA generativa? Porque determina cómo trocear el texto. Si cada palabra completa es un símbolo, el vocabulario crece sin límite y la mayoría de los símbolos casi no tiene ejemplos de los que aprender (recuerde: el $98.7%$ de la matriz de transición estaba vacío). Si cada carácter es un símbolo, el vocabulario es pequeño pero las secuencias se vuelven larguísimas. La solución que usan los modelos actuales está en medio: los tokens de subpalabra, fragmentos frecuentes que se combinan para formar palabras raras. Ese es el tema del Día 2.
Breve historia de la IA generativa
El modelo de bigramas que acaba de construir es casi tan viejo como la teoría de la información: Claude Shannon ya generaba texto con cadenas de Markov sobre letras y palabras en 1948. Durante décadas, los modelos de n-gramas (bigramas, trigramas y vecinos) fueron la base del reconocimiento de voz y de la traducción automática. Lo que cambió en la última década fue la llegada de las redes neuronales profundas como modelos generativos, como se muestra en la Tabla 3.
Tabla 3. Hitos de la IA generativa entre 2013 y 2023.
| Año | Hito | Modalidad | Idea clave |
|---|---|---|---|
| 2013 | VAE (autocodificador variacional) | imagen | Comprimir los datos en un espacio latente continuo del que se puede muestrear |
| 2014 | GAN (redes generativas antagónicas) | imagen | Un generador y un discriminador compiten hasta que las imágenes falsas parecen reales |
| 2016 | WaveNet | audio | Generar sonido muestra a muestra, con una red que predice el siguiente valor de la onda |
| 2017 | Transformer | texto | Atención sobre toda la secuencia en lugar de leer palabra por palabra |
| 2020 | GPT-3 | texto | Un transformador de 175 mil millones de parámetros que aprende tareas a partir de unos pocos ejemplos en la instrucción |
| 2020 | DDPM (modelos de difusión) | imagen | Aprender a quitar ruido paso a paso, partiendo de ruido puro |
| 2021 | CLIP | multimodal | Unir texto e imagen en un mismo espacio de representación |
| 2021 | Codex | código | Un modelo de lenguaje especializado en generar programas |
| 2022 | Difusión latente | imagen | Hacer la difusión en un espacio comprimido para que quepa en una tarjeta gráfica doméstica |
| 2023 en adelante | Asistentes multimodales | multimodal | Modelos conversacionales que leen y producen texto, imágenes, audio y código |
WaveNet y Codex no son hitos tan citados como los demás, pero se incluyen porque representan las modalidades de audio y código que la serie trabaja más adelante. En la tabla puede ver tres familias de ideas que se cruzan. La primera es la de los modelos autorregresivos, que generan un elemento a la vez a partir de los anteriores: el modelo de bigramas, WaveNet, GPT-3 y los asistentes de texto pertenecen a ella. La segunda es la de los modelos de variable latente (VAE y GAN), que generan a partir de un vector aleatorio comprimido. La tercera es la de la difusión, que parte de ruido puro y lo va limpiando; es la que domina hoy la generación de imágenes y la que estudiará en el Día 9.
Puede dibujar la línea de tiempo de estos hitos, coloreada por modalidad, con los parches de matplotlib usando el siguiente código:
# Línea de tiempo de la IA generativa con matplotlib.patches en Python:
from matplotlib.patches import FancyBboxPatch
from matplotlib.lines import Line2D

hitos = pd.DataFrame([
    (2013.0, 'VAE', 'imagen'),
    (2014.4, 'GAN', 'imagen'),
    (2016.7, 'WaveNet', 'audio'),
    (2017.5, 'Transformer', 'texto'),
    (2020.2, 'GPT-3', 'texto'),
    (2020.9, 'DDPM', 'imagen'),
    (2021.1, 'CLIP', 'multimodal'),
    (2021.6, 'Codex', 'código'),
    (2022.3, 'Difusión latente', 'imagen'),
    (2023.5, 'Asistentes multimodales', 'multimodal'),
], columns = ['anio', 'hito', 'modalidad'])
colores = {'imagen': '#2a78d6', 'texto': '#eb6834', 'audio': '#1baf7a',
           'código': '#6250d6', 'multimodal': '#e34948'}
print(hitos.groupby('modalidad').size().sort_values(ascending = False).to_string())

fig, ax = plt.subplots(figsize = (14, 5))
ax.plot([2012.5, 2025.5], [0, 0], color = '#52514e', linewidth = 2)
for anio in range(2013, 2026):
    ax.plot([anio, anio], [-0.08, 0.08], color = '#52514e', linewidth = 1)
    ax.text(anio, -0.25, str(anio), ha = 'center', va = 'top', fontsize = 10)
for i, fila in hitos.iterrows():
    altura = [1.0, 1.9][i % 2] * (1 if i % 4 < 2 else -1)
    ax.plot([fila['anio'], fila['anio']], [0, altura], color = colores[fila['modalidad']], linewidth = 1.5)
    ancho = 0.11 * len(fila['hito']) + 0.3
    caja = FancyBboxPatch((fila['anio'] - ancho / 2, altura - 0.2), ancho, 0.4,
                          boxstyle = 'round,pad=0.05', facecolor = colores[fila['modalidad']],
                          edgecolor = 'white', linewidth = 2)
    ax.add_patch(caja)
    ax.text(fila['anio'], altura, fila['hito'], ha = 'center', va = 'center', color = 'white', fontsize = 10, fontweight = 'bold')
leyenda = [Line2D([0], [0], marker = 's', color = 'w', markerfacecolor = c, markersize = 12, label = m) for m, c in colores.items()]
ax.legend(handles = leyenda, loc = 'lower right', ncol = 5, frameon = False)
ax.set_xlim(2011.8, 2026)
ax.set_ylim(-2.9, 2.5)
ax.axis('off')
ax.set_title('Hitos de la IA generativa, 2013 a 2025', fontsize = 16)
plt.tight_layout()

# Hitos coloreados por modalidad:
plt.show()
modalidad
imagen        4
texto         2
multimodal    2
audio         1
código        1
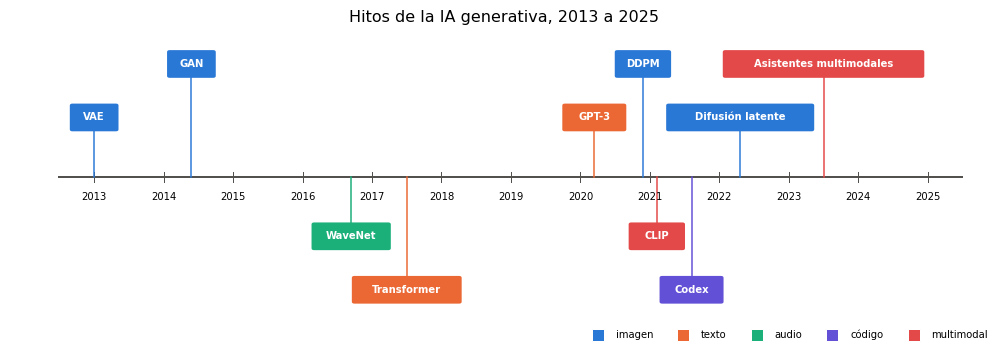
La línea de tiempo deja ver un patrón que la tabla esconde: entre 2013 y 2017 los hitos están separados por años, y a partir de 2020 se amontonan. Cuatro de los diez hitos son de imagen, la modalidad que más avanzó primero, pero la década termina en el color de lo multimodal: CLIP en 2021 y los asistentes desde 2023 ya no trabajan con una sola clase de datos. La posición de cada caja dentro de su año es aproximada; lo que importa es el orden y la aceleración.
Hay una idea que atraviesa toda la línea y que conviene subrayar: el modelo de bigramas de esta entrada y un asistente de 2025 comparten el mismo principio, predecir el siguiente elemento a partir de los anteriores. Lo que cambió es cuánto contexto miran, cómo representan cada elemento y cuántos datos y parámetros usan.
Modalidades: texto, imagen, audio y código
Las cuatro modalidades de la línea de tiempo son también las cuatro que el Cuaderno Vivo va a usar. Cada una tiene sus herramientas y su día dentro de la serie, como se resume en la Tabla 4.
Tabla 4. Modalidades de la IA generativa, herramienta de ejemplo y días de la serie en que se trabajan.
| Modalidad | Qué genera | Herramienta de ejemplo | Días de la serie |
|---|---|---|---|
| Texto | Resúmenes, preguntas de repaso, clasificaciones | Claude (Haiku 5.5, Sonnet 5.5, Fable 5.1) | 1 a 8, 17 a 24 |
| Imagen | Portadas semanales con una guía de estilo | FLUX.1 schnell, SDXL, Stability AI | 9 a 12 |
| Audio | Narración del resumen semanal con la voz propia | librosa, Coqui TTS (XTTS-v2), ElevenLabs | 13 a 16 |
| Código | Funciones de apoyo y orquestación del asistente | Claude como asistente de programación | 4, 21 a 23 |
La columna de herramientas mezcla dos tipos de recursos que el Día 4 compara con detalle: modelos abiertos que se ejecutan en su propio equipo (FLUX.1 schnell, Coqui TTS) y servicios en la nube que se pagan por uso (Claude, Stability AI, ElevenLabs). La elección entre ambos depende de la privacidad, del coste y del hardware disponible, y es exactamente el tipo de decisión que el presupuesto de Sofía obliga a tomar con cuidado.
Primera conversación con Claude
Ha construido un modelo generativo a mano. Ahora toca hablar con uno de verdad. Claude es la familia de modelos de lenguaje de Anthropic, y se usa desde Python con el paquete oficial anthropic. Necesita tres cosas:
- Instalar el paquete con
pip install anthropic. - Obtener una clave de API en la consola de Anthropic y guardarla en la variable de entorno
ANTHROPIC_API_KEY. En Windows:setx ANTHROPIC_API_KEY "su-clave"(y abrir una terminal nueva); en Linux o macOS:export ANTHROPIC_API_KEY="su-clave". - Elegir un modelo. Para una frase corta basta el más rápido y barato de la familia, Claude Haiku 5.5.
Antes de llamar, conviene entender qué se paga. Los modelos de lenguaje no leen palabras sino tokens, fragmentos de texto como los que verá en el Día 2. Una palabra común en español suele ocupar uno o dos tokens. Cada llamada cobra por separado los tokens de entrada (lo que usted envía) y los de salida (lo que el modelo escribe), con los precios por millón de tokens de la Tabla 5.
Tabla 5. Modelos de Claude usados en la serie (precios por millón de tokens, octubre de 2026).
| Modelo | ID | Papel en la serie | Entrada USD | Salida USD |
|---|---|---|---|---|
| Claude Fable 5.1 | claude-fable-5-1 | El más capaz: arquitectura, crítica final, tareas difíciles | 10.00 | 50.00 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | Equilibrado: tutor, generación de instrucciones, orquestación | 2.00 | 10.00 |
| Claude Haiku 5.5 | claude-haiku-5-5 | Rápido y barato: clasificación, evaluación, resúmenes cortos | 0.10 | 0.50 |
El coste de una llamada se obtiene multiplicando cada tipo de token por su precio:
$$ \text{coste} = n_{\text{entrada}} \cdot \frac{p_{\text{entrada}}}{10^{6}} + n_{\text{salida}} \cdot \frac{p_{\text{salida}}}{10^{6}} $$
La lógica detrás de esta fórmula es múltiple:
- La primera parte cobra lo que usted envía: la instrucción, el contexto y, en conversaciones largas, todo el historial anterior, que se reenvía en cada llamada.
- La segunda parte cobra lo que el modelo escribe, normalmente cinco veces más caro por token que la entrada. Si el modelo razona internamente antes de responder, esos tokens también se cuentan como salida.
- En conclusión, el coste lo controlan dos palancas: cuánto texto se envía y cuánto se deja escribir al modelo.
Con unos $30$ tokens de entrada y $40$ de salida en Haiku 5.5, la cuenta es $30 \cdot 0.10/10^{6} + 40 \cdot 0.50/10^{6} = 0.000023$ USD, es decir, unos dos milésimos de centavo de dólar.
Puede hacer su primera llamada a Claude, comprobar que no fue rechazada y leer su consumo de tokens usando el siguiente código. Este bloque necesita conexión y una clave válida, por lo que no se ejecutó al preparar la entrada; la salida que se muestra es un ejemplo:
# Primera llamada a Claude Haiku 5.5 desde Python:
import anthropic

client = anthropic.Anthropic()  # Lee ANTHROPIC_API_KEY del entorno.

respuesta = client.messages.create(
    model = 'claude-haiku-5-5',
    max_tokens = 1024,
    output_config = {'effort': 'low'},
    messages = [{'role': 'user',
                 'content': 'Escribe una frase motivadora, en español y de una línea, para la portada de mi cuaderno de estudio.'}]
)

# Comprobar el motivo de parada antes de leer el texto:
if respuesta.stop_reason == 'refusal':
    print('El modelo rechazó la petición.')
else:
    print(''.join(bloque.text for bloque in respuesta.content if bloque.type == 'text'))

# Consumo de tokens y coste con los precios de la Tabla 5:
entrada = respuesta.usage.input_tokens
salida = respuesta.usage.output_tokens
coste_usd = entrada * 0.10 / 1e6 + salida * 0.50 / 1e6
print('Tokens de entrada:', entrada, '| tokens de salida:', salida)
print(f'Coste: {coste_usd:.6f} USD')

# Salida de ejemplo (puede variar):
# Cada nota que escribe hoy es una pieza del conocimiento que tendrá mañana.
# Tokens de entrada: 30 | tokens de salida: 40
# Coste: 0.000023 USD
La salida de ejemplo coincide con el cálculo anterior: $0.000023$ USD por una frase. Cuando usted lo ejecute, la frase será otra (recuerde que el modelo muestrea) y los tokens pueden variar unas decenas arriba o abajo. Vale la pena detenerse en cada parámetro de la llamada:
modelelige el modelo por su identificador exacto, el de la columna ID de la Tabla 5.max_tokenses un tope de seguridad para la salida, no un objetivo: el modelo se detiene antes si termina. Un valor de $1024$ deja margen para que la respuesta no quede cortada; si se alcanza,stop_reasonvale'max_tokens'.output_config = {'effort': 'low'}le pide al modelo que dedique poco esfuerzo a razonar, adecuado para una tarea trivial y más barato. Los niveles disponibles dependen del modelo;'low','medium'y'high'son los habituales.messageses la conversación: una lista de turnos conroleycontent. La API no guarda memoria entre llamadas; para conversar, se reenvía el historial completo (el Día 7 trata este problema).stop_reasondice por qué paró el modelo. Comprobarlo antes de leer el texto evita tratar un rechazo como si fuera una respuesta.
Es posible que en otros tutoriales vea un parámetro temperature para controlar la creatividad del modelo. Los modelos de Claude usados en esta serie no aceptan ese parámetro con valores distintos del predeterminado (devuelven un error 400), así que la temperatura se estudiará offline, con numpy, en el Día 3, y en la API el control se hace con effort.
Atención aquí: Todo el texto que envía a una API sale de su equipo y se procesa en servidores de terceros. Antes de mandar notas personales, diarios o datos de otras personas, revise qué datos comparte y bajo qué condiciones (el Día 19 construye un filtro de datos personales para el Cuaderno Vivo). Y nunca escriba la clave de API dentro del código ni la suba a un repositorio: léala siempre de una variable de entorno, como hace anthropic.Anthropic() por defecto.
El Cuaderno Vivo: alcance y presupuesto
Con un generador de juguete y una llamada real funcionando, Sofía puede escribir los requisitos de su proyecto. Los agrupa en tres verbos:
- Estudiar: resumir cada nota, clasificarla por tema, recordar lo que ya estudió y hacerle preguntas de repaso (módulo 2).
- Crear: proponer una portada semanal coherente con su estilo de dibujo, sin imitar a artistas vivos ni representar personas reales (módulo 3).
- Escuchar: narrar el resumen de la semana con su propia voz, grabada por ella y con su consentimiento por escrito (módulo 4).
Y una restricción que lo condiciona todo: 10 USD al mes. Para saber si cabe, Sofía estima su uso: unas $20$ consultas al día, $30$ días al mes, con unos $1,200$ tokens de entrada (la nota, el historial y las instrucciones) y $400$ de salida por consulta. Aplicando la fórmula del coste a cada modelo:
$$ \text{coste mensual} = 20 \cdot 30 \cdot \left(1,200 \cdot \frac{p_{\text{entrada}}}{10^{6}} + 400 \cdot \frac{p_{\text{salida}}}{10^{6}}\right) $$
Puede calcular el coste de la primera llamada y el coste mensual del Cuaderno Vivo con cada modelo usando el siguiente código:
# Coste de la primera llamada y del uso mensual del Cuaderno Vivo en Python:
precios = pd.DataFrame({
    'modelo': ['claude-haiku-5-5', 'claude-sonnet-5-5', 'claude-fable-5-1'],
    'entrada_usd': [0.10, 2.00, 10.00],
    'salida_usd': [0.50, 10.00, 50.00]
})

def coste(tokens_entrada, tokens_salida, fila):
    return tokens_entrada * fila['entrada_usd'] / 1e6 + tokens_salida * fila['salida_usd'] / 1e6

consultas_mes = 20 * 30
precios['llamada_usd'] = precios.apply(lambda f: coste(30, 40, f), axis = 1)
precios['mes_usd'] = precios.apply(lambda f: consultas_mes * coste(1200, 400, f), axis = 1)
precios['cabe_en_10_usd'] = precios['mes_usd'] <= 10
pd.set_option('display.float_format', lambda x: f'{x:.6f}')
print(precios[['modelo', 'llamada_usd', 'mes_usd', 'cabe_en_10_usd']].to_string(index = False))
           modelo  llamada_usd   mes_usd  cabe_en_10_usd
 claude-haiku-5-5     0.000023  0.192000            True
claude-sonnet-5-5     0.000460  3.840000            True
 claude-fable-5-1     0.002300 19.200000           False
Los números responden a la primera pregunta de Diego. Con Haiku 5.5, las $600$ consultas mensuales cuestan $0.19$ USD; con Sonnet 5.5, $3.84$ USD, todavía dentro del presupuesto; con Fable 5.1, $19.20$ USD, casi el doble de lo que Sofía puede gastar. Entre el modelo más barato y el más caro hay un factor de $100$.
La conclusión práctica no es “use siempre el más barato”, sino asigne cada tarea al modelo más pequeño que la resuelva bien: Haiku para clasificar notas y resumir en una línea, Sonnet para el tutor que conversa, y Fable solo para las pocas tareas difíciles del mes, como revisar la arquitectura final. El Día 4 convierte esta tabla en un presupuesto completo, el Día 8 añade la caché de instrucciones y el Día 23 añade un registro de consumo real.
Diego, que no se conforma con un promedio, hizo dos preguntas más. La primera: ¿Qué pasa si un día Sofía hace 200 consultas en lugar de 20? Con Sonnet, ese día costaría $1.28$ USD, un tercio de lo que antes se gastaba en un mes; un presupuesto serio necesita un tope diario, no solo una media. La segunda: ¿Las frases que escribe el modelo son de Sofía? No del todo. El Cuaderno Vivo las etiquetará como generadas con IA desde el primer día, y la serie vuelve a esa cuestión cuando trate la autoría.
Consideraciones finales
Puede parecer extraño empezar una serie sobre IA generativa con un modelo que cabe en un Counter de Python y que produce frases como “la luz al aire libre con pocas líneas”. Pero ese modelo diminuto contiene, a escala de juguete, casi todas las ideas que hacen funcionar a un asistente moderno:
- Generar es muestrear de una distribución aprendida: el bigrama lanza un dado cargado con conteos; un modelo grande lanza un dado cargado con miles de millones de parámetros.
- El contexto lo es todo: una palabra de memoria basta para la gramática local, pero no para la coherencia. Los modelos actuales miran cientos de miles de tokens hacia atrás.
- Recordar no es generalizar: la perplejidad de la nota vista cae a $4.1$ con poco suavizado, mientras que la de la frase nueva empeora. El equilibrio entre memorizar y generalizar es el mismo que en cualquier modelo de aprendizaje automático.
- El texto tiene una cola larga: con solo $238$ palabras, el $78%$ del vocabulario apareció una sola vez. Representar bien lo raro es el problema que resuelven los tokens del Día 2.
Antes de confiar en cualquier modelo generativo, grande o pequeño, conviene hacerse unas preguntas de control:
- ¿Con qué datos aprendió el modelo, y qué temas o voces faltaban en ellos?
- ¿Cómo se midió su calidad: con los mismos datos de entrenamiento o con datos nuevos?
- ¿Cuánto cuesta cada respuesta y quién ve los datos que se le envían?
Un gran libro que trata todo esto con rigor y sin perder la intuición es Generative Deep Learning de David Foster (2.ª edición, 2023), que recorre VAE, GAN, modelos autorregresivos, difusión y modelos multimodales con código en cada capítulo. Para el lado clásico del lenguaje, el capítulo “N-gram Language Models” de Speech and Language Processing, de Dan Jurafsky y James H. Martin, explica los bigramas, el suavizado y la perplejidad con la misma notación de esta entrada y está disponible en línea de forma gratuita.
Un modelo de bigramas y un gran modelo de lenguaje hacen lo mismo, predecir lo siguiente; lo que los separa es la escala, no la idea. Si usted entiende por qué la frase 5 terminó en “resume un”, entiende también por qué un asistente a veces se queda a medias cuando alcanza su max_tokens, y por qué a veces inventa con total seguridad algo que nunca leyó.
Conclusiones clave
Generar y clasificar
- Un modelo discriminativo estima $p(y \mid x)$ y solo aprende la frontera entre clases; uno generativo aprende $p(x)$ y puede producir ejemplos nuevos.
- Generar es muestrear de una distribución; la semilla (
2026en esta serie) hace que el muestreo sea reproducible. - La IA generativa abarca texto, imagen, audio y código, y desde 2021 avanza hacia modelos multimodales.
Bigramas y perplejidad
- El modelo de bigramas estima $P(w_t \mid w_{t-1})$ contando pares de palabras; con $238$ palabras produce $221$ bigramas distintos y una matriz vacía en un $98.7%$.
- Las frases muestreadas son localmente plausibles pero globalmente incoherentes, porque el modelo solo recuerda una palabra.
- La perplejidad mide el número efectivo de opciones por paso; el suavizado de Laplace evita los ceros, y su intensidad $\alpha$ se elige con texto nuevo, nunca con el de entrenamiento.
- La ley de Zipf explica la cola larga del vocabulario: $102$ de $130$ palabras aparecieron una sola vez.
El proyecto
- El Cuaderno Vivo es un asistente de estudio y diario creativo que Sofía construye en 24 días con 10 USD al mes.
- Una llamada corta a Claude Haiku 5.5 cuesta unos $0.000023$ USD; el uso mensual estimado cuesta $0.19$ USD con Haiku, $3.84$ USD con Sonnet y $19.20$ USD con Fable.
- Todo texto enviado a una API sale del equipo, la clave se guarda en una variable de entorno y las frases generadas no son de Sofía.
Mañana, en el Día 2: Tokens, embeddings y la ventana de contexto. Verá por qué los modelos no leen palabras sino fragmentos, construirá un tokenizador propio a partir de las mismas 12 notas y convertirá cada nota en un vector para medir cuánto se parecen entre sí.
Referencias
- Jurafsky, D. y Martin, J. H. (2025). Speech and Language Processing (3.ª ed., borrador en línea), capítulo “N-gram Language Models”. https://web.stanford.edu/~jurafsky/slp3/
- Foster, D. (2023). Generative Deep Learning (2.ª ed.). O’Reilly Media.
- Goodfellow, I. et al. (2014). Generative Adversarial Nets. Advances in Neural Information Processing Systems 27.
- Kingma, D. P. y Welling, M. (2013). Auto-Encoding Variational Bayes. arXiv:1312.6114.
- van den Oord, A. et al. (2016). WaveNet: A Generative Model for Raw Audio. arXiv:1609.03499.
- Vaswani, A. et al. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30.
- Brown, T. et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33.
- Ho, J., Jain, A. y Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. Advances in Neural Information Processing Systems 33.
- Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. Proceedings of the 38th International Conference on Machine Learning.
- Chen, M. et al. (2021). Evaluating Large Language Models Trained on Code. arXiv:2107.03374.
- Rombach, R. et al. (2022). High-Resolution Image Synthesis with Latent Diffusion Models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition.
- Zipf, G. K. (1949). Human Behavior and the Principle of Least Effort. Addison-Wesley.
- Shannon, C. E. (1948). A Mathematical Theory of Communication. Bell System Technical Journal, 27(3), 379 a 423.