IA generativa en proyectos personales: Día 11
 Jeshua Romero Guadarrama
- 48 Min para leer
- 11 Jan, 2026
Índice de contenido
Resumen:
Elegir una herramienta para generar imágenes no se reduce a mirar cuál produce la imagen más bonita: también cuentan la licencia, el coste, el hardware y la velocidad. En esta entrada se comparan SDXL base 1.0, FLUX.1 schnell, FLUX.1 dev y la API Stable Image Core con el mismo prompt y la misma semilla, se calculan a mano CLIPScore y FID para entender qué miden y qué no, y se diseña una evaluación humana ciega con tres jueces. Al terminar, usted sabrá leer una licencia de modelo, medir el acuerdo entre jueces con la correlación de Spearman, usar Claude con visión como crítico auxiliar y decidir con una matriz ponderada.
¿Cómo citar el presente artículo?
Romero, J. (11 de enero de 2026). IA generativa en proyectos personales: Día 11. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_11/.
IA generativa en proyectos personales: Día 11 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_11/.
Modelos, precios y regulación revisados en octubre de 2026. Los nombres de los modelos, sus licencias y el precio de Stable Image Core citados en esta entrada se revisaron en octubre de 2026; confírmelos en las fichas oficiales antes de tomar una decisión.
Día 11. Comparativa de herramientas text-to-image: local, abierta y en la nube
Introducción
Ayer, en el Día 10, aprendió a escribir prompts visuales con estructura (sujeto, acción, entorno, composición, luz, paleta, medio y estilo) y a controlar la semilla, los pasos y la escala de guía, y el Cuaderno Vivo ganó el prompt de la portada “Semana de estadística”. Ese prompt ya está listo, pero todavía falta decidir con qué herramienta convertirlo en una imagen.
La decisión no es trivial. Sofía tiene una laptop con una tarjeta gráfica modesta, un presupuesto de 10 USD al mes para todo el proyecto y la intención de publicar sus portadas en su portafolio. En internet encuentra modelos abiertos que se ejecutan en su propio equipo, modelos con pesos descargables pero con licencia no comercial y servicios en la nube que cobran por imagen. Cada foro asegura que su opción favorita es “la mejor”. Diego, fiel a su papel, le hace dos preguntas antes de que descargue nada: ¿Mejor según quién? y ¿Puede usted publicar legalmente lo que genere?
En la presente entrada, descubrirá cómo comparar cuatro herramientas text-to-image (texto a imagen) con criterios explícitos: calidad, velocidad, coste, hardware y licencia. Verá el código para generar la misma portada con SDXL base 1.0, FLUX.1 schnell, FLUX.1 dev y la API Stable Image Core de Stability AI, con la misma semilla y el mismo prompt. Calculará con datos de juguete las dos métricas automáticas más citadas, CLIPScore y FID, para entender su lógica y sus límites, y diseñará una evaluación humana ciega pequeña con tres jueces, cuyo acuerdo medirá con la correlación de Spearman. Por último, usará Claude con visión como crítico auxiliar y combinará todo en una matriz de decisión ponderada. El Cuaderno Vivo gana hoy una decisión documentada: qué herramienta genera sus portadas y cuál queda de respaldo.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Comparar SDXL, FLUX.1 schnell, FLUX.1 dev y una API en la nube (Stability Stable Image Core) por calidad, velocidad, coste, hardware y licencia.
- Leer una licencia de modelo y decidir si permite el uso previsto.
- Conocer las métricas automáticas (CLIPScore, FID) y sus límites, y diseñar una evaluación humana ciega pequeña.
- Usar Claude con visión como crítico auxiliar, sin sustituir el juicio humano.
Las candidatas
Sofía reduce el universo de herramientas a cuatro candidatas que cubren los tres modos de trabajo posibles: un modelo local y abierto con un ecosistema maduro, dos modelos locales con pesos descargables de la misma familia pero con licencias opuestas, y un servicio en la nube que no exige GPU. La Tabla 1 resume la ficha de cada una. Los tiempos y la memoria de video (VRAM) son órdenes de magnitud: dependen de la tarjeta, de la versión de diffusers, de la precisión numérica y de si se descarga parte del modelo a la memoria del sistema, así que verifíquelos en su propio equipo.
Tabla 1. Fichas de las cuatro herramientas (revisado en octubre de 2026; tiempos y VRAM como órdenes de magnitud).
| Herramienta | Tipo | Pasos típicos | Escala de guía | Licencia | Requiere GPU | Coste aproximado | Notas |
|---|---|---|---|---|---|---|---|
| SDXL base 1.0 | Local, pesos abiertos | 25 a 40 | 5 a 8 | CreativeML Open RAIL++-M | Sí, unos 8 GB en fp16 | Electricidad | U-Net de 2 600 millones de parámetros; ecosistema enorme |
| FLUX.1 schnell | Local, pesos abiertos | 1 a 4 | 0.0 | Apache 2.0 | Sí, unos 12 GB con descarga a CPU | Electricidad | 12 000 millones de parámetros; destilado para pocos pasos |
| FLUX.1 dev | Local, pesos abiertos | unos 50 | 3.5 | FLUX.1 [dev] Non-Commercial License | Sí, unos 12 GB con descarga a CPU | Electricidad | Misma arquitectura; más calidad, más lento |
| Stable Image Core | API en la nube | No se expone | No se expone | Condiciones de servicio de Stability AI | No | 3 créditos (0.03 USD) por imagen | Pago por imagen; sin instalación |
Veamos cada candidata con un poco más de detalle.
SDXL base 1.0
SDXL (o “Stable Diffusion XL”) es el modelo de difusión latente que Stability AI publicó en julio de 2023 y que Podell y coautores describen en su artículo de ese año. Respecto de las versiones anteriores de Stable Diffusion, triplica el tamaño de la U-Net (hasta unos $2,600$ millones de parámetros), usa dos codificadores de texto en lugar de uno y genera de forma nativa a $1024 \times 1024$ píxeles. Es el mecanismo que vio en el Día 9: una red que, paso a paso, quita ruido de una representación latente guiada por el texto.
Su mayor ventaja es la madurez. Tras más de dos años en circulación, existen miles de adaptaciones finas, controladores de composición, guías y respuestas a casi cualquier error de instalación. Funciona en tarjetas de consumo con unos $8$ GB de VRAM en media precisión (fp16), y con la descarga a CPU baja todavía más. Su debilidad, comparado con modelos más recientes, es la fidelidad al prompt: tiende a olvidar detalles de prompts largos y a dibujar mal las manos y el texto.
La licencia es la CreativeML Open RAIL++-M, de la familia RAIL (“Responsible AI License”). Permite el uso comercial, pero incluye un anexo de restricciones de uso (por ejemplo, prohíbe usar el modelo para desinformar, discriminar o dañar a menores) que usted debe respetar y transmitir a quien le redistribuya el modelo o un derivado. Sobre las imágenes generadas, el licenciante no reclama derechos, aunque usted responde del uso que les dé.
FLUX.1 schnell
FLUX.1 es la familia de modelos de Black Forest Labs, un laboratorio fundado por varios de los autores originales de Stable Diffusion. Sus modelos son transformadores de flujo rectificado (“rectified flow transformers”) de $12,000$ millones de parámetros, es decir, unas cinco veces más grandes que la U-Net de SDXL. La versión schnell (“rápido” en alemán) está destilada: se entrenó para imitar en muy pocos pasos lo que el modelo grande hace en muchos, de modo que genera una imagen aceptable en $1$ a $4$ pasos.
La destilación cambia la forma de usarlo. Según su ficha en Hugging Face, schnell se llama con guidance_scale=0.0, num_inference_steps=4 y max_sequence_length=256. El cero en la escala de guía no es un descuido: la guía sin clasificador que estudió ayer ya quedó “incorporada” en el modelo durante la destilación, así que no hay dos predicciones que combinar en cada paso. Por la misma razón, el prompt negativo no tiene efecto en la llamada estándar.
Su licencia es Apache 2.0, una licencia permisiva de software: permite el uso comercial, la modificación y la redistribución, con la única obligación práctica de conservar el aviso de licencia al redistribuir los pesos. Para un proyecto personal que podría acabar en un portafolio público, es la licencia más sencilla de las cuatro.
FLUX.1 dev
FLUX.1 dev comparte la arquitectura de schnell, pero no está destilado para pocos pasos: su ficha recomienda guidance_scale=3.5 y unos $50$ pasos, con max_sequence_length=512. El resultado suele tener más detalle, mejor fidelidad al prompt y texto más legible dentro de la imagen, a cambio de tardar del orden de diez veces más que schnell por imagen.
La diferencia que más importa es la licencia: la FLUX.1 [dev] Non-Commercial License (versión 1.1.1 al momento de la revisión). El modelo solo puede usarse con fines no comerciales: investigación personal, aficiones o pruebas que no lleguen a producción. Curiosamente, la licencia permite usar las salidas con fines comerciales, salvo para entrenar un modelo que compita con FLUX.1, y exige filtrar contenido ilícito y declarar el origen artificial cuando la ley lo pida. Es decir, una imagen generada con dev puede venderse, pero el servicio que la genera no puede ser un negocio sin una licencia comercial de Black Forest Labs.
Atención aquí: “Pesos descargables” no significa “uso libre”. FLUX.1 dev se descarga igual que schnell desde Hugging Face, pero su licencia prohíbe el uso comercial del modelo. Si el Cuaderno Vivo se convirtiera algún día en un producto con usuarios de pago, las portadas generadas con dev obligarían a negociar una licencia o a cambiar de modelo. Lea la licencia antes de que el proyecto dependa del modelo, no después.
Stability Stable Image Core (API)
La cuarta candidata no se instala: es un servicio web. Stable Image Core es el punto de entrada económico de la API de Stability AI. Usted envía un formulario con el prompt y algunos parámetros a https://api.stability.ai/v2beta/stable-image/generate/core y recibe la imagen en la respuesta. No hay que elegir pasos ni escala de guía: el servicio decide el modelo interno y su configuración, y eso es a la vez su ventaja (cero ajustes) y su límite (cero control fino).
El coste es de 3 créditos por imagen, y cada crédito vale $0.01$ USD, de modo que una imagen cuesta $0.03$ USD (según la página de precios de la plataforma de Stability, revisado en octubre de 2026; la tarifa cambia con frecuencia). Con el presupuesto de Sofía, $10$ USD alcanzarían para unas $333$ imágenes al mes, pero ese presupuesto también paga a Claude, así que la API solo tiene sentido como complemento.
Las condiciones de servicio de Stability AI incorporan una Política de Uso Aceptable que prohíbe, entre otras cosas, generar contenido ilegal, suplantar a personas reales o usar el servicio para entrenar modelos competidores. Sobre la propiedad de las salidas, las condiciones de servicio de 2025 establecen que, entre Stability y usted, la salida es suya en la medida en que lo permita la ley, y que Stability le cede los derechos que tenga sobre ella mientras se cumplan los términos.
Leer una licencia
Una licencia de modelo es un contrato, y como todo contrato se lee mejor con preguntas concretas que de corrido. Sofía usa cuatro preguntas, que puede aplicar a cualquier modelo que encuentre en el futuro:
- ¿Permite el uso comercial del modelo? Es decir, ¿puede usarlo dentro de algo que genere ingresos?
- ¿Exige atribución o copia de la licencia? ¿Qué debe incluir si redistribuye los pesos o un derivado?
- ¿Impone restricciones de uso? ¿Hay una lista de usos prohibidos, aunque el uso comercial esté permitido?
- ¿Quién es dueño de las salidas? ¿Reclama el licenciante algún derecho sobre las imágenes, o pone condiciones a su uso?
La Tabla 2 aplica las cuatro preguntas a las candidatas y añade una quinta fila con la que importa de verdad: si la licencia cubre el uso concreto de Sofía, que es generar portadas para un proyecto personal sin ingresos que se mostrará en su portafolio.
Tabla 2. Lista de verificación de licencias para cada herramienta (revisado en octubre de 2026; no es asesoría legal).
| Pregunta | SDXL base 1.0 | FLUX.1 schnell | FLUX.1 dev | Stable Image Core |
|---|---|---|---|---|
| ¿Uso comercial del modelo? | Sí, con restricciones de uso | Sí | No, requiere licencia comercial de Black Forest Labs | Sí, según las condiciones del servicio |
| ¿Atribución o copia de la licencia? | Copia de la licencia y restricciones transmitidas al redistribuir | Aviso de licencia Apache 2.0 al redistribuir | Copia de la licencia y aviso de atribución al redistribuir | No aplica: no se redistribuye el modelo |
| ¿Restricciones de uso? | Sí, anexo de usos prohibidos | No en la licencia; sí las leyes aplicables | Sí: militar, vigilancia, biometría, contenido ilícito y más | Sí, Política de Uso Aceptable |
| ¿Propiedad de las salidas? | El licenciante no reclama derechos | La licencia no reclama derechos sobre las salidas | El licenciante no las reclama; uso comercial permitido salvo entrenar modelos competidores | Stability cede los derechos que tenga mientras se cumplan los términos |
| ¿Cubre el uso de Sofía? | Sí | Sí | Sí mientras el proyecto no tenga fines comerciales | Sí |
Tres lecciones salen de la tabla. La primera: “abierto” es un espectro, no un sí o un no. Apache 2.0 está en un extremo, la licencia no comercial de dev en el otro, y la familia RAIL en medio, con libertad comercial pero con usos prohibidos. La segunda: el modelo y sus salidas pueden tener reglas distintas, como en FLUX.1 dev. La tercera: una licencia permisiva del modelo no le exime de las leyes sobre lo que usted genera, por ejemplo derechos de imagen de personas reales o marcas registradas; por eso la serie no usa nunca personas reales, marcas ni el estilo de artistas vivos nombrados en sus prompts.
Diego hace notar un punto que las licencias no resuelven: los datos de entrenamiento. Ninguna de las cuatro licencias garantiza que las imágenes con las que se entrenó el modelo se usaran con permiso de sus autores, y es un debate jurídico abierto en varios países. Para un proyecto personal, la respuesta prudente es no imitar a artistas concretos y declarar siempre que la imagen está generada con IA, como exige la regla ética de la serie.
Código para cada herramienta
Para que la comparación sea justa, las cuatro herramientas reciben el mismo prompt y la misma semilla. Comencemos por preparar el entorno con las importaciones base, la semilla global de la serie, $2026$, y el prompt de la portada “Semana de estadística” que se construyó ayer. El prompt está en inglés porque los codificadores de texto de los cuatro modelos se entrenaron sobre todo con descripciones en ese idioma:
# Importaciones base, semilla del día y prompt común en Python:
import warnings
warnings.filterwarnings('ignore')
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import scipy

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
SEMILLA = 2026
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 10)

# Prompt de la portada "Semana de estadística" (Día 10), igual para las cuatro herramientas:
PROMPT = ('flat illustration, open notebook with hand-drawn bar charts on a wooden desk, '
          'small potted plant, soft morning light from the left, teal and ochre palette, '
          'centered composition with empty space at the top for a title')
NEGATIVO = 'text, letters, watermark, logo, blurry, extra fingers'
HERRAMIENTAS = ['SDXL base 1.0', 'FLUX.1 schnell', 'FLUX.1 dev', 'Stable Image Core']
COLORES = {'SDXL base 1.0': '#2a78d6', 'FLUX.1 schnell': '#eb6834',
           'FLUX.1 dev': '#1baf7a', 'Stable Image Core': '#eda100'}
print('numpy', np.__version__, '| pandas', pd.__version__, '| scipy', scipy.__version__)
print('Palabras del prompt:', len(PROMPT.replace(',', ' ').split()), '| semilla:', SEMILLA)
numpy 2.4.6 | pandas 3.0.3 | scipy 1.17.1
Palabras del prompt: 36 | semilla: 2026
La salida confirma las versiones con las que se calcularon todas las cifras de esta entrada y que el prompt tiene $36$ palabras, un tamaño cómodo para los cuatro modelos. El prompt pide espacio libre en la parte superior porque el título de la portada se añadirá después con código, no con el modelo; por eso el prompt negativo excluye texto y letras. Los colores de COLORES identifican a cada herramienta en todas las figuras del día.
Los cuatro bloques siguientes necesitan una GPU o una clave de API, así que no se ejecutaron para escribir la entrada. Se muestran completos para que usted los ejecute en su equipo, con una salida de ejemplo comentada.
SDXL con diffusers
La biblioteca diffusers de Hugging Face carga cualquiera de estos modelos con una clase de pipeline (tubería) que agrupa los codificadores de texto, la red de eliminación de ruido y el decodificador. Para SDXL, la clase es StableDiffusionXLPipeline. El siguiente bloque descarga el modelo (unos $7$ GB la primera vez), genera la portada con $30$ pasos y una escala de guía de $7.0$, y mide el tiempo:
# Generación local con SDXL base 1.0 en Python (requiere GPU; no se ejecutó):
import time
import torch
from pathlib import Path
from diffusers import StableDiffusionXLPipeline

carpeta_portadas = Path('cuaderno_vivo/portadas')
carpeta_portadas.mkdir(parents = True, exist_ok = True)
pipe_sdxl = StableDiffusionXLPipeline.from_pretrained(
    'stabilityai/stable-diffusion-xl-base-1.0',
    torch_dtype = torch.float16, variant = 'fp16', use_safetensors = True)
pipe_sdxl.enable_model_cpu_offload()   # con VRAM de sobra: pipe_sdxl.to('cuda')

# Misma semilla para las cuatro herramientas:
generador = torch.Generator('cpu').manual_seed(SEMILLA)
inicio = time.perf_counter()
imagen = pipe_sdxl(prompt = PROMPT, negative_prompt = NEGATIVO,
                   num_inference_steps = 30, guidance_scale = 7.0,
                   width = 1024, height = 1024, generator = generador).images[0]
imagen.save(carpeta_portadas / 'sdxl_2026.png')
print(imagen.size, f'en {time.perf_counter() - inicio:.1f} s')

# Salida de ejemplo (puede variar):
# (1024, 1024) en 14.3 s
Tres detalles del bloque se repiten en los demás. El generador de torch se crea en la CPU con la semilla $2026$, lo que hace la imagen reproducible en el mismo equipo y con la misma versión de las bibliotecas (como vio ayer, cambiar de tarjeta o de versión puede cambiar los píxeles). enable_model_cpu_offload() mantiene en la GPU solo la parte del modelo que trabaja en cada momento: ahorra VRAM a cambio de algo de velocidad. Y el tiempo se mide alrededor de la llamada, no de la carga del modelo, que solo se paga una vez por sesión.
FLUX.1 schnell en cuatro pasos
FLUX.1 usa su propia clase, FluxPipeline, y la precisión recomendada es bfloat16. Observe los tres parámetros que exige la ficha de schnell y la ausencia de prompt negativo:
# Generación local con FLUX.1 schnell en Python (requiere GPU; no se ejecutó):
from diffusers import FluxPipeline

pipe_schnell = FluxPipeline.from_pretrained('black-forest-labs/FLUX.1-schnell',
                                            torch_dtype = torch.bfloat16)
pipe_schnell.enable_model_cpu_offload()

# Modelo destilado: sin guía, cuatro pasos y secuencia de texto de 256 tokens:
generador = torch.Generator('cpu').manual_seed(SEMILLA)
inicio = time.perf_counter()
imagen = pipe_schnell(prompt = PROMPT, guidance_scale = 0.0, num_inference_steps = 4,
                      max_sequence_length = 256, width = 1024, height = 1024,
                      generator = generador).images[0]
imagen.save(carpeta_portadas / 'schnell_2026.png')
print(imagen.size, f'en {time.perf_counter() - inicio:.1f} s')

# Salida de ejemplo (puede variar):
# (1024, 1024) en 9.8 s
Aunque schnell tiene cinco veces más parámetros que SDXL, hace $4$ pasos en lugar de $30$, por lo que el tiempo por imagen puede ser parecido o menor. Si su tarjeta tiene poca VRAM, la descarga a CPU es casi obligatoria: los pesos del transformador en bfloat16 ocupan unos $24$ GB, más que la memoria de cualquier tarjeta de consumo de gama media. A cambio, el equipo necesita bastante memoria RAM del sistema para alojar lo que no cabe en la GPU.
FLUX.1 dev con guía
FLUX.1 dev se llama igual, cambiando el identificador y tres parámetros: escala de guía $3.5$, $50$ pasos y secuencia de texto de $512$ tokens, como en el ejemplo de su ficha. Antes de ejecutar este bloque, Hugging Face le pedirá aceptar la licencia no comercial en la página del modelo:
# Generación local con FLUX.1 dev en Python (requiere GPU y aceptar su licencia; no se ejecutó):
pipe_dev = FluxPipeline.from_pretrained('black-forest-labs/FLUX.1-dev',
                                        torch_dtype = torch.bfloat16)
pipe_dev.enable_model_cpu_offload()

# Modelo con guía: 3.5 de escala, unos 50 pasos y secuencia de texto de 512 tokens:
generador = torch.Generator('cpu').manual_seed(SEMILLA)
inicio = time.perf_counter()
imagen = pipe_dev(prompt = PROMPT, guidance_scale = 3.5, num_inference_steps = 50,
                  max_sequence_length = 512, width = 1024, height = 1024,
                  generator = generador).images[0]
imagen.save(carpeta_portadas / 'dev_2026.png')
print(imagen.size, f'en {time.perf_counter() - inicio:.1f} s')

# Salida de ejemplo (puede variar):
# (1024, 1024) en 61.5 s
La escala de guía de dev no funciona exactamente como la de SDXL: dev es un modelo de “guía destilada”, que recibe la escala como una entrada más en lugar de hacer dos predicciones por paso. Por eso valores de $3$ a $4$ ya dan imágenes fieles al prompt, mientras que en SDXL lo habitual es de $5$ a $8$. El precio es el tiempo: con $50$ pasos, cada imagen tarda del orden de un minuto en una tarjeta de consumo.
Stable Image Core con requests
La API no necesita diffusers ni GPU, solo requests y una clave guardada en una variable de entorno. El cuerpo de la petición es un formulario multipart/form-data; el argumento files={'none': ''} es el truco que usa la documentación de Stability para forzar ese formato aunque no se suba ningún archivo. La cabecera accept: image/* pide los bytes de la imagen directamente:
# Generación en la nube con Stable Image Core en Python (requiere clave de API; no se ejecutó):
import os
import requests

clave = os.environ['STABILITY_API_KEY']   # nunca escriba la clave en el código
respuesta = requests.post(
    'https://api.stability.ai/v2beta/stable-image/generate/core',
    headers = {'authorization': f'Bearer {clave}', 'accept': 'image/*'},
    files = {'none': ''},
    data = {'prompt': PROMPT, 'negative_prompt': NEGATIVO, 'aspect_ratio': '1:1',
            'seed': SEMILLA, 'output_format': 'png'},
    timeout = 60,
)

# Guardar la imagen solo si la petición tuvo éxito:
if respuesta.status_code == 200:
    ruta = carpeta_portadas / 'core_2026.png'
    with open(ruta, 'wb') as archivo:
        archivo.write(respuesta.content)
    print(respuesta.status_code, ruta, f'{len(respuesta.content) / 1024:.0f} KB')
else:
    print(respuesta.status_code, respuesta.json())

# Salida de ejemplo (puede variar):
# 200 cuaderno_vivo/portadas/core_2026.png 1489 KB
Con la misma semilla, el servicio devuelve la misma imagen mientras Stability no cambie el modelo interno, algo que usted no controla: la reproducibilidad de una API es prestada. Si la petición falla, el código imprime el cuerpo JSON del error en lugar de guardar un archivo corrupto; los errores más comunes son una clave inválida, créditos agotados o un prompt bloqueado por la moderación del servicio.
Los parámetros de Stable Image Core (prompt, negative_prompt, aspect_ratio, seed, output_format) y las cabeceras authorization: Bearer y accept: image/* se contrastaron en octubre de 2026 con el cuaderno oficial de ejemplos de la API de Stability AI. Como el servicio evoluciona, revise la referencia de la API en la plataforma antes de usar el bloque.
Con los cuatro bloques ejecutados, Sofía tiene cuatro archivos en cuaderno_vivo/portadas/. En la práctica no genera una sola imagen por herramienta, sino ocho, con las semillas de $2026$ a $2033$, porque una sola semilla puede ser afortunada o desgraciada para cualquier modelo. Esas $32$ portadas son el material de las secciones siguientes.
Métricas automáticas
Con $32$ portadas en la carpeta, la tentación es pedirle a un número que diga cuál es la mejor herramienta. La investigación en generación de imágenes usa dos métricas automáticas por encima de todas: CLIPScore, que mide si una imagen corresponde a su texto, y FID, que mide si un conjunto de imágenes generadas se parece estadísticamente a un conjunto de imágenes reales. Las dos sirven, y las dos tienen límites que conviene conocer antes de confiar en ellas.
CLIPScore
CLIP (por sus siglas en inglés: “Contrastive Language-Image Pre-training”) es un modelo de OpenAI, publicado por Radford y coautores en 2021, que proyecta imágenes y textos en el mismo espacio de embeddings, la idea que vio ayer al estudiar cómo un modelo une texto e imagen. Hessel y coautores propusieron en 2021 usar esa proyección como métrica: si el embedding de la imagen y el del texto apuntan en la misma dirección, la imagen corresponde al texto.
$$ \text{CLIPScore}(I, C) = w \cdot \max\left(\cos(E_I, E_C), 0\right) $$
La lógica de la fórmula es la siguiente:
- $E_I$ es el embedding de la imagen $I$ y $E_C$ el del texto $C$ (“caption”), ambos producidos por CLIP. El coseno entre ellos mide el ángulo que forman, sin importar su longitud, igual que la similitud coseno del Día 2.
- El $\max(\cdot, 0)$ recorta los cosenos negativos a cero: una imagen que “apunta en contra” del texto no se distingue de una que no tiene nada que ver con él.
- El factor $w = 2.5$ solo reescala. En la práctica, los cosenos de CLIP entre imágenes y textos rara vez superan $0.4$, y multiplicar por $2.5$ acerca la puntuación a un rango de $0$ a $1$ más fácil de leer.
- En conclusión, CLIPScore es una similitud coseno recortada y reescalada, y no necesita imágenes de referencia: por eso los autores la llaman “sin referencia”.
Un CLIP real produce vectores de $512$ o $768$ dimensiones. Para ver el cálculo sin descargar nada, el siguiente bloque usa embeddings de juguete de $4$ dimensiones para la portada y tres descripciones:
# CLIPScore de juguete con embeddings de 4 dimensiones en Python:
def clipscore(e_imagen, e_texto, w = 2.5):
    # Similitud coseno recortada en cero y reescalada por w:
    coseno = e_imagen @ e_texto / (np.linalg.norm(e_imagen) * np.linalg.norm(e_texto))
    return w * max(coseno, 0.0), coseno

# Embedding de juguete de la portada y de tres descripciones:
e_portada = np.array([0.8, 0.3, 0.1, 0.5])
descripciones = {
    'libreta con gráficas sobre un escritorio': np.array([0.4, -0.4, -0.9, 0.5]),
    'guitarra en un escenario de noche': np.array([0.4, -0.5, 0.9, -0.3]),
    'texto con la frase Semana de estadística': np.array([0.2, 0.6, -0.5, -0.6]),
}
for texto, e_texto in descripciones.items():
    puntuacion, coseno = clipscore(e_portada, e_texto)
    print(f'{texto:42s} coseno = {coseno:6.3f}  CLIPScore = {puntuacion:.3f}')
libreta con gráficas sobre un escritorio   coseno =  0.308  CLIPScore = 0.770
guitarra en un escenario de noche          coseno =  0.097  CLIPScore = 0.241
texto con la frase Semana de estadística   coseno = -0.010  CLIPScore = 0.000
La descripción que corresponde a la portada obtiene un coseno de $0.308$ y un CLIPScore de $0.770$; la de la guitarra, que no tiene nada que ver, baja a $0.241$. La tercera ilustra el recorte: su coseno es ligeramente negativo, $-0.010$, y su puntuación queda en $0$. Un CLIPScore más alto indica una imagen más fiel al texto, pero solo tiene sentido comparar puntuaciones calculadas con el mismo modelo CLIP, porque cada versión produce embeddings distintos.
Fíjese en lo que la métrica no ve. Una portada técnicamente fiel al prompt pero con una composición torpe, colores chillones o una libreta deformada puede obtener un CLIPScore alto. Y CLIP es notoriamente malo leyendo texto dentro de imágenes y contando objetos: una portada con tres plantas en lugar de una le parecerá casi igual de buena.
FID
La distancia de inicio de Fréchet (o FID, por sus siglas en inglés: “Fréchet Inception Distance”) la propusieron Heusel y coautores en 2017 para evaluar redes generativas antagónicas. En lugar de comparar una imagen con un texto, compara dos conjuntos de imágenes: uno real y otro generado. Cada imagen se pasa por la red Inception v3 y se toma un vector de $2,048$ características; luego se ajusta una gaussiana a cada conjunto y se mide la distancia entre las dos gaussianas:
$$ \text{FID} = \lVert \mu_r - \mu_g \rVert^2 + \text{Tr}\left(\Sigma_r + \Sigma_g - 2(\Sigma_r \Sigma_g)^{1/2}\right) $$
La lógica de la fórmula tiene dos partes:
- El primer término, $\lVert \mu_r - \mu_g \rVert^2$, es la distancia al cuadrado entre las medias de las características reales ($\mu_r$) y generadas ($\mu_g$). Mide si las imágenes generadas están, en promedio, “en el mismo sitio” que las reales.
- El segundo término compara las matrices de covarianza $\Sigma_r$ y $\Sigma_g$, que describen la variedad de cada conjunto. Si el generador produce siempre la misma imagen, su covarianza se encoge y este término crece aunque las medias coincidan.
- $\text{Tr}$ es la traza (la suma de la diagonal) y $(\Sigma_r \Sigma_g)^{1/2}$ es la raíz cuadrada de una matriz, que
scipy.linalg.sqrtmcalcula directamente. - En conclusión, el FID mide a la vez calidad media y diversidad: cuanto menor sea el FID, más se parecen las imágenes generadas a las reales, y vale $0$ solo si las dos gaussianas son idénticas.
Para entender la fórmula sin Inception ni miles de imágenes, el siguiente bloque usa gaussianas en $2$ dimensiones. Las “reales” tienen $\mu_r = (0, 0)$ y $\Sigma_r = I$; las “generadas” tienen la misma covarianza y la media desplazada $0$, $0.5$ y $1.5$ en el eje horizontal. Con covarianzas iguales, el segundo término se anula y el FID teórico es exactamente $\lVert \mu_r - \mu_g \rVert^2$: $0$, $0.25$ y $2.25$, una forma sencilla de comprobar que el código está bien:
# FID de juguete con gaussianas en 2D en Python:
from scipy.linalg import sqrtm
from matplotlib.patches import Ellipse

def fid(mu_r, sigma_r, mu_g, sigma_g):
    # Distancia de Fréchet entre dos gaussianas:
    raiz = sqrtm(sigma_r @ sigma_g)
    if np.iscomplexobj(raiz):
        raiz = raiz.real
    return float(np.sum((mu_r - mu_g) ** 2) + np.trace(sigma_r + sigma_g - 2 * raiz))

def elipse(ax, datos, color):
    # Elipse de covarianza a dos desviaciones estándar:
    mu, cov = datos.mean(axis = 0), np.cov(datos, rowvar = False)
    valores, vectores = np.linalg.eigh(cov)
    angulo = np.degrees(np.arctan2(vectores[1, 1], vectores[0, 1]))
    ax.add_patch(Ellipse(mu, 4 * np.sqrt(valores[1]), 4 * np.sqrt(valores[0]), angle = angulo,
                         fill = False, color = color, linewidth = 2))

mu_r, sigma_r = np.zeros(2), np.eye(2)
reales = rng.multivariate_normal(mu_r, sigma_r, size = 500)
fig, ejes = plt.subplots(1, 3, figsize = (12, 4.2), sharex = True, sharey = True)
for ax, d in zip(ejes, [0.0, 0.5, 1.5]):
    mu_g = np.array([d, 0.0])
    generadas = rng.multivariate_normal(mu_g, sigma_r, size = 500)
    teorico = fid(mu_r, sigma_r, mu_g, sigma_r)
    empirico = fid(reales.mean(axis = 0), np.cov(reales, rowvar = False),
                   generadas.mean(axis = 0), np.cov(generadas, rowvar = False))
    print(f'desplazamiento {d}: FID teórico = {teorico:.4f} | FID con 500 muestras = {empirico:.4f}')
    ax.scatter(reales[:, 0], reales[:, 1], s = 8, alpha = 0.35, color = '#2a78d6', label = 'Reales')
    ax.scatter(generadas[:, 0], generadas[:, 1], s = 8, alpha = 0.35, color = '#eb6834', label = 'Generadas')
    elipse(ax, reales, '#2a78d6')
    elipse(ax, generadas, '#eb6834')
    ax.set_title(f'$\\mu_g$ = ({d}, 0)   FID = {empirico:.2f}', fontsize = 12)
    ax.set_xlim(-4.5, 5.5)
    ax.set_ylim(-4.5, 4.5)
    ax.set_aspect('equal')
ejes[0].legend(loc = 'lower left', fontsize = 9)
fig.suptitle('FID de juguete: reales frente a generadas', fontsize = 16)
plt.tight_layout()

# Efecto del tamaño de muestra cuando las dos distribuciones son idénticas:
for n in [50, 500, 5000]:
    a = rng.multivariate_normal(mu_r, sigma_r, size = n)
    b = rng.multivariate_normal(mu_r, sigma_r, size = n)
    print(f'n = {n:5d}: FID entre dos muestras de la misma gaussiana = '
          f'{fid(a.mean(0), np.cov(a, rowvar = False), b.mean(0), np.cov(b, rowvar = False)):.4f}')
plt.show()
desplazamiento 0.0: FID teórico = 0.0000 | FID con 500 muestras = 0.0327
desplazamiento 0.5: FID teórico = 0.2500 | FID con 500 muestras = 0.2065
desplazamiento 1.5: FID teórico = 2.2500 | FID con 500 muestras = 2.1903
n =    50: FID entre dos muestras de la misma gaussiana = 0.0985
n =   500: FID entre dos muestras de la misma gaussiana = 0.0057
n =  5000: FID entre dos muestras de la misma gaussiana = 0.0014
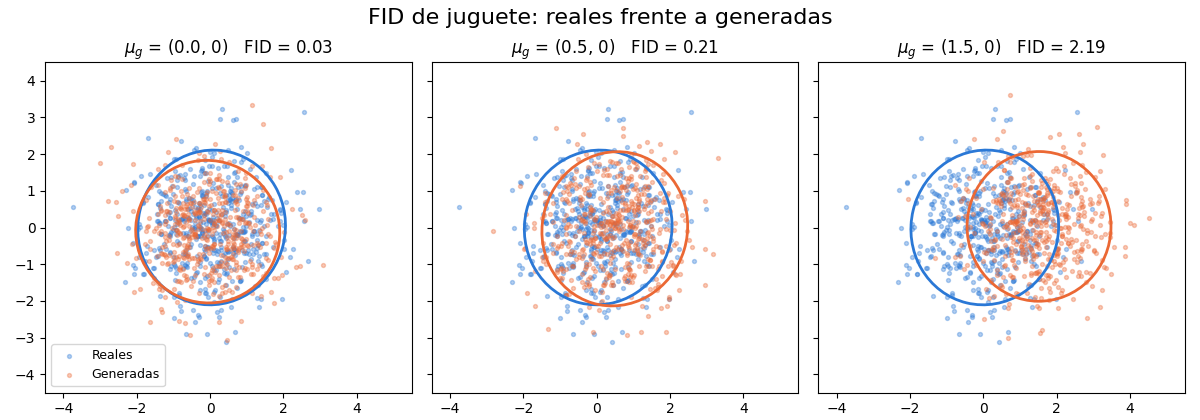
Los valores teóricos son exactamente $0$, $0.25$ y $2.25$, lo que confirma que la función fid implementa bien la fórmula. Los valores empíricos, calculados con $500$ puntos por nube, se acercan pero no coinciden: $0.0327$, $0.2065$ y $2.1903$. Como puede ver en la figura, cuanto más se separan las elipses de covarianza, más crece el FID, y lo hace con el cuadrado de la distancia: triplicar el desplazamiento de $0.5$ a $1.5$ multiplica el FID por nueve.
Las tres últimas líneas muestran el problema práctico más importante del FID: su sesgo con muestras pequeñas. Dos muestras de la misma gaussiana deberían dar un FID de cero, pero con $50$ puntos se obtiene $0.0985$, que baja a $0.0057$ con $500$ y a $0.0014$ con $5,000$. En $2$ dimensiones el efecto es pequeño; con las $2,048$ dimensiones de Inception, hay que estimar una matriz de covarianza de más de cuatro millones de entradas, y con pocas imágenes el sesgo domina. Por eso los artículos calculan el FID con $10,000$ a $50,000$ imágenes, y por eso el FID no sirve para comparar las $32$ portadas de Sofía: con $8$ imágenes por herramienta, el número que saliera sería casi puro ruido.
Por qué no bastan
Las dos métricas son útiles para lo que fueron diseñadas: CLIPScore para vigilar la fidelidad al texto en miles de imágenes, FID para comparar modelos completos con grandes conjuntos de referencia. Para la pregunta de Sofía, sin embargo, se quedan cortas por cuatro razones:
- No miden estética. Ni el coseno de CLIP ni la distancia entre gaussianas de Inception saben si una composición es armónica, si la paleta funciona o si queda espacio para el título.
- No miden adecuación al proyecto. Una portada “fiel” al prompt puede no parecerse a las demás portadas del Cuaderno Vivo, y la coherencia entre semanas es lo que Sofía más valora.
- Heredan los sesgos de sus redes. CLIP aprendió de cientos de millones de pares imagen y texto de internet, e Inception se entrenó con fotografías de ImageNet: los dos juzgan con los gustos y las lagunas de esos datos, no con los de Sofía. Una ilustración plana, por ejemplo, está lejos de las fotos de ImageNet aunque sea exactamente lo que se pidió.
- Necesitan escala. FID exige miles de imágenes; CLIPScore, aunque se calcula por imagen, es ruidoso de una imagen a otra y se interpreta mejor en promedios grandes.
Una métrica automática responde a la pregunta para la que fue diseñada, no a la suya. Para elegir portadas, la referencia sigue siendo el ojo humano, siempre que se use con método.
Evaluación humana ciega
Pedirle a Sofía que mire las $32$ portadas y diga cuál le gusta más tiene dos problemas. El primero es el sesgo de expectativa: si sabe que una imagen viene de FLUX.1 dev, “el modelo bueno”, tenderá a verla mejor. El segundo es la opinión única: el gusto de una persona no representa el de quienes verán el portafolio. La solución clásica es una evaluación ciega con varios jueces.
Sofía recluta a dos jueces más: Diego, que se declara “sin ojo para el arte” y por eso mismo es útil, y Valeria, una amiga que estudia diseño gráfico. Una cuarta persona, que no puntúa, asigna a cada herramienta una letra al azar, baraja las $32$ portadas y guarda la clave. Cada juez puntúa cada portada de $1$ (inservible) a $5$ (la publicaría tal cual) sin saber de qué herramienta viene. Las $96$ puntuaciones de esta entrada son hipotéticas, de juguete: están fijadas en el código para ilustrar el método, no son una medición real de los modelos.
El protocolo y las puntuaciones
El siguiente bloque fija las puntuaciones, hace el cegado con el generador de la serie, calcula la media y el error estándar por herramienta y juez, y dibuja barras agrupadas. El error estándar de la media de $n$ puntuaciones con desviación estándar $s$ es:
$$ SE = \frac{s}{\sqrt{n}} $$
La lógica de la fórmula es la siguiente:
- La desviación estándar $s$ mide cuánto varían las puntuaciones de un juez entre las $8$ portadas de una misma herramienta.
- Dividir entre $\sqrt{n}$ refleja que la media de $n$ valores varía menos que cada valor suelto: con $8$ portadas, la incertidumbre de la media es $s / 2.83$.
- En conclusión, el error estándar dice cuánto se movería la media si se repitiera la evaluación con otras $8$ semillas, y se dibuja como una barra de error.
# Evaluación humana ciega con puntuaciones de juguete en Python:
# Puntuaciones hipotéticas de 1 a 5 (8 portadas por herramienta y juez):
puntuaciones = {
    'Sofía': {'SDXL base 1.0': [3, 3, 4, 2, 3, 3, 3, 4], 'FLUX.1 schnell': [4, 3, 4, 4, 5, 3, 4, 4],
              'FLUX.1 dev': [4, 5, 4, 4, 3, 4, 4, 5], 'Stable Image Core': [4, 4, 3, 3, 4, 3, 3, 4]},
    'Diego': {'SDXL base 1.0': [2, 3, 3, 3, 2, 2, 3, 2], 'FLUX.1 schnell': [3, 3, 4, 4, 3, 3, 3, 5],
              'FLUX.1 dev': [3, 4, 4, 3, 3, 4, 3, 4], 'Stable Image Core': [4, 3, 2, 3, 3, 4, 2, 3]},
    'Valeria': {'SDXL base 1.0': [3, 4, 2, 2, 3, 2, 4, 5], 'FLUX.1 schnell': [3, 4, 5, 5, 4, 3, 5, 5],
                'FLUX.1 dev': [4, 4, 4, 3, 4, 5, 4, 5], 'Stable Image Core': [4, 3, 2, 2, 3, 4, 2, 4]},
}

# Cegado: cada herramienta recibe una letra al azar y las 32 portadas se barajan:
letras = {str(h): letra for h, letra in zip(rng.permutation(HERRAMIENTAS), 'ABCD')}
orden = rng.permutation([f'{letras[h]}{i + 1}' for h in HERRAMIENTAS for i in range(8)])
print('Clave del cegado (la guarda una cuarta persona):', letras)
print('Primeras 8 portadas que ven los jueces:', [str(c) for c in orden[:8]])

filas = [{'juez': juez, 'herramienta': h, 'imagen': i + 1, 'puntuacion': p}
         for juez, por_herramienta in puntuaciones.items()
         for h, valores in por_herramienta.items() for i, p in enumerate(valores)]
evaluacion = pd.DataFrame(filas)
resumen = evaluacion.groupby(['herramienta', 'juez'])['puntuacion'].agg(['mean', 'std', 'count'])
resumen['error_estandar'] = resumen['std'] / np.sqrt(resumen['count'])
medias = evaluacion.groupby('herramienta')['puntuacion'].mean().reindex(HERRAMIENTAS)
print('Valores:', len(evaluacion))
print(medias.round(3).to_string())

# Barras agrupadas por herramienta, una barra por juez, con error estándar:
fig, ax = plt.subplots(figsize = (8, 4.8))
colores_juez = {'Sofía': '#2a78d6', 'Diego': '#eb6834', 'Valeria': '#1baf7a'}
x = np.arange(len(HERRAMIENTAS))
for k, (juez, color) in enumerate(colores_juez.items()):
    datos_juez = resumen.xs(juez, level = 'juez').reindex(HERRAMIENTAS)
    ax.bar(x + (k - 1) * 0.26, datos_juez['mean'], width = 0.24, color = color, label = juez,
           yerr = datos_juez['error_estandar'], capsize = 3, error_kw = {'ecolor': '#52514e', 'linewidth': 1})
ax.set_xticks(x)
ax.set_xticklabels(HERRAMIENTAS)
ax.set_ylim(1, 5)
ax.set_ylabel('Puntuación media (1 a 5)')
ax.set_title('Evaluación humana ciega (datos de juguete)', fontsize = 16)
ax.legend(ncol = 3, loc = 'upper left', frameon = False)
ax.grid(axis = 'y', color = '#e1e0d9', linewidth = 0.8)
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Clave del cegado (la guarda una cuarta persona): {'Stable Image Core': 'A', 'SDXL base 1.0': 'B', 'FLUX.1 dev': 'C', 'FLUX.1 schnell': 'D'}
Primeras 8 portadas que ven los jueces: ['D7', 'C8', 'B3', 'D4', 'B4', 'B8', 'D6', 'C2']
Valores: 96
herramienta
SDXL base 1.0        2.917
FLUX.1 schnell       3.875
FLUX.1 dev           3.917
Stable Image Core    3.167
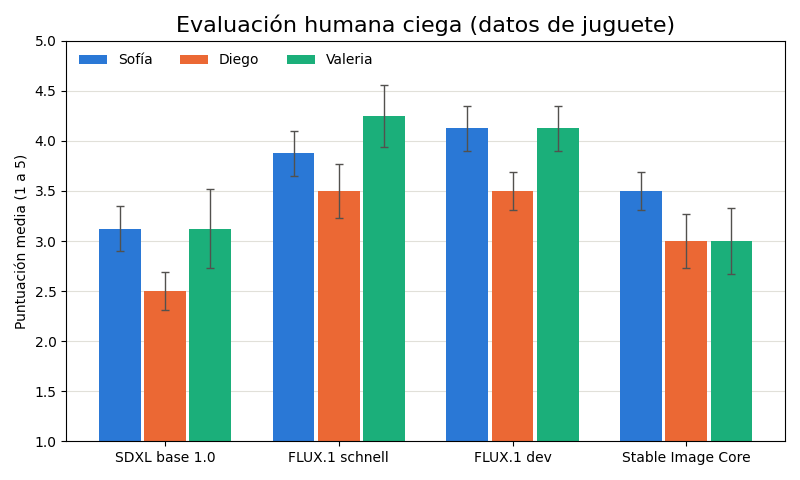
El cegado asignó la letra A a Stable Image Core, la B a SDXL, la C a FLUX.1 dev y la D a FLUX.1 schnell, y los jueces vieron las portadas en un orden mezclado (D7, C8, B3, D4…), de modo que ninguna herramienta acapara el principio o el final de la sesión, cuando la atención es distinta. Las $96$ puntuaciones se recogen en la Tabla 3.
Tabla 3. Puntuaciones humanas de juguete (hipotéticas) de 3 jueces a 8 portadas por herramienta.
| Juez | Herramienta | P1 | P2 | P3 | P4 | P5 | P6 | P7 | P8 | Media |
|---|---|---|---|---|---|---|---|---|---|---|
| Sofía | SDXL base 1.0 | 3 | 3 | 4 | 2 | 3 | 3 | 3 | 4 | 3.125 |
| Sofía | FLUX.1 schnell | 4 | 3 | 4 | 4 | 5 | 3 | 4 | 4 | 3.875 |
| Sofía | FLUX.1 dev | 4 | 5 | 4 | 4 | 3 | 4 | 4 | 5 | 4.125 |
| Sofía | Stable Image Core | 4 | 4 | 3 | 3 | 4 | 3 | 3 | 4 | 3.500 |
| Diego | SDXL base 1.0 | 2 | 3 | 3 | 3 | 2 | 2 | 3 | 2 | 2.500 |
| Diego | FLUX.1 schnell | 3 | 3 | 4 | 4 | 3 | 3 | 3 | 5 | 3.500 |
| Diego | FLUX.1 dev | 3 | 4 | 4 | 3 | 3 | 4 | 3 | 4 | 3.500 |
| Diego | Stable Image Core | 4 | 3 | 2 | 3 | 3 | 4 | 2 | 3 | 3.000 |
| Valeria | SDXL base 1.0 | 3 | 4 | 2 | 2 | 3 | 2 | 4 | 5 | 3.125 |
| Valeria | FLUX.1 schnell | 3 | 4 | 5 | 5 | 4 | 3 | 5 | 5 | 4.250 |
| Valeria | FLUX.1 dev | 4 | 4 | 4 | 3 | 4 | 5 | 4 | 5 | 4.125 |
| Valeria | Stable Image Core | 4 | 3 | 2 | 2 | 3 | 4 | 2 | 4 | 3.000 |
Promediando los tres jueces, FLUX.1 dev obtiene $3.917$ y FLUX.1 schnell $3.875$: una diferencia de $0.04$ puntos, mucho menor que las barras de error de la figura. Las dos FLUX quedan claramente por encima de Stable Image Core ($3.167$) y de SDXL ($2.917$). Dicho de otro modo, con estos datos de juguete los cuatro pasos de schnell rinden prácticamente lo mismo que los cincuenta de dev para este tipo de portada.
La figura muestra además un patrón típico de las evaluaciones humanas: Diego puntúa sistemáticamente más bajo que Sofía y Valeria en las cuatro herramientas. Eso no es un problema siempre que su orden de preferencias coincida con el de los demás, porque lo que importa para elegir es la comparación, no el nivel absoluto. Medir ese acuerdo es el siguiente paso.
Acuerdo entre jueces
Si los tres jueces puntuaran al azar, sus medias no significarían nada. La forma de comprobarlo es medir cuánto coinciden en el orden de las portadas. Como las puntuaciones de $1$ a $5$ son ordinales (un $4$ es mejor que un $3$, pero no necesariamente “un punto mejor”), la medida adecuada no es la correlación de Pearson, sino la correlación de rangos de Spearman, que Charles Spearman propuso en 1904:
$$ \rho = 1 - \frac{6 \sum_{i=1}^{n} d_i^2}{n(n^2 - 1)} $$
La lógica de la fórmula es la siguiente:
- Se ordenan las $n$ portadas según las puntuaciones de cada juez y $d_i$ es la diferencia entre los dos rangos que recibe la portada $i$.
- Si los dos jueces ordenan igual, todas las $d_i$ son cero y $\rho = 1$; si ordenan exactamente al revés, $\rho = -1$; si no hay relación, $\rho$ ronda $0$.
- La fórmula cerrada supone que no hay empates. Con puntuaciones de $1$ a $5$ hay muchos, así que
scipy.stats.spearmanrasigna a los empatados su rango medio y calcula la correlación de Pearson entre rangos, que es la definición general. - En conclusión, $\rho$ mide si dos jueces coinciden en qué portadas son mejores que otras, sin importar que uno sea más severo.
El siguiente bloque calcula $\rho$ para los tres pares de jueces sobre las $32$ portadas y dibuja la matriz como un mapa de calor:
# Acuerdo entre jueces con la correlación de Spearman en Python:
from scipy.stats import spearmanr
from itertools import combinations

jueces = list(puntuaciones)
vectores = {j: evaluacion[evaluacion['juez'] == j].sort_values(['herramienta', 'imagen'])['puntuacion'].to_numpy()
            for j in jueces}
matriz = pd.DataFrame(np.eye(3), index = jueces, columns = jueces)
for a, b in combinations(jueces, 2):
    rho, p = spearmanr(vectores[a], vectores[b])
    matriz.loc[a, b] = matriz.loc[b, a] = rho
    print(f'{a} y {b}: rho = {rho:.3f} (p = {p:.4f})')
pares = matriz.to_numpy()[np.triu_indices(3, k = 1)]
print('Acuerdo medio entre pares:', round(pares.mean(), 3))

# Acuerdo en el orden de las herramientas (medias por juez):
orden_juez = evaluacion.groupby(['juez', 'herramienta'])['puntuacion'].mean().unstack().loc[jueces]
print(orden_juez[HERRAMIENTAS].round(3).to_string())

# Mapa de calor de la matriz de correlaciones:
fig, ax = plt.subplots(figsize = (5.6, 4.8))
imagen = ax.imshow(matriz.to_numpy(), cmap = 'Blues', vmin = 0, vmax = 1)
ax.set_xticks(range(3))
ax.set_xticklabels(jueces)
ax.set_yticks(range(3))
ax.set_yticklabels(jueces)
for i in range(3):
    for j in range(3):
        valor = matriz.iloc[i, j]
        ax.text(j, i, f'{valor:.2f}', ha = 'center', va = 'center', fontsize = 12,
                color = '#ffffff' if valor > 0.6 else '#0b0b0b')
fig.colorbar(imagen, ax = ax, label = 'rho de Spearman')
ax.set_title('Acuerdo entre jueces', fontsize = 16)
plt.tight_layout()
plt.show()
Sofía y Diego: rho = 0.492 (p = 0.0042)
Sofía y Valeria: rho = 0.520 (p = 0.0023)
Diego y Valeria: rho = 0.605 (p = 0.0002)
Acuerdo medio entre pares: 0.539
herramienta  SDXL base 1.0  FLUX.1 schnell  FLUX.1 dev  Stable Image Core
juez
Sofía                3.125           3.875       4.125                3.5
Diego                2.500           3.500       3.500                3.0
Valeria              3.125           4.250       4.125                3.0
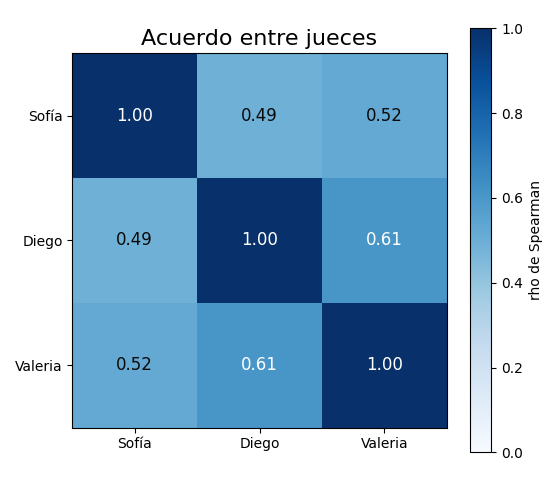
Los tres pares tienen correlaciones positivas y moderadas: $0.492$ entre Sofía y Diego, $0.520$ entre Sofía y Valeria y $0.605$ entre Diego y Valeria, con un acuerdo medio de $0.539$. Los valores $p$, todos por debajo de $0.005$, dicen que un acuerdo así sería muy improbable si los jueces puntuaran al azar. El mapa de calor muestra que el par más alineado es, curiosamente, el del ingeniero escéptico y la estudiante de diseño.
La tabla de medias por juez añade un matiz importante. Los tres jueces sitúan a SDXL en el último lugar y a las dos FLUX en los primeros, pero no se ponen de acuerdo sobre cuál de ellas gana: Sofía prefiere dev ($4.125$ frente a $3.875$), Valeria prefiere schnell ($4.250$ frente a $4.125$) y Diego las empata en $3.500$. Cuando los jueces no coinciden en el primer puesto, la diferencia entre los candidatos es menor que el ruido de la evaluación, y la decisión debe apoyarse en los demás criterios.
Tenga en cuenta además que parte del acuerdo viene de las diferencias entre herramientas: si una herramienta es claramente peor, todos los jueces le ponen notas bajas a sus ocho portadas, y eso sube $\rho$ aunque dentro de cada herramienta no coincidan tanto. Con más tiempo, Sofía podría calcular también el acuerdo dentro de cada herramienta o usar un coeficiente diseñado para varios jueces, como el alfa de Krippendorff.
Claude como crítico visual
Tres jueces humanos son un lujo que Sofía no tendrá cada semana: Valeria no puede puntuar portadas todos los lunes. ¿Puede un modelo con visión hacer de juez? La respuesta de esta serie es: puede hacer de crítico auxiliar, no de juez final. Claude recibe la imagen junto con una rúbrica y devuelve puntuaciones estructuradas y un comentario; Sofía lee el comentario, compara con su propio criterio y decide.
El bloque siguiente abre una portada con PIL, la reduce a $1024$ píxeles de lado como máximo para no pagar tokens de más, la convierte a base64 y la envía a Claude Sonnet 5.5. El bloque de imagen va antes del bloque de texto, como recomienda la documentación de visión. Igual que en el Día 6, la respuesta se pide con client.messages.parse y un modelo de Pydantic, CriticaVisual, para que llegue validada. Como en todos los modelos Claude 5, no se envían temperature ni top_p: la profundidad se regula con output_config={'effort': 'low'}. Este bloque llama a la API y no se ejecutó; la salida es un ejemplo comentado:
# Claude Sonnet 5.5 como crítico visual con salida estructurada en Python (API; no se ejecutó):
import base64
import io
import anthropic
from PIL import Image
from pydantic import BaseModel, Field

class CriticaVisual(BaseModel):
    composicion: int = Field(description = 'De 1 a 5: equilibrio y jerarquía visual')
    legibilidad_titulo: int = Field(description = 'De 1 a 5: si el espacio libre superior admite un título legible')
    coherencia_paleta: int = Field(description = 'De 1 a 5: si respeta la paleta azul petróleo y ocre')
    comentario: str = Field(description = 'Dos frases con la mejora más importante')

def a_base64(ruta, lado_maximo = 1024):
    # Reducir la imagen y codificarla en base64:
    imagen = Image.open(ruta).convert('RGB')
    imagen.thumbnail((lado_maximo, lado_maximo))
    memoria = io.BytesIO()
    imagen.save(memoria, format = 'PNG')
    return base64.standard_b64encode(memoria.getvalue()).decode('utf-8')

RUBRICA = ('Usted es un crítico de diseño editorial. Evalúa portadas del Cuaderno Vivo, un diario de '
           'estudio. El título se añadirá después en la franja superior. Puntúe con la rúbrica y sea '
           'concreto. No adivine qué herramienta generó la imagen.')
cliente = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno
respuesta = cliente.messages.parse(
    model = 'claude-sonnet-5-5',
    max_tokens = 1024,
    system = RUBRICA,
    output_config = {'effort': 'low'},
    output_format = CriticaVisual,
    messages = [{'role': 'user', 'content': [
        {'type': 'image', 'source': {'type': 'base64', 'media_type': 'image/png',
                                     'data': a_base64('cuaderno_vivo/portadas/D4.png')}},
        {'type': 'text', 'text': 'Evalúe esta portada de la semana de estadística.'},
    ]}],
)

# Motivo de parada antes de leer el contenido:
if respuesta.stop_reason == 'refusal':
    raise RuntimeError('El modelo rechazó la petición.')
critica = respuesta.parsed_output
print(critica.composicion, critica.legibilidad_titulo, critica.coherencia_paleta)
print(critica.comentario)
print('Tokens:', respuesta.usage.input_tokens, '+', respuesta.usage.output_tokens)

# Salida de ejemplo (puede variar):
# 4 3 5
# La composición centrada funciona, pero la planta invade la franja superior y competirá con el
# título. Desplácela a la derecha o reduzca su altura para liberar el espacio.
# Tokens: 1512 + 96
Tres decisiones del bloque merecen comentario. Primero, Claude recibe la portada por su nombre ciego (D4.png), no por el de la herramienta, y el prompt de sistema le pide no adivinar el origen: el crítico automático también debe ser ciego. Segundo, la rúbrica tiene tres criterios concretos ligados al proyecto (composición, espacio para el título, paleta), en lugar de un vago “¿es bonita?”, lo que hace las puntuaciones más estables y el comentario más útil. Tercero, el coste es pequeño: con una imagen de $1024 \times 1024$, del orden de $1,500$ tokens de entrada a $2$ USD por millón en Sonnet 5.5, criticar las $32$ portadas cuesta alrededor de diez centavos de dólar.
Un crítico automático hereda los sesgos estéticos de sus datos de entrenamiento: puede preferir lo pulido y convencional, penalizar estilos poco representados o valorar distinto la misma imagen si cambia la redacción de la rúbrica. Use sus puntuaciones como una opinión más, compruebe de vez en cuando su acuerdo con los jueces humanos (con la misma $\rho$ de Spearman) y no deje nunca que decida solo qué se publica.
Diego propone una prueba rápida para saber cuánto vale el crítico: pasarle las mismas $32$ portadas ciegas y calcular su $\rho$ con cada juez humano. Si su acuerdo con los humanos es parecido al de los humanos entre sí, alrededor de $0.5$ en este ejemplo, el crítico es tan útil como un juez más; si es mucho menor, sus puntuaciones no aportan, aunque sus comentarios puedan seguir sirviendo como lista de cosas que revisar.
La decisión de Sofía
Sofía ya tiene una medida de calidad, la evaluación humana; le faltan el coste, el hardware y la velocidad, y combinarlo todo. Empecemos por el coste. Para las herramientas locales, el coste marginal de una imagen es la electricidad; para la API, el precio por imagen. El siguiente bloque calcula el coste de $100$ imágenes con supuestos explícitos (segundos por imagen, potencia del equipo, VRAM y precio del kilovatio hora) y lo enfrenta a la puntuación humana media:
# Coste por 100 imágenes frente a calidad percibida en Python:
# Supuestos ilustrativos (verifíquelos en su equipo y en la página de precios):
supuestos = pd.DataFrame({
    'segundos_por_imagen': [12, 8, 60, 6],
    'potencia_w': [250, 250, 250, 0],
    'vram_gb': [8, 12, 12, 0],
    'usd_por_imagen_api': [0.0, 0.0, 0.0, 0.03],
}, index = HERRAMIENTAS)
PRECIO_KWH = 0.12   # USD por kWh, supuesto

kwh_100 = supuestos['potencia_w'] * supuestos['segundos_por_imagen'] * 100 / 3.6e6
supuestos['usd_100'] = kwh_100 * PRECIO_KWH + supuestos['usd_por_imagen_api'] * 100
supuestos['minutos_100'] = supuestos['segundos_por_imagen'] * 100 / 60
supuestos['calidad'] = medias
print(supuestos[['usd_100', 'minutos_100', 'vram_gb', 'calidad']].round(4).to_string())
print('API, 80 portadas al mes:', round(80 * 0.03, 2), 'USD')

fig, ax = plt.subplots(figsize = (8, 4.8))
for h, fila in supuestos.iterrows():
    tamano = 60 + 40 * fila['vram_gb']
    ax.scatter(fila['usd_100'], fila['calidad'], s = tamano, color = COLORES[h],
               edgecolor = '#fcfcfb', linewidth = 2, zorder = 3)
    etiqueta = f"{h}\n{fila['vram_gb']:.0f} GB de VRAM" if fila['vram_gb'] else f'{h}\nsin GPU'
    ax.annotate(etiqueta, (fila['usd_100'], fila['calidad']), textcoords = 'offset points',
                xytext = (12, -4), fontsize = 9, color = '#52514e')
ax.set_xscale('log')
ax.set_xlim(0.005, 10)
ax.set_ylim(2.5, 4.3)
ax.set_xlabel('Coste por 100 imágenes (USD, escala logarítmica)')
ax.set_ylabel('Puntuación humana media')
ax.set_title('Coste frente a calidad (valores ilustrativos)', fontsize = 16)
ax.grid(color = '#e1e0d9', linewidth = 0.8)
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
                   usd_100  minutos_100  vram_gb  calidad
SDXL base 1.0       0.0100      20.0000        8   2.9167
FLUX.1 schnell      0.0067      13.3333       12   3.8750
FLUX.1 dev          0.0500     100.0000       12   3.9167
Stable Image Core   3.0000      10.0000        0   3.1667
API, 80 portadas al mes: 2.4 USD
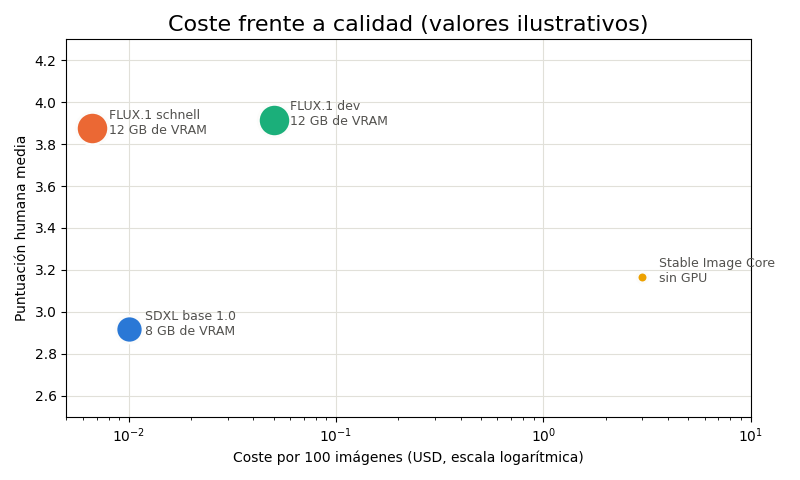
Con estos supuestos, $100$ imágenes con FLUX.1 schnell cuestan $0.0067$ USD de electricidad y $13$ minutos de espera; con FLUX.1 dev, $0.05$ USD y $100$ minutos; con Stable Image Core, $3.00$ USD y unos $10$ minutos. La escala horizontal es logarítmica porque los costes abarcan casi tres órdenes de magnitud: la API cuesta unas $450$ veces más que schnell por imagen. El tamaño de cada punto es proporcional a la VRAM que exige, y la API, sin GPU, aparece como el punto más pequeño.
La figura deja ver la frontera de la decisión. FLUX.1 schnell está arriba a la izquierda: casi la mejor calidad al menor coste. FLUX.1 dev añade una ganancia mínima de calidad a cambio de siete veces más electricidad y ocho veces más tiempo. La API es la opción cara, pero también la única que no depende de la laptop de Sofía. Si Sofía generara $80$ candidatas al mes con la API, pagaría $2.4$ USD, casi la cuarta parte de su presupuesto de $10$ USD.
Recuerde que el coste local no incluye la compra de la tarjeta gráfica ni su desgaste. Si Sofía no tuviera GPU, la comparación cambiaría por completo: comprar una tarjeta para generar unas decenas de portadas al mes no se amortiza frente a $0.03$ USD por imagen.
Matriz de decisión ponderada
Para combinar criterios heterogéneos, Sofía usa una matriz de decisión ponderada: puntúa cada herramienta de $1$ a $5$ en cada criterio, asigna un peso a cada criterio según su importancia y suma:
$$ S_h = \sum_{c} w_c , x_{h,c}, \qquad \sum_{c} w_c = 1 $$
La lógica de la fórmula es la siguiente:
- $x_{h,c}$ es la nota de la herramienta $h$ en el criterio $c$, en una escala común de $1$ a $5$ para que los criterios se puedan sumar.
- $w_c$ es el peso del criterio. Sofía asigna $0.30$ a la calidad, $0.20$ al coste, $0.20$ a la licencia y $0.15$ al hardware y a la velocidad. Los pesos suman $1$, de modo que $S_h$ también queda entre $1$ y $5$.
- La calidad no se inventa: es la puntuación humana media redondeada. Las demás notas traducen la Tabla 1 y la Tabla 2 a la escala común (por ejemplo, licencia $5$ para Apache 2.0 y $2$ para la no comercial de dev).
- En conclusión, la matriz hace explícito lo que suele quedarse implícito: qué importa y cuánto. Si alguien discrepa de la decisión, puede discutir un peso concreto en lugar de una impresión.
El siguiente bloque calcula la matriz y, como los pesos son subjetivos, repite el cálculo con $10,000$ juegos de pesos aleatorios alrededor de los de Sofía (una distribución de Dirichlet) para ver si la ganadora cambia:
# Matriz de decisión ponderada y análisis de sensibilidad en Python:
pesos = pd.Series({'calidad': 0.30, 'coste': 0.20, 'licencia': 0.20, 'hardware': 0.15, 'velocidad': 0.15})
notas_criterio = pd.DataFrame({
    'calidad': medias.round(1),
    'coste': [5, 5, 4, 2],
    'licencia': [4, 5, 2, 4],
    'hardware': [4, 3, 2, 5],
    'velocidad': [4, 5, 2, 4],
}, index = HERRAMIENTAS)
notas_criterio['total'] = notas_criterio[pesos.index] @ pesos
print(notas_criterio.sort_values('total', ascending = False).round(3).to_string())

# ¿Cambia la ganadora si los pesos se mueven? 10 000 pesos al azar alrededor de los de Sofía:
muestras = rng.dirichlet(pesos.to_numpy() * 20, size = 10_000)
totales = notas_criterio[pesos.index].to_numpy() @ muestras.T
ganadoras = pd.Series(np.array(HERRAMIENTAS)[totales.argmax(axis = 0)]).value_counts(normalize = True)
print((ganadoras * 100).round(1).to_string())
                   calidad  coste  licencia  hardware  velocidad  total
FLUX.1 schnell         3.9      5         5         3          5   4.37
SDXL base 1.0          2.9      5         4         4          4   3.87
Stable Image Core      3.2      2         4         5          4   3.51
FLUX.1 dev             3.9      4         2         2          2   2.97
FLUX.1 schnell       99.1
Stable Image Core     0.7
SDXL base 1.0         0.2
El resultado se resume en la Tabla 4.
Tabla 4. Matriz de decisión ponderada de Sofía (notas de 1 a 5; la calidad procede de la evaluación humana de juguete).
| Herramienta | Calidad (0.30) | Coste (0.20) | Licencia (0.20) | Hardware (0.15) | Velocidad (0.15) | Total |
|---|---|---|---|---|---|---|
| FLUX.1 schnell | 3.9 | 5 | 5 | 3 | 5 | 4.37 |
| SDXL base 1.0 | 2.9 | 5 | 4 | 4 | 4 | 3.87 |
| Stable Image Core | 3.2 | 2 | 4 | 5 | 4 | 3.51 |
| FLUX.1 dev | 3.9 | 4 | 2 | 2 | 2 | 2.97 |
FLUX.1 schnell gana con $4.37$ puntos, medio punto por delante de SDXL ($3.87$). FLUX.1 dev, empatada con schnell en calidad, queda la última con $2.97$: lo que gana en detalle lo pierde en licencia, hardware y velocidad. El análisis de sensibilidad confirma que la decisión es robusta: schnell gana en el $99.1%$ de los $10,000$ juegos de pesos alternativos, Stable Image Core en el $0.7%$ y SDXL en el $0.2%$. Para que dev ganara, Sofía tendría que dar a la calidad un peso desproporcionado y, además, que dev fuera claramente mejor en calidad, cosa que la evaluación no muestra.
¿Por qué el respaldo es la API y no SDXL, que quedó segunda? Porque un respaldo sirve para cuando falla la opción principal, y las dos herramientas locales fallan a la vez: si la laptop está en reparación, si la GPU está ocupada entrenando otro modelo o si Sofía viaja con una computadora sin tarjeta gráfica, SDXL tampoco funciona. Stable Image Core no comparte ese punto de fallo. Un buen respaldo no es la segunda mejor opción, sino la mejor opción que falla por razones distintas. La decisión documentada queda así: FLUX.1 schnell local como herramienta principal y Stable Image Core como respaldo, con un tope de gasto en la API dentro del presupuesto mensual.
Consideraciones finales
La comparativa de hoy tiene límites que conviene declarar. Las puntuaciones humanas, los tiempos, la VRAM y los consumos son de juguete o ilustrativos; el método es lo que se puede reutilizar, no las cifras. Las versiones de los modelos cambian rápido, y la conclusión de octubre de 2026 puede no valer dentro de seis meses. Y ocho portadas de un único prompt solo dicen algo sobre ese tipo de portada: un prompt con texto dentro de la imagen, por ejemplo, podría favorecer a FLUX.1 dev con claridad.
Antes de adoptar una herramienta en su propio proyecto, hágase estas preguntas:
- ¿Qué licencia tiene el modelo y qué dice sobre el uso comercial, las restricciones de uso y las salidas?
- ¿La evaluación fue ciega, con varios jueces y con más de una semilla por herramienta?
- ¿El acuerdo entre jueces es suficiente para que las diferencias entre herramientas signifiquen algo?
- ¿Cuánto cuesta de verdad cada imagen en su equipo, incluido su tiempo de espera?
- ¿Su respaldo falla por razones distintas que su opción principal?
Un gran libro que habla de esto es Modos de ver (o Ways of Seeing), en el que John Berger muestra que la forma en que miramos una imagen depende de lo que sabemos, de lo que esperamos y del contexto en el que la vemos. Escrito en 1972, mucho antes de la IA generativa, explica mejor que cualquier métrica por qué una evaluación ciega cambia lo que se ve, y por qué ningún número sustituye a la pregunta de para quién y para qué es la imagen.
La mejor herramienta de generación de imágenes no es la que produce la imagen más impresionante, sino la que usted puede usar legalmente, pagar sin esfuerzo y evaluar con honestidad. Para el Cuaderno Vivo, esa herramienta resultó ser un modelo destilado de cuatro pasos con licencia Apache 2.0, y no el modelo más grande ni el servicio más cómodo.
Conclusiones clave
Herramientas
- SDXL base 1.0 es la opción madura con mayor ecosistema; FLUX.1 schnell genera en $4$ pasos con
guidance_scale=0.0; FLUX.1 dev da más detalle con unos $50$ pasos; Stable Image Core no exige GPU y cuesta $0.03$ USD por imagen. - La misma semilla y el mismo prompt hacen justa la comparación, pero la reproducibilidad de una API depende de que el proveedor no cambie su modelo.
- Con los supuestos del día, $100$ imágenes cuestan $0.0067$ USD de electricidad con schnell y $3.00$ USD con la API.
Licencias
- “Pesos descargables” no significa “uso libre”: Apache 2.0, CreativeML Open RAIL++-M y la licencia no comercial de FLUX.1 dev forman un espectro.
- Cuatro preguntas bastan para leer una licencia: uso comercial, atribución, restricciones de uso y propiedad de las salidas.
- El modelo y sus salidas pueden tener reglas distintas, como en FLUX.1 dev, y ninguna licencia le exime de las leyes sobre lo que genera.
Evaluación
- CLIPScore es un coseno recortado y reescalado por $w = 2.5$; mide fidelidad al texto, no estética.
- El FID compara gaussianas de características y está sesgado con muestras pequeñas: dos muestras de la misma gaussiana dieron $0.0985$ con $50$ puntos y $0.0014$ con $5,000$.
- Una evaluación humana ciega con tres jueces dio un acuerdo medio de $\rho = 0.539$ y un empate práctico entre las dos FLUX ($3.917$ y $3.875$).
- Claude con visión sirve como crítico auxiliar ciego con rúbrica, nunca como juez final.
- La matriz ponderada eligió FLUX.1 schnell con $4.37$ puntos y en el $99.1%$ de los pesos alternativos; el respaldo es la API porque falla por razones distintas.
Mañana, en el Día 12: Mini proyecto: portadas y guía de estilo del Cuaderno Vivo. Con la herramienta ya elegida, Sofía convertirá sus decisiones visuales en un archivo estilo.json con paleta y reglas de composición, generará las portadas semanales con FLUX.1 schnell, les añadirá el título y la etiqueta “Generado con IA” y cerrará el módulo 3/6 antes de que el Cuaderno Vivo aprenda a hablar en el módulo 4/6, IA Sonora, Clonación Vocal y Ética.
Referencias
- Hessel, J., Holtzman, A., Forbes, M., Le Bras, R. y Choi, Y. (2021). CLIPScore: A Reference-free Evaluation Metric for Image Captioning. Proceedings of EMNLP 2021.
- Heusel, M., Ramsauer, H., Unterthiner, T., Nessler, B. y Hochreiter, S. (2017). GANs Trained by a Two Time-Scale Update Rule Converge to a Local Nash Equilibrium. Advances in Neural Information Processing Systems 30 (NeurIPS 2017).
- Podell, D., English, Z., Lacey, K., Blattmann, A., Dockhorn, T., Müller, J., Penna, J. y Rombach, R. (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis. arXiv:2307.01952.
- Radford, A., Kim, J. W., Hallacy, C. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. Proceedings of ICML 2021.
- Spearman, C. (1904). The Proof and Measurement of Association between Two Things. The American Journal of Psychology, 15(1), 72-101.
- Berger, J. (1972). Ways of Seeing. BBC y Penguin Books.
- Black Forest Labs (2024). FLUX.1 [schnell] y FLUX.1 [dev], fichas de modelo y licencias. Hugging Face. https://huggingface.co/black-forest-labs/FLUX.1-schnell
- Stability AI (2023). Stable Diffusion XL base 1.0, ficha de modelo. Hugging Face. https://huggingface.co/stabilityai/stable-diffusion-xl-base-1.0
- Stability AI (2026). Referencia de la API para desarrolladores: Stable Image Core. https://platform.stability.ai/docs/api-reference