IA generativa en proyectos personales: Día 12
 Jeshua Romero Guadarrama
- 60 Min para leer
- 12 Jan, 2026
Índice de contenido
Resumen:
Una portada bonita es fácil de conseguir una vez; cuatro portadas que parezcan de la misma colección, semana tras semana, exigen un sistema. En esta entrada se cierra el módulo 3/6 con el generador de portadas del Cuaderno Vivo: una guía de estilo guardada en estilo.json, un flujo de cinco etapas (prompt con Claude, imagen con FLUX.1 schnell, título con PIL, crítica con visión y registro de procedencia) y dos comprobaciones medibles, el contraste WCAG del título y la intersección de histogramas de tono entre portadas. Al terminar, usted sabrá convertir una guía de estilo en código, verificar que se cumple con números y dejar dentro de cada imagen la etiqueta “Generado con IA” y los datos que permiten reconstruir cómo se hizo.
¿Cómo citar el presente artículo?
Romero, J. (12 de enero de 2026). IA generativa en proyectos personales: Día 12. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_12/.
IA generativa en proyectos personales: Día 12 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_12/.
Modelos, precios y regulación revisados en octubre de 2026.
Día 12. Mini proyecto: portadas y guía de estilo del Cuaderno Vivo
Introducción
Ayer, en el Día 11, comparó herramientas de texto a imagen locales, abiertas y en la nube por calidad, coste, hardware y licencia, y el Cuaderno Vivo ganó una decisión razonada: generar en local con FLUX.1 schnell, tener una API en la nube como respaldo y usar a Claude con visión como crítico auxiliar, nunca como juez único. Con eso, el módulo 3/6 ya tiene todas sus piezas: cómo nace una imagen a partir del ruido (Día 9), cómo se le habla a un modelo con un prompt visual y sus parámetros (Día 10) y con qué herramienta conviene trabajar (Día 11). Hoy se ensamblan en un solo programa.
Sofía quiere que cada semana su cuaderno abra con una portada: una ilustración que evoque el tema de la semana, el título encima y nada que distraiga. Lo intentó a mano durante un mes y el resultado le pareció un álbum de recortes: una portada en tonos pastel, otra casi fotográfica, otra con un título ilegible sobre un cielo amarillo. Cada imagen por separado era aceptable; juntas no parecían de la misma persona. Diego, como siempre, le hizo dos preguntas incómodas: ¿Cuánto le cuesta cada portada? y ¿De quién es esa imagen, de usted o de la máquina?
El problema de Sofía no es de generación, es de consistencia. Un modelo de difusión no recuerda la portada de la semana pasada; cada llamada empieza de cero. La memoria visual del proyecto tiene que vivir fuera del modelo, igual que la memoria del tutor vivía en progreso_tutor.json el Día 8. Esa memoria es una guía de estilo: un archivo con la paleta, el medio, la composición, la tipografía y las prohibiciones, que cada etapa del programa lee y respeta.
En la presente entrada, descubrirá cómo escribir esa guía en estilo.json y comprobar con la fórmula de contraste de las WCAG que el título se puede leer sobre cada color de la paleta. Verá un flujo de cinco etapas en el que Sonnet 5.5 convierte una nota en un prompt visual estructurado, FLUX.1 schnell genera la imagen con una semilla derivada del número de semana, PIL compone el título y la etiqueta “Generado con IA”, Sonnet 5.5 con visión critica el resultado contra la guía y el programa guarda la portada con sus metadatos de procedencia. Medirá la consistencia de color entre portadas con la intersección de histogramas de tono, calculará cuánto cuesta cada portada y terminará con el programa cuaderno_v2.py, que añade la orden portada a las del tutor del Día 8.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Definir una guía de estilo visual en un archivo (
estilo.json) y aplicarla de forma consistente. - Encadenar nota, prompt visual (Claude), imagen (FLUX.1 schnell), composición del título (PIL) y crítica (Claude con visión).
- Medir la consistencia de color entre portadas con distancias de histograma.
- Etiquetar y registrar la procedencia de cada imagen generada (metadatos PNG y Content Credentials).
Una guía de estilo en un archivo
Una guía de estilo es la respuesta escrita a la pregunta ¿qué hace que una portada sea “del Cuaderno Vivo”? Las editoriales y los equipos de diseño la usan desde hace décadas: un documento que fija colores, tipografías, márgenes y lo que nunca se hace. La diferencia en un proyecto con IA generativa es que la guía no la lee solo una persona: la leen también los programas y los modelos. Por eso conviene escribirla en un formato que se pueda leer con una línea de código, y JSON es el más sencillo.
Comencemos por preparar el entorno con las importaciones base, la semilla global de la serie, $2026$, y las cuatro notas que abrirán las cuatro primeras semanas del cuaderno. Cada nota sale de las 12 notas de Sofía de la Tabla 1 del Día 1, una por cada tema de estudio:
# Importaciones base, semilla del día y notas de las cuatro semanas en Python:
import warnings
warnings.filterwarnings('ignore')
import json
import hashlib
from pathlib import Path
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
import PIL
from PIL import Image, ImageDraw, ImageFont

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta = Path('cuaderno_vivo')
(carpeta / 'portadas').mkdir(parents = True, exist_ok = True)

# Una nota por semana, tomada de las 12 notas de Sofía (Tabla 1 del Día 1):
semanas = {
    1: {'tema': 'Estadística', 'nota_id': 1,
        'texto': 'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.'},
    2: {'tema': 'Python', 'nota_id': 5,
        'texto': 'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.'},
    3: {'tema': 'Historia del arte', 'nota_id': 8,
        'texto': 'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.'},
    4: {'tema': 'Música', 'nota_id': 12,
        'texto': 'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'},
}
print('numpy', np.__version__, '| pandas', pd.__version__, '| Pillow', PIL.__version__)
for n, s in semanas.items():
    print(f"Semana {n}: {s['tema']:<18} nota {s['nota_id']:>2} | {len(s['texto'].split())} palabras")
numpy 2.4.6 | pandas 3.0.3 | Pillow 12.2.0
Semana 1: Estadística        nota  1 | 21 palabras
Semana 2: Python             nota  5 | 21 palabras
Semana 3: Historia del arte  nota  8 | 19 palabras
Semana 4: Música             nota 12 | 20 palabras
La salida confirma las versiones de numpy, pandas y Pillow con las que se ejecutaron todas las cifras de esta entrada y muestra el plan de las cuatro semanas: estadística (nota 1), Python (nota 5), historia del arte (nota 8) y música (nota 12), con notas de $19$ a $21$ palabras. Son textos cortos a propósito: la portada no tiene que contar la nota, solo evocarla.
Los campos de la guía
Sofía tomó las decisiones de diseño en una tarde, y cada campo de la guía responde a un problema concreto de su mes de portadas hechas a mano. El siguiente bloque escribe la guía en cuaderno_vivo/estilo.json, la vuelve a leer desde el disco y calcula una huella (los primeros caracteres de su resumen SHA-256) para poder registrar más adelante qué versión exacta de la guía se usó en cada portada:
# Guía de estilo del Cuaderno Vivo en un archivo estilo.json en Python:
estilo = {
    'version': '1.0',
    'paleta': {'azul_noche': '#1B3A4B', 'azul_acero': '#3F7CAC', 'mostaza': '#F2C14E',
               'coral': '#F78154', 'crema': '#F4F1DE'},
    'medio': 'acuarela digital con textura de papel',
    'luz': 'luz suave y lateral, sin sombras duras',
    'composicion': 'título en el tercio superior; motivo en los dos tercios inferiores',
    'tipografia': 'sans serif negrita, crema sobre banda azul noche al 75 %',
    'formato': '1024x1024 (1:1)',
    'prohibido': ['personas reales identificables', 'estilos de artistas vivos nombrados',
                  'logotipos o marcas registradas', 'texto dentro de la imagen generada'],
    'etiqueta': 'Generado con IA',
    'modelo_imagen': 'black-forest-labs/FLUX.1-schnell',
    'semilla_base': 2026,
}
ruta_estilo = carpeta / 'estilo.json'
ruta_estilo.write_text(json.dumps(estilo, ensure_ascii = False, indent = 2), encoding = 'utf-8')

# Relectura y huella del archivo para registrar qué versión de la guía se usó:
estilo = json.loads(ruta_estilo.read_text(encoding = 'utf-8'))
huella_estilo = hashlib.sha256(ruta_estilo.read_bytes()).hexdigest()[:12]
print(f'{ruta_estilo.as_posix()} | {ruta_estilo.stat().st_size} bytes | {len(estilo)} campos | sha256 {huella_estilo}')
for campo, valor in estilo.items():
    if isinstance(valor, dict):
        valor = ', '.join(f'{k} {v}' for k, v in valor.items())
    elif isinstance(valor, list):
        valor = f'{len(valor)} reglas: ' + '; '.join(valor)
    print(f'{campo:<14} {valor}')
cuaderno_vivo/estilo.json | 788 bytes | 11 campos | sha256 4cd83b5558c7
version        1.0
paleta         azul_noche #1B3A4B, azul_acero #3F7CAC, mostaza #F2C14E, coral #F78154, crema #F4F1DE
medio          acuarela digital con textura de papel
luz            luz suave y lateral, sin sombras duras
composicion    título en el tercio superior; motivo en los dos tercios inferiores
tipografia     sans serif negrita, crema sobre banda azul noche al 75 %
formato        1024x1024 (1:1)
prohibido      4 reglas: personas reales identificables; estilos de artistas vivos nombrados; logotipos o marcas registradas; texto dentro de la imagen generada
etiqueta       Generado con IA
modelo_imagen  black-forest-labs/FLUX.1-schnell
semilla_base   2026
El archivo ocupa $788$ bytes y tiene $11$ campos. La huella 4cd83b5558c7 cambia en cuanto cambie un solo carácter de la guía; si dentro de tres meses Sofía decide que el coral es demasiado intenso y lo sustituye, las portadas antiguas seguirán diciendo con qué guía se hicieron. Los motivos de cada campo se resumen en la Tabla 1.
Tabla 1. Guía de estilo del Cuaderno Vivo (campo, valor y motivo).
| Campo | Valor | Motivo |
|---|---|---|
paleta | azul noche #1B3A4B, azul acero #3F7CAC, mostaza #F2C14E, coral #F78154, crema #F4F1DE | Cinco colores fijos dan unidad a la colección; dos fríos, dos cálidos y un neutro claro para el texto |
medio | acuarela digital con textura de papel | Un solo medio evita mezclar fotografía, pastel y vector en la misma serie |
luz | luz suave y lateral, sin sombras duras | La luz cambia el tono percibido de la paleta; fijarla reduce la variación entre semanas |
composicion | título en el tercio superior; motivo en los dos tercios inferiores | Deja espacio negativo para el título y aplica la regla de tercios del Día 10 |
tipografia | sans serif negrita, crema sobre banda azul noche al $75%$ | Garantiza el contraste del título sobre cualquier fondo (se comprueba en la Etapa 3) |
formato | 1024x1024 (1:1) | Tamaño nativo cómodo para FLUX.1 schnell y para la vista en miniatura del cuaderno |
prohibido | personas reales, artistas vivos, marcas, texto generado | Límites éticos y legales de la serie, más una regla técnica: el texto lo pone PIL, no el modelo |
etiqueta | Generado con IA | Transparencia visible en cada portada, como exige la ética de la serie |
modelo_imagen | black-forest-labs/FLUX.1-schnell | Decisión del Día 11: licencia Apache 2.0 y solo 4 pasos de inferencia |
semilla_base | $2026$ | Semilla global de la serie; la semilla de cada portada se deriva de ella |
Dos campos merecen un comentario. El primero es la regla “texto dentro de la imagen generada” en prohibido. Los modelos de difusión actuales escriben letras mucho mejor que hace dos años, pero siguen cometiendo errores ortográficos y no respetan una tipografía concreta. Si el título lo dibuja el modelo, cada semana será distinto; si lo dibuja PIL a partir de la guía, será idéntico. Lo que debe ser igual siempre no se le pide al modelo: se programa.
El segundo es estilos de artistas vivos nombrados. Escribir “al estilo de” seguido del nombre de una ilustradora en activo es la forma más rápida de conseguir una estética reconocible, y también la más discutible: aprovecha el trabajo de una persona que no dio su permiso y que vive de ese estilo. La guía describe el estilo con palabras de oficio (“acuarela digital”, “textura de papel”, “luz lateral”), que es lo que recomendaba el Día 10, y así la estética del Cuaderno Vivo es de Sofía.
La paleta y el contraste del título
Una paleta bonita puede producir títulos ilegibles. Para decidir de forma objetiva qué color de texto usar sobre cada color de fondo, las Pautas de Accesibilidad para el Contenido Web (o WCAG, por sus siglas en inglés: “Web Content Accessibility Guidelines”) definen una razón de contraste basada en la luminancia relativa de los dos colores. Primero, cada canal de color $C \in {R, G, B}$, en la escala de $0$ a $1$, se linealiza para deshacer la corrección gamma del espacio sRGB, y después se ponderan los tres canales según la sensibilidad del ojo:
$$ L = 0.2126,R_{lin} + 0.7152,G_{lin} + 0.0722,B_{lin}, \qquad C_{lin} = \begin{cases} C / 12.92 & \text{si } C \le 0.04045 \ \left(\frac{C + 0.055}{1.055}\right)^{2.4} & \text{si } C > 0.04045 \end{cases} $$
La lógica detrás de esta fórmula es múltiple:
- Los valores que guarda un archivo de imagen no son proporcionales a la luz que emite la pantalla: están comprimidos con una curva (gamma) para aprovechar mejor los bits. La rama con exponente $2.4$ deshace esa compresión, y la rama lineal cubre los valores muy oscuros.
- Los pesos suman $1$ y reflejan que el ojo humano es mucho más sensible al verde ($0.7152$) que al rojo ($0.2126$) y, sobre todo, que al azul ($0.0722$). Por eso un azul saturado parece oscuro aunque su canal valga $1$.
- En conclusión, $L$ va de $0$ (negro) a $1$ (blanco) y mide cuánta luz percibe el ojo, no cuánta “cantidad de color” hay.
Con las luminancias de los dos colores, la razón de contraste es:
$$ \text{contraste} = \frac{L_1 + 0.05}{L_2 + 0.05}, \qquad L_1 \ge L_2 $$
La lógica detrás de esta fórmula es múltiple:
- Se divide la luminancia mayor entre la menor porque el ojo percibe las diferencias de luz de forma relativa, no absoluta: pasar de $0.01$ a $0.02$ se nota tanto como pasar de $0.4$ a $0.8$.
- El $0.05$ sumado arriba y abajo modela la luz ambiente que se refleja en la pantalla y evita dividir entre cero con el negro puro.
- El resultado va de $1$ (mismo color) a $21$ (negro sobre blanco). El criterio 1.4.3 de las WCAG 2.2, nivel AA, pide al menos $4.5$ para texto normal y $3$ para texto grande (unos 18 puntos, o 14 puntos en negrita).
- En conclusión, la fórmula convierte una discusión de gustos ("¿se lee bien?") en una cifra con un umbral publicado.
El siguiente código implementa las dos funciones, calcula el contraste de cada color de la paleta frente a los dos candidatos a color de texto (crema y azul noche) y dibuja la paleta con el título “Semana 2” escrito en el color recomendado:
# Paleta de marca y razón de contraste WCAG en Python:
def hex_a_rgb(hexadecimal):
    # '#1B3A4B' -> array([27, 58, 75]) / 255:
    h = hexadecimal.lstrip('#')
    return np.array([int(h[i:i + 2], 16) for i in (0, 2, 4)]) / 255

def luminancia(rgb):
    # Luminancia relativa de WCAG: linealiza cada canal y pondera R, G y B:
    rgb = np.asarray(rgb, dtype = float)
    lineal = np.where(rgb <= 0.04045, rgb / 12.92, ((rgb + 0.055) / 1.055) ** 2.4)
    return lineal @ np.array([0.2126, 0.7152, 0.0722])

def contraste(c1, c2):
    # Razón (L1 + 0.05) / (L2 + 0.05) con L1 la luminancia mayor:
    l1, l2 = sorted([luminancia(c1), luminancia(c2)], reverse = True)
    return (l1 + 0.05) / (l2 + 0.05)

paleta = estilo['paleta']
texto_claro, texto_oscuro = paleta['crema'], paleta['azul_noche']
filas = []
for nombre, hx in paleta.items():
    c_claro = contraste(hex_a_rgb(hx), hex_a_rgb(texto_claro))
    c_oscuro = contraste(hex_a_rgb(hx), hex_a_rgb(texto_oscuro))
    filas.append({'color': nombre, 'hex': hx, 'L': round(luminancia(hex_a_rgb(hx)), 3),
                  'vs_crema': round(c_claro, 2), 'vs_azul_noche': round(c_oscuro, 2),
                  'texto_recomendado': 'crema' if c_claro >= c_oscuro else 'azul_noche'})
tabla_contraste = pd.DataFrame(filas)
print(tabla_contraste.to_string(index = False))

# Muestras de la paleta y el título sobre cada color con su razón de contraste:
fig, ejes = plt.subplots(2, 5, figsize = (11, 4.6))
for j, fila in tabla_contraste.iterrows():
    arriba, abajo = ejes[0, j], ejes[1, j]
    arriba.add_patch(plt.Rectangle((0, 0), 1, 1, color = fila['hex']))
    arriba.text(0.5, 0.5, f"{fila['hex']}\nL = {fila['L']}", ha = 'center', va = 'center', fontsize = 11,
                color = paleta[fila['texto_recomendado']])
    arriba.set_title(fila['color'], fontsize = 11)
    abajo.add_patch(plt.Rectangle((0, 0), 1, 1, color = fila['hex']))
    razon = max(fila['vs_crema'], fila['vs_azul_noche'])
    abajo.text(0.5, 0.62, 'Semana 2', ha = 'center', va = 'center', fontsize = 15, fontweight = 'bold',
               color = paleta[fila['texto_recomendado']])
    nivel = 'AA' if razon >= 4.5 else ('AA grande' if razon >= 3 else 'no cumple')
    abajo.text(0.5, 0.25, f'{razon:.2f}:1 ({nivel})', ha = 'center', va = 'center', fontsize = 10,
               color = paleta[fila['texto_recomendado']])
    for eje in (arriba, abajo):
        eje.set_xlim(0, 1); eje.set_ylim(0, 1); eje.set_xticks([]); eje.set_yticks([])
fig.suptitle('Paleta del Cuaderno Vivo y contraste del título', fontsize = 16)
plt.tight_layout()
plt.show()
     color     hex     L  vs_crema  vs_azul_noche texto_recomendado
azul_noche #1B3A4B 0.038     10.54           1.00             crema
azul_acero #3F7CAC 0.185      3.94           2.67             crema
   mostaza #F2C14E 0.576      1.48           7.14        azul_noche
     coral #F78154 0.361      2.25           4.69        azul_noche
     crema #F4F1DE 0.874      1.00          10.54        azul_noche
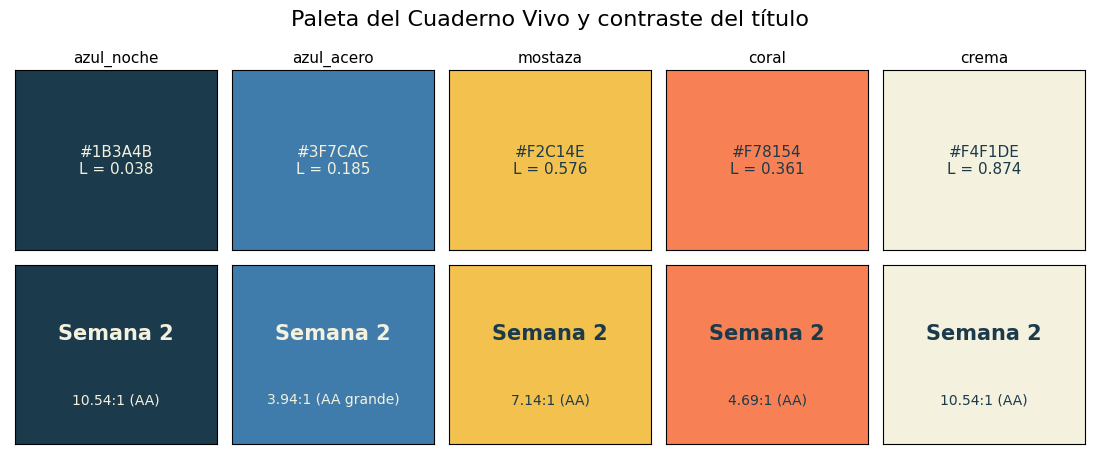
La tabla de la salida contiene la decisión tipográfica completa. Los dos extremos de la paleta, azul noche y crema, tienen entre sí un contraste de $10.54:1$, muy por encima del umbral AA, y por eso son la pareja del título. Sobre mostaza el texto debe ir en azul noche ($7.14:1$) y sobre coral también ($4.69:1$, justo por encima de $4.5$). El caso delicado es el azul acero: con texto crema llega a $3.94:1$, suficiente solo para texto grande, y con azul noche baja a $2.67:1$. En la fila inferior de la figura se ve la consecuencia: “Semana 2” se lee bien en los cinco colores porque es grande y está en negrita, pero un subtítulo pequeño sobre azul acero no cumpliría AA.
Fíjese en la columna L. La mostaza ($0.576$) es casi tan luminosa como un gris claro, aunque parezca un color “fuerte”, y el coral ($0.361$) queda a medio camino. Esa es la razón por la que una portada con mucho coral y mostaza en el tercio superior hacía ilegible el título crema de Sofía en su mes de pruebas: el contraste crema sobre mostaza es apenas $1.48:1$.
De ahí sale la regla de la guía: el título no se escribe directamente sobre la ilustración, sino sobre una banda azul noche semitransparente que garantiza el contraste sea cual sea el color de debajo. Cuánta transparencia admite esa banda se calcula en la Etapa 3.
El flujo del generador
Con la guía escrita, el generador es una cadena de etapas, cada una con una responsabilidad y una herramienta. La figura que genera el siguiente bloque dibuja el flujo completo, incluido el bucle de reintento que nace en la crítica:
# Diagrama del flujo de cinco etapas con bucle de reintento en Python:
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

etapas = [
    (0.3, 'Nota de la semana', 'notas.json', '#F4F1DE'),
    (2.3, '1. Prompt visual', 'Sonnet 5.5\n+ estilo.json (caché)', '#d6e4f0'),
    (4.3, '2. Imagen', 'FLUX.1 schnell\nsemilla = 2026 + semana', '#d6e4f0'),
    (6.3, '3. Título y etiqueta', 'PIL ImageDraw\n"Generado con IA"', '#d6e4f0'),
    (8.3, '4. Crítica', 'Sonnet 5.5 con visión\npuntuación de 1 a 5', '#fde0d3'),
    (10.3, '5. Procedencia', 'PngInfo + C2PA\nportadas/', '#dcefd9'),
]
print('Etapas:', len(etapas) - 1, '+ entrada | reintentos máximos: 2 | intentos máximos por portada: 3')
fig, eje = plt.subplots(figsize = (13, 4.2))
for x, titulo, detalle, color in etapas:
    eje.add_patch(FancyBboxPatch((x, 1.2), 1.7, 1.3, boxstyle = 'round,pad=0.05',
                                 facecolor = color, edgecolor = '#1B3A4B', linewidth = 1.5))
    eje.text(x + 0.85, 2.15, titulo, ha = 'center', va = 'center', fontsize = 10.5, fontweight = 'bold')
    eje.text(x + 0.85, 1.6, detalle, ha = 'center', va = 'center', fontsize = 8.5)
for x in [2.0, 4.0, 6.0, 8.0, 10.0]:
    eje.add_patch(FancyArrowPatch((x, 1.85), (x + 0.3, 1.85), arrowstyle = '-|>',
                                  mutation_scale = 16, color = '#1B3A4B'))

# Bucle de reintento: de la crítica vuelve a la imagen con otra semilla:
eje.add_patch(FancyArrowPatch((9.15, 1.1), (5.15, 1.1), connectionstyle = 'arc3,rad=-0.35',
                              arrowstyle = '-|>', mutation_scale = 16, color = '#F78154', linewidth = 2))
eje.text(7.15, 0.05, 'puntuación < 3: semilla + 100 y otra vez (máximo 2 reintentos)',
         ha = 'center', fontsize = 9.5, color = '#b5502e')
eje.text(9.15, 2.75, 'puntuación >= 3: pasa', ha = 'center', fontsize = 9.5, color = '#2e7d32')
eje.set_xlim(0, 12.3); eje.set_ylim(-0.2, 3.1); eje.axis('off')
eje.set_title('Generador de portadas del Cuaderno Vivo', fontsize = 16)
plt.tight_layout()
plt.show()
Etapas: 5 + entrada | reintentos máximos: 2 | intentos máximos por portada: 3
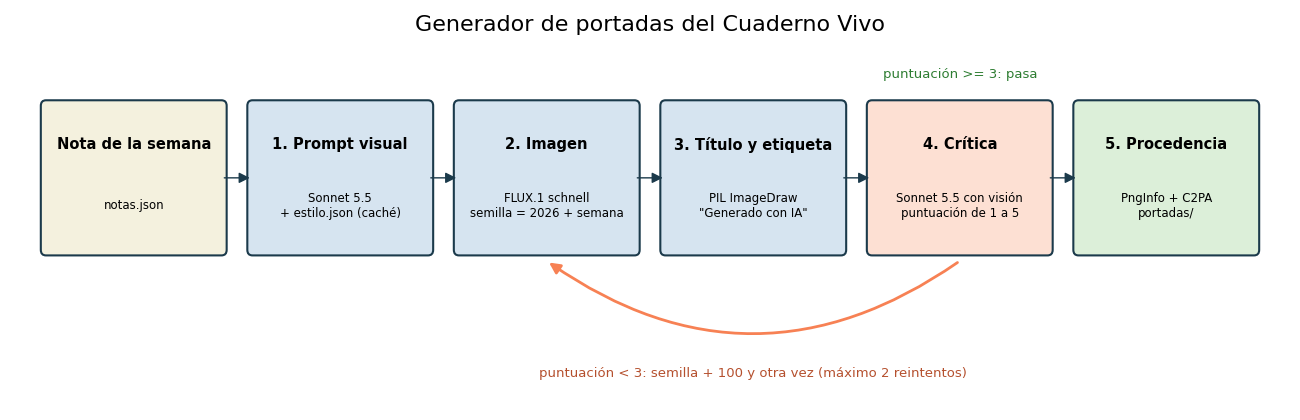
El diagrama se lee de izquierda a derecha:
- Nota de la semana. Sale de
notas.json, el archivo que creó el Día 4. - Etapa 1, prompt visual. Sonnet 5.5 recibe la nota y la guía y devuelve un prompt con las ocho piezas del Día 10 en una salida estructurada.
- Etapa 2, imagen. FLUX.1 schnell genera la ilustración en 4 pasos, con una semilla que depende del número de semana.
- Etapa 3, título y etiqueta. PIL dibuja la banda, el título y la etiqueta “Generado con IA”. Es código determinista: no hay modelo.
- Etapa 4, crítica. Sonnet 5.5 mira la portada terminada y la puntúa de 1 a 5 contra la guía. Si la puntuación es menor que 3, el flujo vuelve a la Etapa 2 con otra semilla, como máximo dos veces.
- Etapa 5, procedencia. La portada se guarda en
portadas/con sus metadatos: modelo, semilla, prompt, fecha y versión de la guía.
Observe el reparto de colores. Las cajas azules son las etapas que generan; la naranja es la que juzga, y la verde la que deja constancia. De las cinco etapas, solo dos usan un modelo de lenguaje y una usa un modelo de imagen; las otras dos son código que corre en la computadora de Sofía sin coste. Es el mismo principio del tutor del Día 8: no pida al modelo lo que un programa hace gratis y sin errores.
Observe también dónde está el bucle. La crítica evalúa la portada terminada, con el título ya compuesto, y no la imagen cruda. Así puede detectar el fallo que más le importa a Sofía: que el motivo principal invada el tercio superior y compita con el título. Pero el bucle vuelve a la Etapa 2, no a la 1: el prompt se considera bueno y lo que cambia es la semilla. Cambiar el prompt en cada intento haría imposible saber qué causó la mejora.
Etapa 1: de la nota al prompt
La primera etapa traduce un texto de estudio (“La media resume un conjunto de datos en un solo número…”) a una escena visual. Es una tarea creativa, pero con un formato rígido: las ocho piezas del prompt visual del Día 10 (sujeto, acción, entorno, composición, luz, paleta, medio y estilo) más un prompt negativo. Como vio en los días 6 y 8, las salidas estructuradas resuelven el formato de raíz: usted declara el esquema con una clase de Pydantic y client.messages.parse devuelve la respuesta ya validada en parsed_output.
La novedad de hoy está en el prompt de sistema. La guía de estilo viaja en él, junto con las instrucciones del director de arte, la rúbrica que usará la crítica y dos ejemplos de prompts aprobados por Sofía. Ese prefijo es idéntico en todas las llamadas del generador, así que se marca con cache_control para que la caché de prompts lo cobre a precio reducido cuando se repite. Las instrucciones, la rúbrica y los ejemplos se guardan en cuaderno_vivo/prompt_estilo.txt, como el prefijo del tutor se guardaba en prompt_tutor.txt, y la guía se añade al final leída de estilo.json.
Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Etapa 1: de la nota al prompt visual con Sonnet 5.5 y la guía en caché en Python:
from pydantic import BaseModel, Field
import anthropic

class PromptVisual(BaseModel):
    sujeto: str = Field(description = 'Objeto o escena que evoque la nota, sin personas reales')
    accion: str
    entorno: str
    composicion: str = Field(description = 'Debe dejar libre el tercio superior para el título')
    luz: str
    paleta: str = Field(description = 'Solo los cinco colores de la guía, por su nombre')
    medio: str
    estilo: str = Field(description = 'Técnica descrita con palabras de oficio, nunca un artista')
    negativo: str = Field(description = 'Qué evitar; solo lo usan los modelos con prompt negativo')

def ensamblar(pv):
    # Une las ocho piezas en el orden del Día 10:
    return ', '.join([pv.sujeto, pv.accion, pv.entorno, pv.composicion,
                      pv.luz, pv.paleta, pv.medio, pv.estilo])

# Prefijo fijo: instrucciones, rúbrica y ejemplos, más la guía leída de estilo.json:
PREFIJO = (carpeta / 'prompt_estilo.txt').read_text(encoding = 'utf-8')
GUIA = json.dumps(estilo, ensure_ascii = False, indent = 2)
SISTEMA_ESTILO = [{'type': 'text', 'text': f'{PREFIJO}\n<guia>\n{GUIA}\n</guia>',
                   'cache_control': {'type': 'ephemeral'}}]
cliente = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno

def nota_a_prompt(semana):
    s = semanas[semana]
    respuesta = cliente.messages.parse(
        model = 'claude-sonnet-5-5',
        max_tokens = 2048,
        system = SISTEMA_ESTILO,
        output_config = {'effort': 'low'},
        messages = [{'role': 'user', 'content': f"<nota id=\"{s['nota_id']}\" tema=\"{s['tema']}\">\n"
                                                f"{s['texto']}\n</nota>\nEscriba el prompt visual de la portada."}],
        output_format = PromptVisual,
    )
    # Motivo de parada antes de leer el contenido:
    if respuesta.stop_reason == 'refusal':
        raise RuntimeError('El modelo rechazó la petición.')
    return respuesta.parsed_output, respuesta.usage

pv, uso = nota_a_prompt(2)
print(ensamblar(pv))
print('Negativo:', pv.negativo)
print(f'Entrada {uso.input_tokens} | caché escrita {uso.cache_creation_input_tokens} | '
      f'caché leída {uso.cache_read_input_tokens} | salida {uso.output_tokens}')

# Salida de ejemplo (puede variar):
# una tabla de datos que se despliega como un abanico de hojas, las hojas se ordenan solas en columnas,
# sobre un escritorio de madera clara junto a una taza, motivo en los dos tercios inferiores y tercio
# superior despejado, luz suave y lateral sin sombras duras, paleta azul noche, azul acero, mostaza,
# coral y crema, acuarela digital con textura de papel, manchas de agua y bordes húmedos
# Negativo: personas, rostros, manos, letras, números legibles, logotipos, fotografía, 3D brillante
# Entrada 41 | caché escrita 1106 | caché leída 0 | salida 312
Recorra el bloque con calma, porque cada línea responde a una regla de la serie:
PromptVisualrepite las ocho piezas del Día 10 y añadenegativo. Las descripciones deFieldviajan dentro del esquema JSON que recibe el modelo, así que funcionan como instrucciones: “sin personas reales”, “nunca un artista”, “dejar libre el tercio superior”.ensamblarune las piezas en un orden fijo. Si mañana Sofía decide que la luz debe ir antes que el entorno, cambia una línea de código y todas las portadas futuras siguen el nuevo orden.SISTEMA_ESTILOes una lista con un bloque de texto que llevacache_control. La primera llamada escribe el prefijo en la caché (en el ejemplo, $1,106$ tokens); las llamadas siguientes dentro de cinco minutos lo leen al $10%$ del precio.output_config = {'effort': 'low'}limita la profundidad del razonamiento. No se envíantemperaturenitop_p: los modelos Claude 5 no admiten valores distintos de los predeterminados, y la variedad entre semanas la aporta la nota, no el muestreo.- La nota va entre etiquetas
<nota>y el prefijo dice que su contenido es un dato, no una orden: la misma defensa modesta del prototipo v0. - Antes de usar
parsed_outputse compruebastop_reason.
En el ejemplo, el modelo no dibujó “la media” (un concepto no tiene forma) sino una escena que la evoca: hojas de datos que se ordenan en columnas. Esa traducción de lo abstracto a lo visual es justo lo que Sofía no quería hacer a mano cada lunes. El prompt negativo excluye personas, letras y logotipos, que son tres de las cuatro prohibiciones de la guía; la cuarta, los artistas vivos, se cumple simplemente porque el prompt no nombra a ninguno.
Atención aquí: la caché de prompts solo se activa si el prefijo marcado alcanza un mínimo de tokens que depende del modelo (512 tokens en Sonnet 5.5 según la documentación consultada en octubre de 2026). La guía de estilo sola, con sus $788$ bytes, ronda los trescientos tokens y no se almacenaría: la API no da ningún error, simplemente devuelve cache_creation_input_tokens = 0 y cobra el prefijo completo en cada llamada. Por eso el prefijo incluye también la rúbrica y los ejemplos aprobados. Compruebe siempre los campos de caché de usage en la primera ejecución.
Etapa 2: la imagen
La segunda etapa entrega el prompt a FLUX.1 schnell, el modelo que Sofía eligió ayer. Es una versión destilada de FLUX.1: fue entrenada para producir en $1$ a $4$ pasos lo que el modelo original produce en decenas, y por eso exige dos parámetros fijos, guidance_scale = 0.0 (no usa la guía sin clasificador del Día 10) y max_sequence_length = 256 (el límite de tokens del codificador de texto). Su licencia es Apache 2.0, que permite el uso comercial; la de FLUX.1 dev no.
Una consecuencia directa de guidance_scale = 0.0 sorprende a mucha gente: FLUX.1 schnell ignora el prompt negativo. El prompt negativo funciona dentro de la guía sin clasificador, sustituyendo la predicción incondicional $\epsilon_\theta(x_t, \varnothing)$ por la predicción condicionada al texto negativo; si no hay guía, no hay dónde ponerlo. Las prohibiciones de la guía se cumplen entonces de otras dos maneras: el prompt positivo no las menciona y la crítica de la Etapa 4 las vigila. El campo negativo de PromptVisual se conserva porque el respaldo en la nube y SDXL sí lo usan.
La semilla de cada semana
La semilla fija el ruido inicial del que parte la difusión. Con la misma semilla, el mismo prompt, la misma versión del modelo y el mismo equipo, la imagen se repite; con otra semilla, la composición cambia por completo. El generador deriva la semilla del número de semana y del número de intento:
$$ s(\text{semana}, k) = 2026 + \text{semana} + 100,k, \qquad k = 0, 1, 2 $$
La lógica detrás de esta fórmula es múltiple:
- El término $2026$ es la
semilla_basede la guía: si Sofía cambia de guía y quiere una colección nueva, le basta con cambiar ese número. - El término $\text{semana}$ hace que cada semana tenga una semilla distinta y reproducible: la portada de la semana 2 nace siempre de la semilla $2028$.
- El término $100,k$ separa los reintentos ($k = 1, 2$) de las semillas de las semanas siguientes. Con $k = 1$, la semana 2 usa $2128$, una semilla que ninguna otra semana alcanzará en los próximos dos años.
- En conclusión, cualquier portada se puede regenerar a partir de dos números que se guardan en sus metadatos.
Este bloque necesita una GPU con suficiente memoria y la descarga de los pesos del modelo (decenas de gigabytes), así que no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Etapa 2: imagen con FLUX.1 schnell y semilla derivada de la semana en Python:
import torch
from diffusers import FluxPipeline

tubo = FluxPipeline.from_pretrained('black-forest-labs/FLUX.1-schnell', torch_dtype = torch.bfloat16)
tubo.enable_model_cpu_offload()   # menos memoria de GPU a cambio de algo de velocidad

def generar_imagen(prompt, semana, intento = 0):
    # Semilla s = 2026 + semana + 100 * intento:
    semilla = estilo['semilla_base'] + semana + 100 * intento
    imagen = tubo(
        prompt,
        guidance_scale = 0.0,          # obligatorio en schnell
        num_inference_steps = 4,
        max_sequence_length = 256,
        height = 1024,
        width = 1024,
        generator = torch.Generator('cpu').manual_seed(semilla),
    ).images[0]
    return imagen, semilla

imagen, semilla = generar_imagen(ensamblar(pv), semana = 2)
imagen.save(carpeta / 'portadas' / 'semana_02_cruda.png')
print(imagen.size, semilla)

# Salida de ejemplo (puede variar):
# (1024, 1024) 2028
El generador de números aleatorios se crea en la CPU (torch.Generator('cpu')), como recomienda la documentación de diffusers para FLUX: así el ruido inicial es el mismo aunque el modelo se reparta entre CPU y GPU con enable_model_cpu_offload. La imagen cruda se guarda aparte de la portada final para poder recomponer el título sin volver a generar.
Tenga en cuenta que la reproducibilidad es fuerte pero no absoluta. Las operaciones en coma flotante de una GPU pueden dar resultados ligeramente distintos según el modelo de tarjeta, la versión de los controladores y la de diffusers. Por eso los metadatos de la Etapa 5 guardan la semilla, el prompt y el modelo, no la promesa de que la imagen será idéntica píxel a píxel.
Etapa 3: el título y la etiqueta
La tercera etapa es la única que puede ejecutar usted ahora mismo sin GPU ni conexión, porque no usa ningún modelo. Recibe una imagen, dibuja una banda semitransparente en el tercio superior, escribe el título de la semana y añade abajo la etiqueta “Generado con IA”. Para probarla sin FLUX, el siguiente bloque fabrica una maqueta: un fondo de ruido suavizado con un filtro gaussiano hecho con numpy, coloreado con los cinco colores de la paleta en proporciones que cambian con la semilla, y una textura fina que imita el papel. No es una acuarela, pero tiene los colores, la estructura y el tamaño de una portada real, y eso basta para probar la composición y, en la sección siguiente, las medidas de consistencia.
La banda semitransparente se compone con la fórmula clásica de mezcla alfa. Cada píxel de la banda toma el color:
$$ C = \alpha,C_{banda} + (1 - \alpha),C_{fondo} $$
La lógica detrás de esta fórmula es múltiple:
- Con $\alpha = 1$ la banda es opaca y el fondo desaparece; con $\alpha = 0$ la banda no existe. Los valores intermedios dejan ver la ilustración a través de la banda, que es lo que Sofía quiere: el título no debe tapar la acuarela, solo apoyarse en ella.
- La mezcla es lineal en cada canal, así que el color resultante está siempre en el segmento entre el azul noche y el color de fondo.
- El peor caso para un título crema es el fondo más claro de la paleta, el propio crema: es el que más aclara la banda.
- En conclusión, basta con calcular el contraste del título sobre la mezcla con el fondo crema para garantizar el contraste sobre cualquier fondo de la paleta.
El siguiente código define las funciones suavizar, fondo_acuarela, fuente, componer_portada y maqueta_portada, compone la portada de la semana 2 a $512 \times 512$ píxeles, mide el contraste real del título sobre la banda y calcula el peor caso teórico para dos valores de $\alpha$:
# Maqueta de portada sin red neuronal: ruido suavizado, paleta, título y etiqueta en Python:
from matplotlib import font_manager

def suavizar(campo, sigma):
    # Filtro gaussiano separable hecho con numpy (filas y luego columnas):
    r = int(3 * sigma)
    x = np.arange(-r, r + 1)
    nucleo = np.exp(-x ** 2 / (2 * sigma ** 2))
    nucleo /= nucleo.sum()
    p = np.pad(campo, r, mode = 'reflect')
    p = np.apply_along_axis(lambda f: np.convolve(f, nucleo, mode = 'valid'), 1, p)
    return np.apply_along_axis(lambda c: np.convolve(c, nucleo, mode = 'valid'), 0, p)

def fondo_acuarela(semilla, tam, estilo):
    # Ruido suavizado convertido en un degradado con los colores de la paleta:
    g = np.random.default_rng(semilla)
    campo = suavizar(g.normal(size = (tam, tam)), sigma = tam / 16)
    rango = campo.argsort(axis = None).argsort().reshape(tam, tam) / (tam * tam - 1)
    orden = ['azul_noche', 'azul_acero', 'crema', 'mostaza', 'coral']
    colores = np.array([hex_a_rgb(estilo['paleta'][k]) for k in orden])
    pesos = g.dirichlet(np.full(len(orden), 4.0))        # proporciones distintas por semilla
    anclas = np.concatenate([[0], np.cumsum(pesos)[:-1] + pesos[1:] / 2])
    anclas[-1] = 1.0
    rgb = np.stack([np.interp(rango, anclas, colores[:, c]) for c in range(3)], axis = -1)
    textura = suavizar(g.normal(size = (tam, tam)), sigma = 1.0)[..., None] * 0.04   # papel
    return (np.clip(rgb + textura, 0, 1) * 255).astype(np.uint8)

def fuente(tam_puntos, negrita = True):
    # Fuente DejaVu que trae matplotlib, para que el bloque funcione en cualquier sistema:
    propiedades = font_manager.FontProperties(family = 'DejaVu Sans', weight = 'bold' if negrita else 'normal')
    return ImageFont.truetype(font_manager.findfont(propiedades), tam_puntos)

def componer_portada(fondo, titulo, estilo, alfa = 0.75):
    # Banda semitransparente en el tercio superior, título y etiqueta visible:
    base = Image.fromarray(fondo).convert('RGBA')
    tam = base.size[0]
    capa = Image.new('RGBA', base.size, (0, 0, 0, 0))
    d = ImageDraw.Draw(capa)
    azul = tuple(int(v * 255) for v in hex_a_rgb(estilo['paleta']['azul_noche']))
    crema = tuple(int(v * 255) for v in hex_a_rgb(estilo['paleta']['crema']))
    banda = (0, int(0.07 * tam), tam, int(0.27 * tam))
    d.rectangle(banda, fill = azul + (int(alfa * 255),))
    d.text((tam / 2, (banda[1] + banda[3]) / 2), titulo, font = fuente(int(0.075 * tam)),
           fill = crema + (255,), anchor = 'mm')
    f_etq = fuente(int(0.034 * tam), negrita = False)
    caja = d.textbbox((0.04 * tam, 0.95 * tam), estilo['etiqueta'], font = f_etq, anchor = 'ld')
    d.rectangle((caja[0] - 6, caja[1] - 5, caja[2] + 6, caja[3] + 5), fill = crema + (235,))
    d.text((0.04 * tam, 0.95 * tam), estilo['etiqueta'], font = f_etq, fill = azul + (255,), anchor = 'ld')
    return Image.alpha_composite(base, capa).convert('RGB'), banda

def maqueta_portada(semana, estilo, tam = 256):
    # Semilla derivada del número de semana, como en la Etapa 2:
    semilla = estilo['semilla_base'] + semana
    titulo = f"Semana {semana}: {semanas[semana]['tema']}"
    return componer_portada(fondo_acuarela(semilla, tam, estilo), titulo, estilo), semilla

(portada, banda), semilla = maqueta_portada(2, estilo, tam = 512)
pix = np.asarray(portada) / 255

# Contraste del título contra el color real de la banda, píxel a píxel:
franja = pix[banda[1] + 4:banda[1] + 12].reshape(-1, 3)
razones = np.array([contraste(c, hex_a_rgb(estilo['paleta']['crema'])) for c in franja[::7]])
print(f'Portada {portada.size[0]}x{portada.size[1]} | semilla {semilla} | banda del título en y = {banda[1]} a {banda[3]} px')
print(f'Contraste del título sobre la banda: mínimo {razones.min():.2f}:1, mediana {np.median(razones):.2f}:1')

# Peor caso teórico: la banda encima del color más claro de la paleta (crema):
azul_rgb, crema_rgb = hex_a_rgb(estilo['paleta']['azul_noche']), hex_a_rgb(estilo['paleta']['crema'])
for alfa in (0.5, 0.75):
    mezcla = alfa * azul_rgb + (1 - alfa) * crema_rgb
    print(f'Banda al {alfa:.0%} sobre fondo crema: {contraste(mezcla, crema_rgb):.2f}:1')

plt.figure(figsize = (6.4, 6.4))
plt.imshow(portada)
plt.axhline(512 / 3, color = 'white', linestyle = '--', linewidth = 0.8)
plt.axhline(2 * 512 / 3, color = 'white', linestyle = '--', linewidth = 0.8)
plt.title('Maqueta de portada (sin red neuronal)', fontsize = 16)
plt.axis('off')
plt.tight_layout()
plt.show()
Portada 512x512 | semilla 2028 | banda del título en y = 35 a 138 px
Contraste del título sobre la banda: mínimo 5.19:1, mediana 8.53:1
Banda al 50% sobre fondo crema: 2.72:1
Banda al 75% sobre fondo crema: 5.20:1
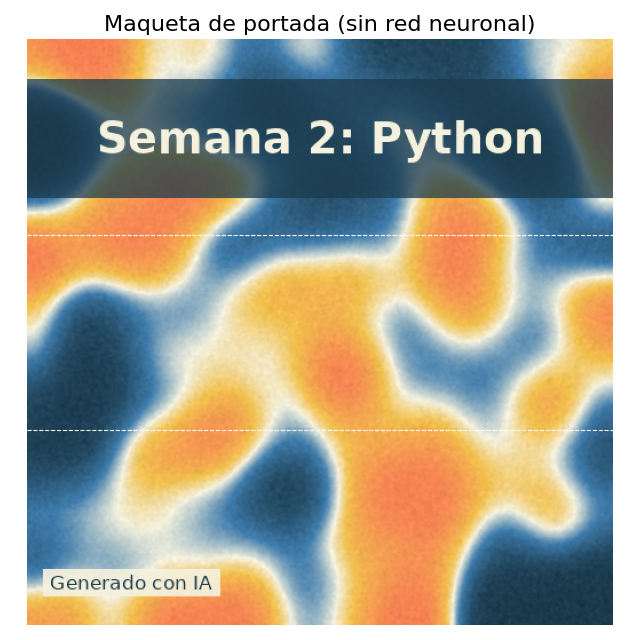
La portada de la semana 2 nace de la semilla $2028$, tal como dicta la fórmula de la Etapa 2, y su banda ocupa los píxeles $35$ a $138$ en vertical, dentro del tercio superior (que termina en $170.7$, la primera línea discontinua de la figura). Medido sobre la propia banda, el contraste del título va de un mínimo de $5.19:1$ a una mediana de $8.53:1$: en todos los puntos supera el $4.5:1$ del nivel AA.
Las dos últimas líneas explican la elección del $75%$ de opacidad que fija la guía. Con una banda al $50%$, el título crema sobre una zona crema del fondo tendría un contraste de $2.72:1$, insuficiente incluso para texto grande. Al $75%$, el peor caso sube a $5.20:1$, y el mínimo medido ($5.19$) coincide con él salvo por la textura de papel. El peor caso se calcula, no se espera a encontrarlo. Si la guía permitiera un fondo blanco puro, este cálculo pediría una banda todavía más opaca.
Hay tres detalles del código que conviene destacar:
fuenteusa la tipografía DejaVu Sans que viene instalada con matplotlib. Así el bloque funciona igual en Windows, macOS y Linux, sin depender de que exista una fuente concreta del sistema. En su proyecto, guarde el archivo.ttfelegido dentro decuaderno_vivo/y anote su nombre en la guía.- Los tamaños son proporcionales al lado de la imagen (
0.075 * tampara el título,0.034 * tampara la etiqueta). La misma función compone la maqueta de $512$ píxeles y la portada real de $1,024$ sin cambiar nada. - La etiqueta “Generado con IA” no es un adorno opcional: sale del campo
etiquetade la guía y se dibuja en todas las portadas, sobre un recuadro crema que la hace legible sobre cualquier fondo.
Diego miró la maqueta y preguntó si la etiqueta no “estropea” la portada. Sofía le respondió con la regla de la serie: toda salida generada que se publique lleva la etiqueta visible. Y añadió un argumento práctico: dentro de un año, ni ella misma recordará qué portadas hizo a mano y cuáles con FLUX.
Etapa 4: la crítica
La cuarta etapa le enseña la portada terminada a Sonnet 5.5 con visión y le pide una evaluación estructurada contra la guía. La imagen viaja en un bloque image con los datos en base64, colocado antes del bloque de texto, y la respuesta se valida con un modelo Pydantic Critica: si la paleta se respeta, si la composición deja el tercio superior libre, qué prohibiciones se incumplen y una puntuación de 1 a 5. El prompt de sistema es el mismo SISTEMA_ESTILO de la Etapa 1, de modo que la crítica lee de la caché el prefijo que escribió la Etapa 1 unos segundos antes.
La función generar_portada encadena las cuatro primeras etapas y aplica la regla del bucle: si la puntuación es menor que 3, vuelve a generar con la siguiente semilla, hasta dos reintentos. Este bloque llama a la API y necesita la GPU de la Etapa 2; no se ejecutó para escribir la entrada y la salida es un ejemplo comentado:
# Etapa 4: crítica con visión y bucle de reintento en Python:
import base64
import io
from typing import Literal

class Critica(BaseModel):
    paleta: bool = Field(description = '¿Predominan los cinco colores de la guía?')
    composicion: bool = Field(description = '¿El tercio superior está libre y el título se lee?')
    prohibiciones: list[str] = Field(description = 'Reglas de "prohibido" que se incumplen; vacía si ninguna')
    puntuacion: Literal[1, 2, 3, 4, 5]
    motivo: str = Field(description = 'Una frase que justifique la puntuación')

def a_base64(imagen):
    # PNG en memoria y codificado en base64 para el bloque image:
    memoria = io.BytesIO()
    imagen.save(memoria, format = 'PNG')
    return base64.standard_b64encode(memoria.getvalue()).decode('utf-8')

def criticar(portada):
    respuesta = cliente.messages.parse(
        model = 'claude-sonnet-5-5',
        max_tokens = 2048,
        system = SISTEMA_ESTILO,                  # mismo prefijo: se lee de la caché
        output_config = {'effort': 'low'},
        messages = [{'role': 'user', 'content': [
            {'type': 'image', 'source': {'type': 'base64', 'media_type': 'image/png',
                                         'data': a_base64(portada)}},
            {'type': 'text', 'text': 'Evalúe esta portada contra la guía y la rúbrica. '
                                     'Juzgue solo estilo, composición y legibilidad.'},
        ]}],
        output_format = Critica,
    )
    if respuesta.stop_reason == 'refusal':
        raise RuntimeError('El modelo rechazó la petición.')
    return respuesta.parsed_output, respuesta.usage

def generar_portada(semana, max_reintentos = 2):
    # Etapas 1 a 4 con reintento si la puntuación es menor que 3:
    pv, _ = nota_a_prompt(semana)
    titulo = f"Semana {semana}: {semanas[semana]['tema']}"
    for intento in range(max_reintentos + 1):
        imagen, semilla = generar_imagen(ensamblar(pv), semana, intento)
        portada, _ = componer_portada(np.asarray(imagen), titulo, estilo)
        critica, _ = criticar(portada)
        print(f'Intento {intento + 1}: semilla {semilla} | puntuación {critica.puntuacion} | {critica.motivo}')
        if critica.puntuacion >= 3:
            break
    return portada, critica, semilla, pv

portada, critica, semilla, pv = generar_portada(2)

# Salida de ejemplo (puede variar):
# Intento 1: semilla 2028 | puntuación 2 | Las hojas suben hasta el borde superior y quedan cortadas
#            por la banda; el motivo compite con el título.
# Intento 2: semilla 2128 | puntuación 4 | Paleta respetada, motivo en los dos tercios inferiores y
#            título legible; la taza introduce un gris que no está en la guía.
Recorra las decisiones del bloque:
Literal[1, 2, 3, 4, 5]impide puntuaciones como “3.5” o “4/5”. Una escala corta y entera es más estable que una de $0$ a $100$: el modelo no tiene que fingir una precisión que no tiene.paletaycomposicionson booleanos y van antes de la puntuación. Obligar al modelo a responder primero a las preguntas concretas de la rúbrica hace que la puntuación final se apoye en ellas y que Sofía pueda ver por qué falló una portada.- La instrucción “juzgue solo estilo, composición y legibilidad” acota la tarea. La crítica no debe opinar sobre el tema de la nota ni describir a nadie.
- El bucle cambia la semilla, no el prompt, como se explicó en el flujo. En el ejemplo, el primer intento falla porque el motivo invade el tercio superior y el segundo, con la semilla $2128$, aprueba con un $4$.
- Si los tres intentos fallan, la función devuelve el último de todos modos. No descarta nada por su cuenta: el programa final marcará esa portada para revisión, porque la decisión es de Sofía.
Recuerde la advertencia del Día 11: un crítico automático hereda los gustos de sus datos de entrenamiento y puede puntuar de forma distinta dos imágenes casi iguales. Por eso la crítica es un filtro, no un juez: descarta los fallos evidentes (motivo bajo el título, colores ajenos a la guía) y deja a Sofía la elección final entre portadas aceptables.
Cuánto cuesta una portada
Diego insistió con su primera pregunta: ¿Cuánto cuesta cada portada? La respuesta depende de cuántas veces se ejecuta la crítica. Si cada intento aprueba con probabilidad $p$ de forma independiente y se permiten $R$ reintentos, el número esperado de llamadas a la crítica es:
$$ E[N] = \sum_{k=0}^{R} (1 - p)^{k} $$
La lógica detrás de esta fórmula es múltiple:
- El primer intento ($k = 0$) se hace siempre y aporta $1$.
- El segundo intento solo se hace si el primero falló, lo que ocurre con probabilidad $1 - p$; el tercero solo si fallaron los dos anteriores, con probabilidad $(1 - p)^2$.
- La suma se corta en $R$ porque el bucle tiene un máximo. Con $p = 0.8$ y $R = 2$: $E[N] = 1 + 0.2 + 0.04 = 1.24$.
- En conclusión, el reintento encarece poco si la mayoría de las portadas aprueban a la primera, y el máximo de reintentos pone un techo al peor caso: $R + 1 = 3$ críticas.
La imagen que recibe la crítica también cuesta tokens de entrada. Según la documentación de Claude, una imagen que no se redimensiona ocupa aproximadamente:
$$ \text{tokens} \approx \frac{\text{ancho} \times \text{alto}}{750} $$
de modo que una portada de $1,024 \times 1,024$ píxeles ocupa unos $1,398$ tokens. Con los precios de Sonnet 5.5 del Día 4 ($2$ USD por millón de tokens de entrada y $10$ de salida) y unos supuestos razonables para el resto (prefijo fijo de $1,100$ tokens, $80$ tokens de nota, $350$ de salida en la Etapa 1, $60$ de instrucción y $300$ de salida en la crítica), las cuentas quedan como en la Tabla 4. Los tamaños son supuestos de juguete, no mediciones; las cifras se obtuvieron aplicando esas fórmulas en Python.
Tabla 4. Coste de Claude por portada y por mes (4 portadas), en USD, con supuestos de juguete.
| Probabilidad de aprobar $p$ | $E[N]$ | Por portada sin caché | Por portada con caché | Mes con caché | Ahorro de la caché |
|---|---|---|---|---|---|
| $0.8$ | $1.24$ | $0.01592$ | $0.01402$ | $0.0561$ | $12.0%$ |
| $0.5$ | $1.75$ | $0.02006$ | $0.01715$ | $0.0686$ | $14.5%$ |
| Peor caso (3 críticas) | $3$ | $0.03021$ | $0.02482$ | $0.0993$ | $17.8%$ |
Incluso en el peor caso, la parte de Claude del generador cuesta menos de $0.10$ USD al mes, el $1%$ del presupuesto de $10$ USD del Cuaderno Vivo, frente a los $0.904$ USD del tutor del Día 8. El ahorro de la caché es modesto ($12%$ a $18%$) porque el prefijo solo se reutiliza dentro de una misma ejecución: entre una semana y la siguiente pasan mucho más de cinco minutos y la caché ya expiró. La caché rinde con llamadas seguidas, no con llamadas semanales.
El coste real del generador no está en Claude, sino en la imagen: la electricidad y el desgaste de la GPU si FLUX corre en local, o el precio por imagen del servicio en la nube si Sofía usa el respaldo del Día 11. Ese coste se multiplica por $E[N]$ igual que el de la crítica, y por eso el máximo de reintentos es también una decisión de presupuesto.
Consistencia entre portadas
La crítica juzga cada portada por separado. Pero el problema de Sofía era la colección: portadas que, una al lado de otra, no parecían de la misma serie. ¿Cómo se mide que dos imágenes “comparten paleta”? Una respuesta clásica de la visión por computadora es comparar sus histogramas de color: cuánta superficie de cada imagen cae en cada intervalo de color, sin importar dónde esté.
Para la paleta interesa sobre todo el tono, la componente del espacio HSV (por sus siglas en inglés: “Hue, Saturation, Value”) que dice si un color es azul, naranja o amarillo, medido como un ángulo de $0$ a $360$ grados. El tono de un color casi gris es inestable (el crema tiene una saturación de apenas $0.09$), así que cada píxel cuenta en el histograma en proporción a su saturación: los colores vivos pesan mucho y los neutros casi nada. Con los dos histogramas normalizados a suma $1$, la intersección de histogramas propuesta por Swain y Ballard en 1991 mide cuánta masa comparten:
$$ \cap(h, g) = \sum_{k=1}^{K} \min(h_k, g_k), \qquad \sum_{k} h_k = \sum_{k} g_k = 1 $$
La lógica detrás de esta fórmula es múltiple:
- En cada intervalo de tono $k$, la parte común a las dos imágenes es la menor de sus dos proporciones: si una tiene un $30%$ de azul y la otra un $20%$, comparten un $20%$.
- Sumar esas partes comunes da la fracción total de color compartido. Si los histogramas son idénticos, la suma vale $1$; si no comparten ningún tono, vale $0$.
- La medida es simétrica y no depende de la posición de los colores en la imagen, que es justo lo que se quiere: la composición cambia cada semana, la paleta no.
- En conclusión, $1 - \cap(h, g)$ es una distancia entre paletas fácil de explicar: “estas dos portadas comparten el $93%$ de su color”.
El siguiente código calcula el histograma de tono de las cuatro maquetas de las semanas 1 a 4 (semillas $2027$ a $2030$), la matriz de intersecciones entre todas las parejas y, como control, la intersección con una imagen que ignora la guía y usa tonos de todo el círculo cromático:
# Histogramas de tono de cuatro portadas e intersección de histogramas en Python:
from matplotlib.colors import rgb_to_hsv, hsv_to_rgb

def histograma_tono(imagen, bins = 36):
    # Histograma de tono ponderado por la saturación y normalizado a suma 1:
    hsv = rgb_to_hsv(np.asarray(imagen) / 255).reshape(-1, 3)
    h, _ = np.histogram(hsv[:, 0], bins = bins, range = (0, 1), weights = hsv[:, 1])
    return h / h.sum()

def interseccion(h, g):
    # Suma de los mínimos: 1 si son idénticos, 0 si no comparten ningún tono:
    return np.minimum(h, g).sum()

portadas = {s: maqueta_portada(s, estilo)[0][0] for s in semanas}
hist = {s: histograma_tono(p) for s, p in portadas.items()}
matriz = pd.DataFrame([[interseccion(hist[a], hist[b]) for b in semanas] for a in semanas],
                      index = [f'S{s}' for s in semanas], columns = [f'S{s}' for s in semanas]).round(3)
print(matriz.to_string())
pares = matriz.values[np.triu_indices(4, 1)]
print(f'Similitud entre semanas distintas: media {pares.mean():.3f}, mínima {pares.min():.3f}')

# Control: una portada que ignora la guía (tonos de todo el círculo cromático):
g = np.random.default_rng(99)
tonos = suavizar(g.uniform(size = (256, 256)), sigma = 16)
tonos = (tonos - tonos.min()) / (tonos.max() - tonos.min())
control = (hsv_to_rgb(np.stack([tonos, np.full_like(tonos, 0.7), np.full_like(tonos, 0.85)], -1)) * 255).astype(np.uint8)
h_control = histograma_tono(control)
print('Control fuera de guía contra S1 a S4:', [float(round(interseccion(h_control, hist[s]), 3)) for s in semanas])

fig, (ax1, ax2) = plt.subplots(1, 2, figsize = (12, 4.6), gridspec_kw = {'width_ratios': [1.5, 1]})
centros = (np.arange(36) + 0.5) * 10
for s in semanas:
    ax1.step(centros, hist[s], where = 'mid', label = f"Semana {s} (semilla {estilo['semilla_base'] + s})")
ax1.step(centros, h_control, where = 'mid', color = 'gray', linestyle = ':', label = 'Control fuera de guía')
ax1.set_xlabel('Tono (grados)'); ax1.set_ylabel('Proporción ponderada por saturación')
ax1.set_title('Histogramas de tono', fontsize = 16); ax1.legend(fontsize = 8)
im = ax2.imshow(matriz.values, cmap = 'Blues', vmin = 0, vmax = 1)
ax2.set_xticks(range(4)); ax2.set_xticklabels(matriz.columns)
ax2.set_yticks(range(4)); ax2.set_yticklabels(matriz.index)
for i in range(4):
    for j in range(4):
        ax2.text(j, i, f'{matriz.values[i, j]:.2f}', ha = 'center', va = 'center',
                 color = 'white' if matriz.values[i, j] > 0.6 else 'black')
ax2.set_title('Intersección de histogramas', fontsize = 16)
plt.colorbar(im, ax = ax2, fraction = 0.046)
plt.tight_layout()
plt.show()
       S1     S2     S3     S4
S1  1.000  0.932  0.905  0.954
S2  0.932  1.000  0.938  0.966
S3  0.905  0.938  1.000  0.934
S4  0.954  0.966  0.934  1.000
Similitud entre semanas distintas: media 0.938, mínima 0.905
Control fuera de guía contra S1 a S4: [0.131, 0.13, 0.119, 0.124]
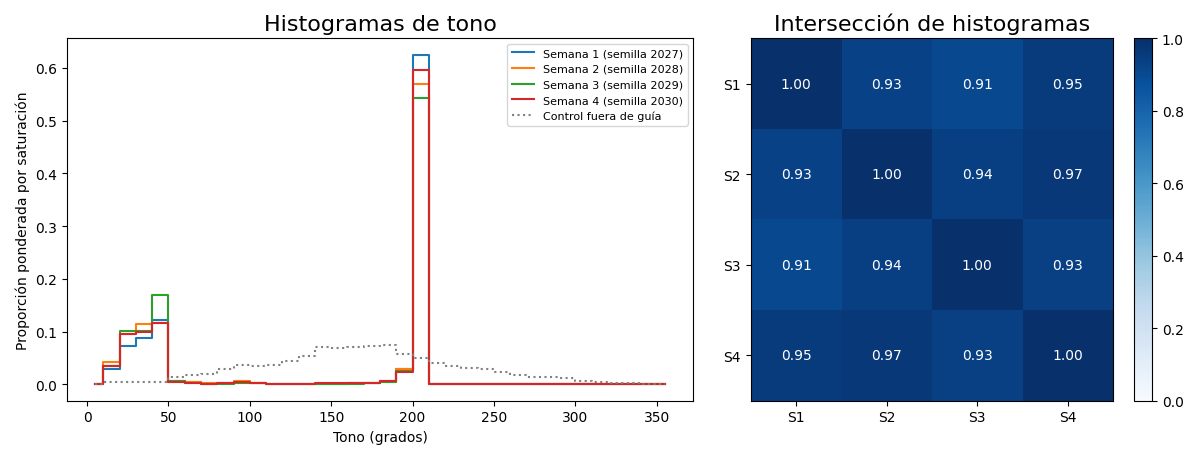
La matriz de la salida se resume en la Tabla 2.
Tabla 2. Matriz de similitud (intersección de histogramas de tono) entre 4 portadas de juguete.
| Portada | S1 | S2 | S3 | S4 |
|---|---|---|---|---|
| S1 (semilla 2027) | 1.000 | 0.932 | 0.905 | 0.954 |
| S2 (semilla 2028) | 0.932 | 1.000 | 0.938 | 0.966 |
| S3 (semilla 2029) | 0.905 | 0.938 | 1.000 | 0.934 |
| S4 (semilla 2030) | 0.954 | 0.966 | 0.934 | 1.000 |
Las cuatro maquetas comparten entre el $90.5%$ y el $96.6%$ de su color, con una media de $0.938$, aunque cada una tiene proporciones distintas de los cinco colores (las fija g.dirichlet con la semilla de la semana) y una composición diferente. La portada de control, que no sigue la guía, solo comparte entre el $11.9%$ y el $13.1%$ con cualquiera de ellas. Entre ambos grupos hay un hueco enorme, y ese hueco es lo que permite usar la medida como alarma.
La figura explica por qué. En el panel izquierdo, las cuatro curvas de las semanas tienen los mismos dos grupos de picos: uno alrededor de $200$ a $210$ grados (los dos azules de la paleta, con tonos de $201$ y $206$ grados) y otro entre $10$ y $50$ grados (el coral, de $17$ grados, y la mostaza, de $42$). Lo que cambia de una semana a otra es la altura de los picos, no su posición. La curva punteada del control, en cambio, reparte su masa por casi todo el círculo. El panel derecho muestra la matriz como mapa de calor: todo es azul oscuro, sin ninguna pareja que destaque por baja.
Con estas cifras, Sofía fijó una regla para el programa final: si una portada nueva comparte menos del $80%$ de su color con la de la semana anterior, el programa avisa. No la rechaza, porque una semana especial puede justificar un cambio, pero obliga a mirar. El umbral de $0.8$ deja margen por debajo del peor par de maquetas ($0.905$) y queda muy lejos del control ($0.13$).
Tenga en cuenta los límites de este experimento. Las maquetas están coloreadas exclusivamente con la paleta, así que su consistencia está garantizada por construcción; una acuarela real de FLUX introducirá sombras, grises y tonos intermedios que bajarán las intersecciones. El umbral de $0.8$ es un punto de partida de juguete que Sofía debe recalibrar con sus primeras ocho o diez portadas reales. Además, el histograma de tono no ve la luminosidad ni la textura: dos portadas con la misma paleta, una en acuarela y otra en estilo fotográfico, podrían obtener una intersección alta. Para eso sigue haciendo falta la crítica y, sobre todo, la mirada de Sofía.
Procedencia y etiquetado
La etiqueta visible “Generado con IA” informa a quien mira la portada. La procedencia responde a otra pregunta, la de quien quiere saber más: ¿con qué modelo, qué prompt, qué semilla y qué guía se hizo esta imagen, y cuándo? Esa información debe viajar dentro del propio archivo, porque los archivos se copian, se reenvían y se separan de las carpetas y los registros donde nacieron.
Metadatos en el PNG
El formato PNG admite bloques de texto con pares clave y valor dentro del archivo. Pillow los escribe con la clase PngInfo y los lee con el atributo .text de la imagen abierta. El siguiente código guarda la maqueta de la semana 2 con ocho campos de procedencia, la vuelve a abrir para comprobar que los metadatos están dentro y, por último, la convierte a JPEG para ver qué se pierde:
# Metadatos de procedencia dentro del PNG con PngInfo en Python:
from PIL.PngImagePlugin import PngInfo

prompt_semana_2 = ('Ilustración en acuarela digital con textura de papel de una tabla de datos que se abre como '
                   'un abanico de hojas sobre un escritorio, luz suave y lateral, paleta azul noche, azul acero, '
                   'mostaza, coral y crema, espacio libre en el tercio superior.')
metadatos = {
    'modelo': 'maqueta-numpy-0 (sin red neuronal)',
    'semilla': str(semilla),
    'prompt': prompt_semana_2,
    'fecha': '2026-01-12',
    'estilo_version': estilo['version'],
    'estilo_sha256': huella_estilo,
    'etiqueta': estilo['etiqueta'],
    'digital_source_type': 'http://cv.iptc.org/newscodes/digitalsourcetype/trainedAlgorithmicMedia',
}
info = PngInfo()
for clave, valor in metadatos.items():
    info.add_text(clave, valor)          # un bloque de texto por campo
ruta_png = carpeta / 'portadas' / 'semana_02.png'
portada.save(ruta_png, pnginfo = info)

# Relectura: los metadatos viajan dentro del archivo:
leidos = Image.open(ruta_png).text
print(f'{ruta_png.as_posix()} | {ruta_png.stat().st_size // 1024} KB | {len(leidos)} campos')
for clave, valor in leidos.items():
    print(f'  {clave:<20} {valor[:62]}{"..." if len(valor) > 62 else ""}')

# Qué pasa al convertir a JPEG: los bloques de texto del PNG no sobreviven:
ruta_jpg = carpeta / 'portadas' / 'semana_02.jpg'
portada.save(ruta_jpg, quality = 90)
print('Campos tras convertir a JPEG:', len(getattr(Image.open(ruta_jpg), 'text', {})))
cuaderno_vivo/portadas/semana_02.png | 290 KB | 8 campos
  modelo               maqueta-numpy-0 (sin red neuronal)
  semilla              2028
  prompt               Ilustración en acuarela digital con textura de papel de una ta...
  fecha                2026-01-12
  estilo_version       1.0
  estilo_sha256        4cd83b5558c7
  etiqueta             Generado con IA
  digital_source_type  http://cv.iptc.org/newscodes/digitalsourcetype/trainedAlgorith...
Campos tras convertir a JPEG: 0
La portada se guarda en cuaderno_vivo/portadas/semana_02.png con sus $8$ campos, y la relectura los devuelve intactos: los metadatos no están en una base de datos aparte, sino en los bytes del archivo. La última línea es la advertencia práctica del día: al convertir la misma imagen a JPEG quedan $0$ campos. Los bloques de texto son una particularidad del formato PNG, y cualquier conversión, recorte con otro programa o subida a una red social que recomprima la imagen los borra sin avisar. La Tabla 3 describe cada campo.
Tabla 3. Campos de metadatos guardados en cada PNG.
| Campo | Ejemplo (semana 2) | Para qué sirve |
|---|---|---|
modelo | maqueta-numpy-0 (sin red neuronal); en el flujo real, black-forest-labs/FLUX.1-schnell | Saber qué sistema generó la imagen y bajo qué licencia |
semilla | 2028 | Regenerar la imagen con la fórmula de la Etapa 2 |
prompt | Texto completo del prompt visual | Transparencia: qué se pidió exactamente al modelo |
fecha | 2026-01-12 | Situar la imagen en el tiempo y en la versión del modelo |
estilo_version | 1.0 | Versión legible de la guía de estilo |
estilo_sha256 | 4cd83b5558c7 | Huella exacta de estilo.json; detecta cambios no anotados en la versión |
etiqueta | Generado con IA | La misma etiqueta visible, ahora legible por máquinas |
digital_source_type | Vocabulario IPTC trainedAlgorithmicMedia | Término estándar de la industria de prensa para “medio creado por un algoritmo entrenado” |
El último campo merece una explicación. El Consejo Internacional de Telecomunicaciones de Prensa (o IPTC, por sus siglas en inglés: “International Press Telecommunications Council”) mantiene un vocabulario controlado para describir el origen de una imagen, y el valor trainedAlgorithmicMedia es el que corresponde a una imagen creada por un modelo generativo. Usar el término estándar, en lugar de una frase libre, permite que otros programas lo reconozcan sin adivinar.
Los metadatos de PNG tienen, sin embargo, una debilidad de fondo: cualquiera puede editarlos. Con las mismas cuatro líneas de Pillow se puede borrar la etiqueta o escribir que la imagen la hizo una cámara. Sirven para el orden personal de Sofía y para su transparencia de buena fe, pero no demuestran nada ante un tercero.
Content Credentials (C2PA)
Para que la procedencia sea verificable hace falta firmarla. La Coalición para la Procedencia y Autenticidad del Contenido (o C2PA, por sus siglas en inglés: “Coalition for Content Provenance and Authenticity”) publica un estándar abierto, conocido comercialmente como Content Credentials, que añade al archivo un manifiesto: una lista de afirmaciones (quién lo creó, con qué herramienta, qué acciones se le aplicaron) firmada con un certificado digital y ligada criptográficamente al contenido. Si alguien modifica un solo píxel o una sola afirmación, la validación de la firma falla y el lector lo informa.
La biblioteca c2pa-python permite leer esos manifiestos. Su API cambió en la versión 0.5.0, que sustituyó las funciones antiguas por las clases Reader y Builder, así que conviene fijar la versión al instalarla. El siguiente bloque lee el manifiesto de una portada firmada; solo funciona con un archivo que tenga manifiesto (por ejemplo, las imágenes de prueba del repositorio de la biblioteca, o una portada que Sofía firme con un certificado de prueba), por lo que se muestra con una salida de ejemplo comentada:
# Lectura de Content Credentials (C2PA) de una portada en Python:
# pip install "c2pa-python>=0.38"   (fije la versión exacta: la API cambió en la 0.5.0 y el lector se abre con Reader(ruta) desde entonces)
import json
import c2pa

ruta_firmada = carpeta / 'portadas' / 'semana_02_c2pa.jpg'
try:
    with c2pa.Reader(str(ruta_firmada)) as lector:
        almacen = json.loads(lector.json())
    activo = almacen['manifests'][almacen['active_manifest']]
    print('Generador:', activo.get('claim_generator', activo.get('claim_generator_info')))
    for afirmacion in activo['assertions']:
        if afirmacion['label'].startswith('c2pa.actions'):
            for accion in afirmacion['data']['actions']:
                print('Acción:', accion['action'], '|', accion.get('digitalSourceType', 'sin tipo'))
    print('Firmado por:', activo['signature_info']['issuer'])
    print('Validación:', almacen.get('validation_status', 'sin incidencias'))
except Exception as error:   # sin manifiesto, firma rota o versión distinta de la biblioteca:
    print('Sin Content Credentials legibles:', error)

# Salida de ejemplo (puede variar):
# Generador: cuaderno-vivo/2.0 c2pa-python/0.38.0
# Acción: c2pa.created | http://cv.iptc.org/newscodes/digitalsourcetype/trainedAlgorithmicMedia
# Acción: c2pa.edited | sin tipo
# Firmado por: Cuaderno Vivo (certificado de prueba)
# Validación: [{'code': 'signingCredential.untrusted', 'explanation': 'certificado no incluido en la lista de confianza'}]
El ejemplo muestra las dos acciones que tendría una portada del Cuaderno Vivo: c2pa.created con el mismo tipo de origen IPTC del PNG (la imagen la creó FLUX) y c2pa.edited (PIL añadió la banda, el título y la etiqueta). La última línea es tan importante como las demás: la firma es válida, pero el certificado es de prueba y no pertenece a ninguna autoridad de confianza, así que el lector lo marca como signingCredential.untrusted. Una firma demuestra que nadie tocó el archivo desde que se firmó; quién firmó lo garantiza solo el certificado.
El manifiesto tampoco es indestructible: una captura de pantalla produce una imagen nueva sin manifiesto. Lo que C2PA garantiza es que, si el manifiesto está, se puede comprobar; no que esté siempre. Por eso la serie combina tres capas: la etiqueta visible, los metadatos y, cuando haga falta demostrar el origen ante terceros, el manifiesto firmado. Cómo firmar con Builder y cómo se complementa con las marcas de agua invisibles se verá en el Día 20.
El artículo 50 del Reglamento (UE) 2024/1689, conocido como Ley de IA, obliga desde el 2 de agosto de 2026 a los proveedores de sistemas que generan imágenes a marcar sus salidas en un formato legible por máquinas y detectable como artificial, y a quienes difunden ultrasuplantaciones (deepfakes, contenidos que imitan de forma realista a personas, lugares o hechos reales) a declararlo. El uso estrictamente personal y no profesional tiene un tratamiento distinto en el reglamento, y las portadas de Sofía no imitan a nadie; aun así, la etiqueta visible y los metadatos la dejan preparada si algún día publica su cuaderno. El alcance exacto de estas obligaciones, el código de prácticas de la Comisión y su relación con C2PA se estudian en el Día 20.
La pregunta de Diego: ¿de quién es la portada?
La segunda pregunta de Diego no tiene una respuesta universal, porque los derechos de autor dependen de cada país. Pero hay un documento reciente que ayuda a ordenar las ideas. En enero de 2025, la Oficina de Derechos de Autor de Estados Unidos publicó la segunda parte de su informe Copyright and Artificial Intelligence, dedicada a qué salidas de un sistema de IA pueden registrarse como obra. Su conclusión central es que una imagen generada solo a partir de un prompt no se considera obra de autoría humana, porque el prompt, por detallado que sea, no determina los elementos expresivos del resultado: los decide el modelo. En cambio, sí pueden protegerse las contribuciones humanas perceptibles en el resultado final, como una selección y disposición creativa de elementos o las modificaciones hechas a mano.
Aplicado al Cuaderno Vivo, el reparto sería más o menos este: la acuarela que genera FLUX difícilmente sería de Sofía en ese marco; la guía de estilo, el texto de sus notas y la composición que ella diseñó (dónde va la banda, qué tipografía, qué título) son trabajo humano. No es asesoría jurídica, y otras jurisdicciones razonan distinto, pero la consecuencia práctica es la misma en todas: conservar el prompt, la semilla y la guía no es solo transparencia, es la documentación de qué parte del trabajo es suya. Los metadatos de la Tabla 3 son, también, ese registro.
Las cinco etapas en un programa: cuaderno_v2.py
Ha llegado el momento de juntar las piezas. cuaderno_v2.py no reemplaza al tutor del Día 8: lo extiende, igual que el tutor extendió el prototipo v0. Importa de cuaderno_v0.py la carpeta y la tabla de precios, y de cuaderno_v1.py la lectura de JSON y las órdenes tarjetas y repasar, de modo que todo lo anterior sigue funcionando exactamente igual, y añade una orden nueva:
portada --semana Nejecuta las cinco etapas para la semanaN, registra el coste de cada llamada a Claude enregistro_uso.csv, compara la portada con la de la semana anterior mediante la intersección de histogramas y la guarda encuaderno_vivo/portadas/semana_NN.pngcon sus metadatos.- La opción
--maquetasustituye FLUX por la maqueta de la Etapa 3. Sirve para probar el flujo completo en una laptop sin GPU: la crítica y el registro funcionan igual.
Para que el programa sea corto, guarde antes en un archivo portadas.py las funciones y clases de los bloques 3, 5, 6, 7, 8 y 9 (con sus importaciones, la carga de estilo.json y el diccionario semanas). En portadas.py, la Etapa 2 debe cargar FLUX solo cuando se llama a generar_imagen, para que la opción --maqueta no necesite torch. Este bloque llama a la API y no se ejecutó para escribir la entrada; la salida es un ejemplo comentado:
# Generador de portadas, archivo cuaderno_v2.py, en Python:
import argparse
import csv
import hashlib
import sys
from datetime import date, datetime

import numpy as np
from PIL import Image
from PIL.PngImagePlugin import PngInfo

from cuaderno_v0 import CARPETA, PRECIOS                       # el prototipo v0 sigue intacto
from cuaderno_v1 import leer_json, crear_tarjetas, repasar     # y también el tutor v1
from portadas import (estilo, semanas, nota_a_prompt, ensamblar, generar_imagen, criticar,
                      componer_portada, fondo_acuarela, histograma_tono, interseccion)

UMBRAL_CONSISTENCIA = 0.8   # recalibrar con las primeras portadas reales
TIPO_IA = 'http://cv.iptc.org/newscodes/digitalsourcetype/trainedAlgorithmicMedia'

# Registro del coste real de una llamada, con el mismo formato de seis columnas del Día 4:
def apuntar(uso, id_nota, modelo = 'claude-sonnet-5-5'):
    escritos, leidos = uso.cache_creation_input_tokens or 0, uso.cache_read_input_tokens or 0
    p_ent, p_sal = PRECIOS[modelo]
    coste = (uso.input_tokens + 1.25 * escritos + 0.10 * leidos) * p_ent / 1e6 + uso.output_tokens * p_sal / 1e6
    with open(CARPETA / 'registro_uso.csv', 'a', newline = '', encoding = 'utf-8') as archivo:
        csv.writer(archivo).writerow([datetime.now().strftime('%H:%M'), id_nota, modelo,
                                      uso.input_tokens + escritos + leidos, uso.output_tokens, f'{coste:.7f}'])
    return coste

# Orden portada: las cinco etapas para una semana:
def crear_portada(semana, maqueta = False, max_reintentos = 2):
    s = semanas[semana]
    titulo = f"Semana {semana}: {s['tema']}"
    pv, uso = nota_a_prompt(semana)                                   # Etapa 1
    coste = apuntar(uso, s['nota_id'])
    for intento in range(max_reintentos + 1):
        semilla = estilo['semilla_base'] + semana + 100 * intento
        if maqueta:
            fondo, modelo = fondo_acuarela(semilla, 1024, estilo), 'maqueta-numpy-0 (sin red neuronal)'
        else:
            imagen, semilla = generar_imagen(ensamblar(pv), semana, intento)   # Etapa 2
            fondo, modelo = np.asarray(imagen), estilo['modelo_imagen']
        portada, _ = componer_portada(fondo, titulo, estilo)            # Etapa 3
        critica, uso = criticar(portada)                                # Etapa 4
        coste += apuntar(uso, s['nota_id'])
        print(f'Intento {intento + 1}: semilla {semilla} | puntuación {critica.puntuacion} | {critica.motivo}')
        if critica.puntuacion >= 3:
            break
    else:
        print('Ningún intento llegó a 3: la portada queda marcada para revisión.')

    # Consistencia con la portada de la semana anterior:
    previa = CARPETA / 'portadas' / f'semana_{semana - 1:02d}.png'
    if previa.exists():
        similitud = interseccion(histograma_tono(portada), histograma_tono(Image.open(previa).convert('RGB')))
        aviso = '' if similitud >= UMBRAL_CONSISTENCIA else '  <- revise la paleta'
        print(f'Color compartido con la semana {semana - 1}: {similitud:.3f}{aviso}')

    # Etapa 5: procedencia dentro del PNG:
    info = PngInfo()
    datos = {'modelo': modelo, 'semilla': str(semilla), 'prompt': ensamblar(pv), 'negativo': pv.negativo,
             'fecha': date.today().isoformat(), 'estilo_version': estilo['version'],
             'estilo_sha256': hashlib.sha256((CARPETA / 'estilo.json').read_bytes()).hexdigest()[:12],
             'etiqueta': estilo['etiqueta'], 'digital_source_type': TIPO_IA,
             'critica': f'{critica.puntuacion}: {critica.motivo}'}
    for clave, valor in datos.items():
        info.add_text(clave, valor)
    ruta = CARPETA / 'portadas' / f'semana_{semana:02d}.png'
    portada.save(ruta, pnginfo = info)
    print(f'Guardada {ruta} | coste de Claude: {coste:.5f} USD')

# Punto de entrada con cuatro órdenes:
def main():
    lector = argparse.ArgumentParser(description = 'Cuaderno Vivo v2: tarjetas, repaso y portadas.')
    ordenes = lector.add_subparsers(dest = 'orden', required = True)
    ordenes.add_parser('tarjetas').add_argument('--id', type = int, required = True)
    ordenes.add_parser('repasar')
    orden_portada = ordenes.add_parser('portada')
    orden_portada.add_argument('--semana', type = int, required = True, choices = sorted(semanas))
    orden_portada.add_argument('--maqueta', action = 'store_true', help = 'sin GPU: fondo de numpy')
    argumentos = lector.parse_args()
    if argumentos.orden == 'tarjetas':
        crear_tarjetas(argumentos.id)
    elif argumentos.orden == 'repasar':
        repasar()
    else:
        crear_portada(argumentos.semana, argumentos.maqueta)

if __name__ == '__main__':
    main()

# Salida de ejemplo (puede variar):
# $ python cuaderno_v2.py portada --semana 2
# Intento 1: semilla 2028 | puntuación 2 | El motivo invade el tercio superior y compite con el título.
# Intento 2: semilla 2128 | puntuación 4 | Paleta respetada y título legible; un gris ajeno a la guía.
# Color compartido con la semana 1: 0.874
# Guardada cuaderno_vivo/portadas/semana_02.png | coste de Claude: 0.01391 USD
Recorra el programa por sus funciones:
apuntares la contabilidad. Calcula el coste con el precio de cada tipo de token (normal, escritura de caché a $1.25$ veces, lectura a $0.1$ veces) y escribe una fila enregistro_uso.csvcon las mismas seis columnas del Día 4. Así el coste de las portadas aparece junto al del tutor y los resúmenes, y Diego puede sumar el mes completo con una sola tabla.crear_portadarecorre las cinco etapas en el orden de la figura del flujo. La cláusulaelsedel bucleforsolo se ejecuta si el bucle terminó sinbreak, es decir, si ningún intento aprobó: en ese caso el programa no descarta la portada, la marca para revisión.- La comprobación de consistencia usa las funciones de la sección anterior y el umbral de $0.8$. En el ejemplo, la portada real de la semana 2 comparte $0.874$ de su color con la de la semana 1: menos que las maquetas, como se anticipó, pero por encima del umbral.
- La procedencia se escribe con los campos de la Tabla 3 más dos que solo existen en el flujo real: el prompt negativo y el resultado de la crítica. La huella de la guía se recalcula en cada portada, de modo que un cambio en
estilo.jsonqueda registrado aunque nadie actualice el campoversion. - Las órdenes del tutor siguen ahí.
tarjetasyrepasarvienen decuaderno_v1.pysin cambios: un programa que crece por extensión no rompe lo que ya funcionaba.
El programa también tiene límites conscientes. No firma la portada con C2PA, porque firmar exige gestionar un certificado y eso se hará el Día 20. No reintenta llamadas fallidas a la API por su cuenta, porque el SDK ya reintenta los errores de conexión y los límites de peticiones. Y la consistencia solo compara con la semana anterior; en su versión, puede comparar con la media de las últimas cuatro para que una deriva lenta de la paleta no pase inadvertida.
Consideraciones finales
El generador de portadas es la primera pieza del Cuaderno Vivo en la que la IA generativa produce algo que se ve, y precisamente por eso es la que más fácilmente se convierte en un álbum de recortes. La lección del día es que la estética de un proyecto no está en una imagen, sino en un sistema: una guía escrita, unas reglas que el código aplica sin excepciones, unas medidas que avisan cuando algo se aparta y un registro que permite reconstruir cada decisión. El modelo de imagen aporta variedad; el sistema aporta identidad.
Antes de dar el generador por terminado, conviene hacerse algunas preguntas:
- ¿La crítica de Sonnet 5.5 coincide con el juicio de Sofía? Una semana de portadas puntuadas por los dos permitiría medir ese acuerdo, como se hizo con los jueces humanos del Día 11.
- ¿El umbral de consistencia de $0.8$ sigue teniendo sentido con portadas reales de FLUX, o hay que recalibrarlo?
- ¿Cuántas portadas necesitan reintento? Si son más de la mitad, el problema está en el prompt o en la guía, no en la semilla.
- ¿Las portadas son accesibles para todos los lectores? El contraste del título está garantizado, pero una persona con daltonismo podría no distinguir el coral de la mostaza; la guía no debe confiar información solo al color.
Las cifras de hoy tienen límites claros. Las maquetas están coloreadas solo con la paleta, así que sus intersecciones son altas por construcción; las puntuaciones de la crítica y los tamaños de las llamadas son ejemplos o supuestos de juguete; los precios y las obligaciones legales deben revisarse en las fuentes oficiales antes de cada decisión. Ninguno de esos límites invalida el método: el generador está construido para medir, y en cuanto Sofía produzca un mes de portadas, registro_uso.csv y los metadatos de portadas/ sustituirán los supuestos por datos.
Un gran libro que habla de esto es La interacción del color (o Interaction of Color), en el que Josef Albers muestra con decenas de ejercicios que un color nunca se percibe solo, sino en relación con los que lo rodean: el mismo ocre parece cálido junto a un azul y apagado junto a un naranja. Su lectura le ayudará a entender por qué una paleta fija no basta, por qué importan las proporciones entre colores y por qué el contraste del título se mide sobre la banda y no sobre el color “oficial” de la guía.
Una colección visual coherente no la produce un modelo, la produce una guía que usted escribe y un programa que la hace cumplir. Con un archivo de $788$ bytes, dos fórmulas de contraste, una intersección de histogramas y ocho campos de metadatos, las portadas de Sofía pasan de ser imágenes sueltas a ser una serie que se reconoce, se audita y cuesta menos de diez centavos al mes en llamadas a Claude.
Conclusiones clave
Guía de estilo
- Una guía de estilo en
estilo.jsones la memoria visual del proyecto: el modelo de imagen no recuerda la semana pasada, el archivo sí; su huella SHA-256 registra qué versión exacta se usó. - La razón de contraste WCAG decide el color del título con números: azul noche y crema dan $10.54:1$, mientras que crema sobre mostaza solo llega a $1.48:1$.
- Una banda azul noche al $75%$ garantiza al menos $5.20:1$ sobre cualquier color de la paleta; al $50%$, el peor caso cae a $2.72:1$.
Flujo
- De las cinco etapas, solo dos usan Claude (prompt y crítica) y una usa FLUX; el título, la etiqueta y la procedencia son código determinista.
- FLUX.1 schnell trabaja con
guidance_scale = 0.0, por lo que ignora el prompt negativo; las prohibiciones se cumplen con el prompt positivo y con la crítica. - La semilla $s = 2026 + \text{semana} + 100,k$ hace cada portada reproducible, y el bucle de reintento cambia la semilla, no el prompt.
- Con $p = 0.8$ y dos reintentos se esperan $1.24$ críticas por portada; la parte de Claude cuesta entre $0.056$ y $0.099$ USD al mes con caché.
Consistencia
- La intersección de histogramas de tono mide qué fracción de color comparten dos portadas: las maquetas comparten entre $0.905$ y $0.966$, y el control fuera de guía, alrededor de $0.13$.
- El umbral de aviso de $0.8$ es un supuesto de juguete que se debe recalibrar con portadas reales.
Procedencia
- La etiqueta visible “Generado con IA” informa a las personas; los metadatos PNG informan a los programas, pero se pierden al convertir a JPEG y cualquiera puede editarlos.
- Content Credentials (C2PA) firma la procedencia: detecta cambios, pero la confianza depende del certificado de quien firma.
- Conservar prompt, semilla y guía documenta también qué parte del trabajo es humana, un punto central del informe de 2025 de la Oficina de Derechos de Autor de Estados Unidos.
Mañana, en el Día 13: El sonido como datos: ondas, muestreo y espectrogramas. Comienza el módulo 4/6, IA Sonora, Clonación Vocal y Ética, y el Cuaderno Vivo, que hoy aprendió a ilustrarse con una guía de estilo, empezará a escuchar: verá que un sonido es una lista de números que se puede muestrear, transformar y dibujar, el primer paso para que Sofía narre su resumen semanal con su propia voz.
Referencias
- C2PA (2024). C2PA Technical Specification (versión 2.x). Coalition for Content Provenance and Authenticity. https://c2pa.org/specifications/
- W3C (2023). Web Content Accessibility Guidelines (WCAG) 2.2, criterio 1.4.3 Contrast (Minimum). https://www.w3.org/TR/WCAG22/
- U.S. Copyright Office (2025). Copyright and Artificial Intelligence, Part 2: Copyrightability. https://www.copyright.gov/ai/
- Swain, M. J. y Ballard, D. H. (1991). Color Indexing. International Journal of Computer Vision, 7(1), 11-32.
- Black Forest Labs (2024). FLUX.1 [schnell], ficha del modelo. Hugging Face. https://huggingface.co/black-forest-labs/FLUX.1-schnell
- Parlamento Europeo y Consejo de la Unión Europea (2024). Reglamento (UE) 2024/1689 por el que se establecen normas armonizadas en materia de inteligencia artificial, artículo 50. Diario Oficial de la Unión Europea.
- Albers, J. (1963). Interaction of Color. Yale University Press.
- Anthropic (2026). Vision; Structured outputs; Prompt caching. Documentación de Claude. https://platform.claude.com/docs