IA generativa en proyectos personales: Día 13
 Jeshua Romero Guadarrama
- 51 Min para leer
- 13 Jan, 2026
Índice de contenido
Resumen:
Antes de que un modelo pueda narrar, cantar o imitar una voz, el sonido tiene que convertirse en números, y la forma de esos números decide qué puede aprender el modelo. En esta entrada se abre el módulo 4/6 tratando el audio como datos: se sintetiza con numpy un acorde de La mayor, se muestrea a $16,000$ Hz, se provoca a propósito un caso de aliasing que se puede escuchar, se pasa del tiempo a la frecuencia con la FFT y la STFT, y se construyen a mano el espectrograma de mel y los MFCC que usan los modelos de voz. Al terminar, usted sabrá leer un espectrograma, elegir sus parámetros con números y guardar audio en WAV de $16$ bits sin perder calidad audible.
¿Cómo citar el presente artículo?
Romero, J. (13 de enero de 2026). IA generativa en proyectos personales: Día 13. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_13/.
IA generativa en proyectos personales: Día 13 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_13/.
Modelos, precios y regulación revisados en octubre de 2026. Todo el código de esta entrada usa solo numpy, scipy (scipy.signal, scipy.fft y scipy.io.wavfile), pandas y matplotlib; donde la práctica habitual usa librosa o soundfile, el texto indica la función equivalente.
Día 13. El sonido como datos: ondas, muestreo y espectrogramas
Introducción
Ayer, en el Día 12, convirtió una guía de estilo en código, midió el contraste del título y la consistencia de color entre portadas, y el Cuaderno Vivo ganó un generador de portadas semanales con la etiqueta “Generado con IA” y sus metadatos de procedencia. Hoy comienza el módulo 4/6: IA Sonora, Clonación Vocal y Ética. Durante cuatro días el cuaderno de Sofía aprenderá a sonar: primero a entender qué es un sonido para una computadora, después a sintetizar voz a partir de texto, luego a usar la voz propia con consentimiento y, por último, a narrar el resumen semanal con música de fondo y una marca de agua.
Sofía toca la guitarra y una de sus 12 notas de estudio, la número 11, dice: “Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones”. Su idea para el módulo es sencilla de enunciar: que el resumen de cada semana se pueda escuchar mientras camina a la universidad, con su propia voz y una base musical discreta. Diego, que ya la vio pasar de un generador de frases a un sistema de portadas, le hizo la pregunta de siempre en versión sonora: ¿Sabe qué le está entregando a la máquina cuando le da su voz? La respuesta corta es “números”, pero no cualquier números: la voz es un dato biométrico, y la forma en que se representa decide qué puede reconstruir un modelo a partir de ella.
Por eso este primer día no usa ningún modelo generativo. Todos los sistemas de voz que verá en los días 14 a 16 reciben o producen alguna de tres representaciones: la onda muestreada, el espectrograma de mel o una secuencia de fichas (tokens) de un códec neuronal. Si usted entiende de dónde sale cada una, qué conserva y qué tira, podrá leer la documentación de cualquier modelo de voz, diagnosticar por qué un audio sale metálico o con chasquidos y decidir con criterio a qué frecuencia de muestreo grabar.
En la presente entrada, descubrirá cómo describir una onda por su frecuencia, amplitud y fase, y cómo sintetizar con numpy el acorde de La mayor que Sofía practica. Verá qué significa muestrear a $16,000$ Hz, por qué el teorema de Nyquist pone un techo a las frecuencias que se pueden representar y cómo un tono de $9,000$ Hz se disfraza de uno de $7,000$ Hz. Pasará del dominio del tiempo al de la frecuencia con la FFT, construirá a mano una STFT para dibujar el espectrograma de una melodía de cuatro notas, comprimirá ese espectrograma en $64$ bandas de mel y en $13$ coeficientes MFCC, y terminará guardando tres archivos WAV de $16$ bits en cuaderno_vivo/audio/, que puede escuchar en esta misma página.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Describir una onda por su frecuencia, amplitud y fase, y sintetizar tonos con numpy.
- Explicar la frecuencia de muestreo, el teorema de Nyquist y el aliasing con un ejemplo audible.
- Pasar del dominio del tiempo al de la frecuencia con la FFT y la STFT.
- Construir espectrogramas de mel y MFCC, las representaciones que usan los modelos de voz, con numpy y scipy, y reconocer sus equivalentes en librosa.
Una onda en una línea de código
Un sonido es una variación de la presión del aire que llega al oído. Un micrófono convierte esa variación en un voltaje que sube y baja, y una tarjeta de sonido mide ese voltaje miles de veces por segundo. Lo que queda en el disco es una lista de números: la forma de onda. Antes de trabajar con grabaciones, conviene fabricar ondas a mano, porque así se sabe exactamente qué contienen y se puede comprobar si cada herramienta las mide bien.
La onda más simple es el tono puro, una sinusoide. Se describe con tres números:
$$ x(t) = A \sin(2\pi f t + \phi) $$
La lógica detrás de esta fórmula es la siguiente:
- $f$ es la frecuencia en hercios (Hz), el número de ciclos completos por segundo. Es lo que el oído percibe como altura: $440$ Hz es el La de afinación de una orquesta, y al duplicar la frecuencia se sube una octava.
- $A$ es la amplitud, la altura máxima de la onda. Se relaciona con el volumen percibido; en audio digital se trabaja con amplitudes entre $-1$ y $1$, donde $1$ es el máximo que el formato puede guardar sin recortar.
- $\phi$ es la fase, el punto del ciclo en el que empieza la onda. El oído casi no distingue la fase de un tono aislado, pero importa mucho cuando se suman ondas, porque dos ondas iguales en fases opuestas se anulan.
- En conclusión, el término $2\pi f t$ convierte el tiempo en un ángulo que da $f$ vueltas completas por segundo, y el seno traduce ese ángulo en una altura entre $-A$ y $A$.
Comencemos por preparar el entorno con las importaciones base, la semilla global de la serie, $2026$, y la carpeta cuaderno_vivo/audio/, donde se guardarán los archivos del módulo. La frecuencia de muestreo del día es $16,000$ Hz, la habitual en reconocimiento y síntesis de voz:
# Importaciones base, semilla del día y carpeta de audio en Python:
import warnings
warnings.filterwarnings('ignore')
from pathlib import Path
import numpy as np
import pandas as pd
import scipy
from scipy import signal
from scipy.io import wavfile
from scipy.fft import dct
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
carpeta_audio = Path('cuaderno_vivo') / 'audio'
carpeta_audio.mkdir(parents = True, exist_ok = True)
fs = 16000
print('numpy', np.__version__, '| scipy', scipy.__version__, '| matplotlib', matplotlib.__version__)
print('Frecuencia de muestreo del día:', fs, 'Hz | carpeta:', carpeta_audio.as_posix())
numpy 2.4.6 | scipy 1.17.1 | matplotlib 3.10.9
Frecuencia de muestreo del día: 16000 Hz | carpeta: cuaderno_vivo/audio
La salida confirma las versiones de numpy, scipy y matplotlib con las que se obtuvieron todas las cifras de esta entrada. Observe que no aparecen librosa ni soundfile, las dos bibliotecas que casi cualquier tutorial de audio en Python importa en la primera línea. No es un descuido: todo lo que hacen las funciones de librosa que usará este día (STFT, decibelios, banco de mel, MFCC) cabe en unas pocas líneas de numpy, y escribirlo a mano tiene una ventaja didáctica clara, porque obliga a ver cada decisión que la biblioteca toma por usted.
El acorde de Sofía
Un acorde mayor se forma con la nota fundamental, su tercera mayor y su quinta. Para La mayor son La, Do sostenido y Mi. En la afinación temperada, cada semitono multiplica la frecuencia por $2^{1/12}$; por eso, partiendo de La4 a $440$ Hz, Do sostenido está $4$ semitonos arriba ($440 \cdot 2^{4/12} = 554.37$ Hz) y Mi, $7$ semitonos arriba ($440 \cdot 2^{7/12} = 659.25$ Hz). Sofía quiere que la fundamental se oiga más que las otras dos notas, así que les asigna amplitudes decrecientes, como se muestra en la Tabla 1.
Tabla 1. Notas del acorde de La mayor que se sintetiza durante 1 segundo a 16 000 Hz.
| Nota | Frecuencia (Hz) | Amplitud | Periodo (ms) | Muestras por ciclo |
|---|---|---|---|---|
| La4 | 440.00 | 0.5 | 2.273 | 36.36 |
| Do#5 | 554.37 | 0.3 | 1.804 | 28.86 |
| Mi5 | 659.25 | 0.2 | 1.517 | 24.27 |
La función tono traduce la fórmula de la onda a código: crea los instantes de muestreo $t = n / f_s$ y evalúa el seno en ellos. El acorde es la suma de los tres tonos. El siguiente bloque construye el acorde y comprueba su forma, sus valores extremos y su valor cuadrático medio:
# Función tono y acorde de La mayor en Python:
def tono(f, dur, fs, A = 1.0, fase = 0.0):
    # Instantes de muestreo t = n / fs y la onda A sen(2 pi f t + fase):
    t = np.arange(int(round(dur * fs))) / fs
    return A * np.sin(2 * np.pi * f * t + fase)

notas_acorde = {'La4': (440.00, 0.5), 'Do#5': (554.37, 0.3), 'Mi5': (659.25, 0.2)}
ondas = {nombre: tono(f, 1.0, fs, A) for nombre, (f, A) in notas_acorde.items()}
acorde = sum(ondas.values())

# Forma del arreglo, duración y valores extremos del acorde:
print('Forma del arreglo:', acorde.shape, '| tipo:', acorde.dtype)
print(f'Duración: {len(acorde) / fs:.2f} s | máximo: {acorde.max():.4f} | mínimo: {acorde.min():.4f}')
print(f'Valor cuadrático medio (RMS): {np.sqrt(np.mean(acorde ** 2)):.4f}')
for nombre, (f, A) in notas_acorde.items():
    print(f'{nombre:<5} {f:>7.2f} Hz | periodo {1000 / f:.3f} ms | {fs / f:.2f} muestras por ciclo')
Forma del arreglo: (16000,) | tipo: float64
Duración: 1.00 s | máximo: 0.9976 | mínimo: -0.9973
Valor cuadrático medio (RMS): 0.4360
La4    440.00 Hz | periodo 2.273 ms | 36.36 muestras por ciclo
Do#5   554.37 Hz | periodo 1.804 ms | 28.86 muestras por ciclo
Mi5    659.25 Hz | periodo 1.517 ms | 24.27 muestras por ciclo
Un segundo de audio a $16,000$ Hz son exactamente $16,000$ números de coma flotante. El máximo del acorde es $0.9976$, muy cerca de $1$ aunque la suma de amplitudes, $0.5 + 0.3 + 0.2$, sea exactamente $1$: los tres picos casi nunca coinciden en el mismo instante, pero en un segundo hay momentos en los que se acercan mucho. Si Sofía hubiera elegido amplitudes que sumaran más de $1$, el acorde se saldría del rango y, al guardarlo, se recortaría, un defecto que se oye como una distorsión áspera.
El valor cuadrático medio (o RMS, por sus siglas en inglés: “Root Mean Square”) de $0.4360$ también tiene una explicación exacta. Para un seno de amplitud $A$, el RMS es $A/\sqrt{2}$, y cuando se suman senos de frecuencias distintas sus energías se suman: $\sqrt{(0.5^2 + 0.3^2 + 0.2^2)/2} = \sqrt{0.19} = 0.4359$. Comprobar una cifra contra su valor teórico es la mejor forma de saber que el código hace lo que usted cree.
La última columna de la salida explica algo importante para el resto del módulo: a $16,000$ Hz, un ciclo de La4 dura $36.36$ muestras, y uno de Mi5, $24.27$. Cuanto más aguda es una nota, menos muestras le tocan por ciclo. Esa cuenta tiene un límite, que verá en la sección siguiente.
Para ver cómo se combinan las tres notas, el siguiente bloque dibuja los primeros $10$ ms del acorde y de cada nota por separado:
# Formas de onda de los primeros 10 ms del acorde y de cada nota en Python:
n_10ms = int(0.010 * fs)
t_ms = np.arange(n_10ms) / fs * 1000
paneles = [('Acorde de La mayor', acorde, '#1B3A4B')] + [
    (f'{nombre} ({f:.2f} Hz, A = {A})', ondas[nombre], color)
    for (nombre, (f, A)), color in zip(notas_acorde.items(), ['#3F7CAC', '#F78154', '#2A9D8F'])]
fig, ejes = plt.subplots(4, 1, figsize = (8, 7.2), sharex = True)
for eje, (titulo, onda, color) in zip(ejes, paneles):
    eje.plot(t_ms, onda[:n_10ms], color = color, lw = 1.6)
    eje.set_title(titulo, fontsize = 11, loc = 'left')
    eje.set_ylim(-1.05, 1.05)
    eje.set_ylabel('Amplitud')
    eje.grid(alpha = 0.3)
ejes[-1].set_xlabel('Tiempo (ms)')
fig.suptitle('Los primeros 10 ms del acorde y de sus tres notas', fontsize = 16)
plt.tight_layout()
plt.show()
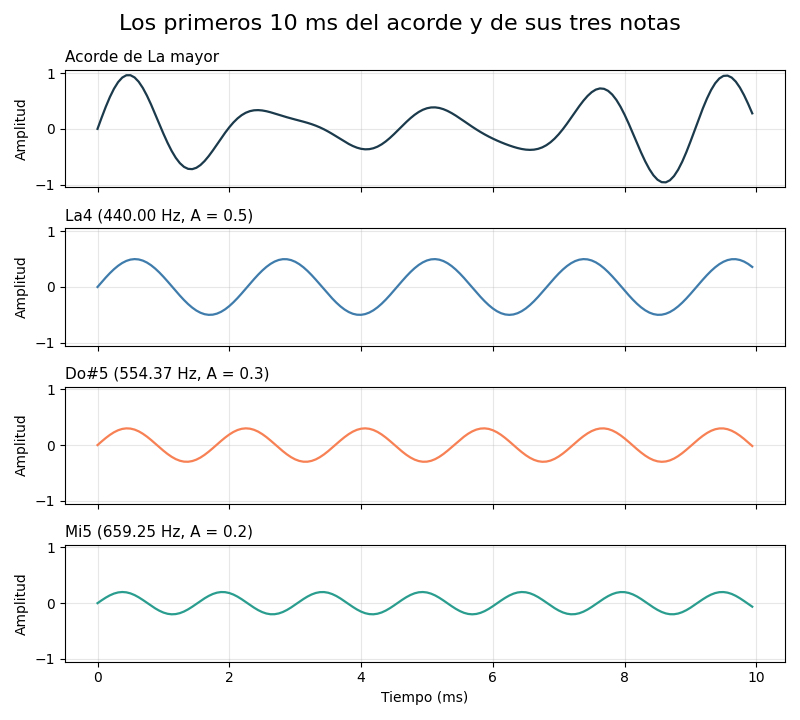
El gráfico anterior muestra por qué una forma de onda es difícil de leer a simple vista. Cada nota por separado es un seno perfecto y regular: en $10$ ms, La4 completa $4.4$ ciclos, Do#5 algo más de $5.5$ y Mi5 algo más de $6.5$. Su suma, en cambio, es una curva irregular en la que no se distingue ninguna de las tres frecuencias. Un oído entrenado sí reconoce las tres notas, porque la cóclea descompone el sonido en frecuencias. La herramienta matemática que hace lo mismo es la transformada de Fourier, y llegará a ella en dos secciones. Antes hay que entender qué se pierde al convertir una onda continua en una lista de números.
Muestrear: de lo continuo a lo discreto
La presión del aire varía de forma continua, pero una computadora solo puede guardar una cantidad finita de valores. Muestrear es medir la señal a intervalos regulares de $1/f_s$ segundos, donde $f_s$ es la frecuencia de muestreo. La onda continua se convierte en una sucesión indexada por enteros:
$$ x[n] = A \sin\left(2\pi \frac{f}{f_s} n + \phi\right), \qquad n = 0, 1, 2, \dots $$
La lógica detrás de esta fórmula es la siguiente:
- El tiempo deja de ser continuo: el instante $t$ se sustituye por $n / f_s$, de modo que la muestra $n$ corresponde al tiempo $n / f_s$ segundos.
- La frecuencia solo aparece como el cociente $f / f_s$, la frecuencia normalizada, en ciclos por muestra. Para La4 a $16,000$ Hz vale $440 / 16,000 = 0.0275$ ciclos por muestra, el inverso de las $36.36$ muestras por ciclo que imprimió el bloque anterior.
- En conclusión, una vez muestreada, la señal ya no “sabe” en qué hercios estaba: solo conoce ciclos por muestra. Esa pérdida de información es el origen del aliasing.
Muestrear no es la única decisión. Cada muestra se guarda con un número finito de niveles, la profundidad de bits. Con $16$ bits hay $2^{16} = 65,536$ niveles posibles, y con $8$ bits, solo $256$. La diferencia entre el valor real y el nivel más cercano es el ruido de cuantización, que medirá al final de la entrada. La Tabla 3 resume las frecuencias de muestreo que encontrará en la práctica y para qué se usa cada una.
Tabla 3. Frecuencias de muestreo habituales, su límite de Nyquist y su uso.
| Frecuencia de muestreo (Hz) | Límite de Nyquist (Hz) | Bytes por segundo (mono, 16 bits) | Uso habitual |
|---|---|---|---|
| 8 000 | 4 000 | 16 000 | Telefonía de banda estrecha |
| 16 000 | 8 000 | 32 000 | Reconocimiento y síntesis de voz |
| 22 050 | 11 025 | 44 100 | Conjuntos de datos y vocodificadores de síntesis de voz |
| 44 100 | 22 050 | 88 200 | Disco compacto y música |
| 48 000 | 24 000 | 96 000 | Vídeo y producción profesional |
La columna de bytes por segundo se calcula como $f_s \times 2$, porque cada muestra de $16$ bits ocupa $2$ bytes. Un minuto de voz a $16,000$ Hz ocupa $1.92$ MB; a $48,000$ Hz, el triple. Para la voz hablada, cuya energía útil está casi toda por debajo de $8,000$ Hz, $16,000$ Hz es un compromiso excelente, y por eso es la frecuencia de muestreo de este día y del resto del módulo.
Nyquist y aliasing
El teorema de muestreo de Nyquist y Shannon dice que una señal se puede reconstruir sin pérdida a partir de sus muestras si no contiene frecuencias iguales o superiores a la mitad de la frecuencia de muestreo. Esa mitad se llama límite de Nyquist:
$$ f_{\max} = \frac{f_s}{2}, \qquad f_{\text{alias}} = \left| f - k , f_s \right| \quad \text{con } k \text{ el entero que deja } f_{\text{alias}} \le \frac{f_s}{2} $$
La lógica detrás de estas fórmulas es la siguiente:
- Para seguir una oscilación hacen falta, como mínimo, dos muestras por ciclo: una cerca de la cresta y otra cerca del valle. Con menos de dos, las muestras no pueden distinguir una oscilación rápida de una más lenta.
- Si una frecuencia $f$ supera el límite, sus muestras coinciden exactamente con las de otra frecuencia más baja, su alias, que se obtiene restando múltiplos de $f_s$ hasta caer dentro del rango permitido.
- En conclusión, el aliasing (solapamiento espectral) no es ruido ni un error de redondeo: es una frecuencia falsa, perfectamente nítida, que no estaba en el sonido original y que ningún procesamiento posterior puede separar de las verdaderas.
Para el ejemplo del día, un tono de $9,000$ Hz muestreado a $16,000$ Hz supera el límite de $8,000$ Hz, y su alias es $|9,000 - 16,000| = 7,000$ Hz. El siguiente bloque lo comprueba de tres maneras: compara las muestras de ambos tonos, busca el pico de la FFT del tono muestreado y dibuja la situación con una aproximación del tono “continuo” muestreado a $192,000$ Hz:
# Demostración de aliasing: un tono de 9 000 Hz muestreado a 16 000 Hz en Python:
f_alta, f_tono, f_alias = 192000, 9000, 7000
t_continuo = np.arange(int(0.001 * f_alta)) / f_alta
t_muestras = np.arange(int(0.001 * fs)) / fs
continuo = np.sin(2 * np.pi * f_tono * t_continuo)
muestras = np.sin(2 * np.pi * f_tono * t_muestras)
impostor = -np.sin(2 * np.pi * f_alias * t_continuo)

# Las muestras del tono de 9 000 Hz coinciden con las de un tono de 7 000 Hz invertido:
diferencia = np.max(np.abs(muestras + np.sin(2 * np.pi * f_alias * t_muestras)))
print(f'Diferencia máxima entre ambas series de muestras: {diferencia:.2e}')

# Frecuencia que encuentra la FFT en un segundo del tono muestreado a 16 kHz:
espectro = np.abs(np.fft.rfft(tono(f_tono, 1.0, fs)))
print('Pico de la FFT:', np.fft.rfftfreq(fs, 1 / fs)[np.argmax(espectro)], 'Hz')
print('Fórmula |f - fs|:', abs(f_tono - fs), 'Hz | límite de Nyquist:', fs / 2, 'Hz')

plt.figure(figsize = (8, 4.2))
plt.plot(t_continuo * 1000, continuo, color = '#3F7CAC', lw = 1.2, label = 'Tono real de 9 000 Hz')
plt.plot(t_continuo * 1000, impostor, color = '#F78154', lw = 2, ls = '--', label = 'Tono de 7 000 Hz invertido')
plt.plot(t_muestras * 1000, muestras, 'o', color = '#1B3A4B', ms = 7, label = 'Muestras a 16 000 Hz')
plt.title('Aliasing: 9 000 Hz se disfraza de 7 000 Hz', fontsize = 16)
plt.xlabel('Tiempo (ms)')
plt.ylabel('Amplitud')
plt.ylim(-1.3, 1.8)
plt.legend(loc = 'upper center', fontsize = 9, ncol = 3)
plt.grid(alpha = 0.3)
plt.tight_layout()
plt.show()
Diferencia máxima entre ambas series de muestras: 9.94e-15
Pico de la FFT: 7000.0 Hz
Fórmula |f - fs|: 7000 Hz | límite de Nyquist: 8000.0 Hz
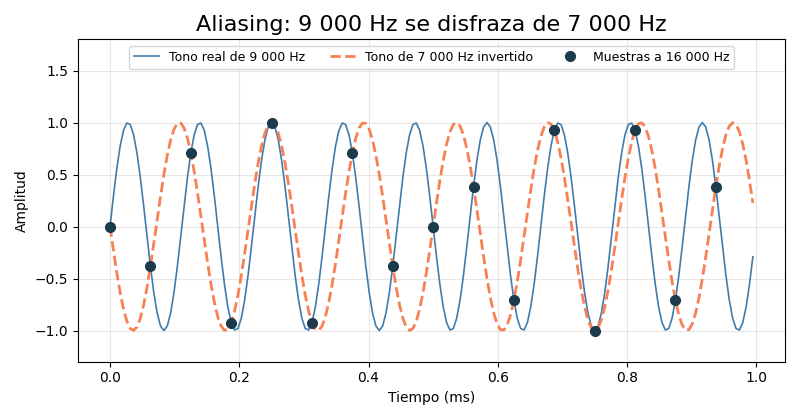
La diferencia máxima entre las muestras del tono de $9,000$ Hz y las de un tono de $7,000$ Hz invertido es de $9.94 \times 10^{-15}$, es decir, cero salvo errores de redondeo de la coma flotante. Las dos series de números son la misma serie. La FFT, que no tiene forma de saber qué sonido se grabó, encuentra el pico en $7,000$ Hz, exactamente donde predice la fórmula.
El gráfico anterior hace visible el fenómeno. La línea azul fina es el tono real, con $9$ ciclos por milisegundo; los puntos oscuros son las $16$ muestras que se toman en ese milisegundo; la línea naranja discontinua es un tono de $7,000$ Hz con la fase invertida, que pasa exactamente por los mismos puntos. Con solo las muestras, no hay manera de saber cuál de las dos curvas estaba en el aire. Por eso el alias es “invertido”: $\sin(2\pi \cdot 9,000 , n/16,000) = \sin(2\pi n - 2\pi \cdot 7,000 , n/16,000) = -\sin(2\pi \cdot 7,000 , n/16,000)$, y el oído no distingue esa inversión de fase.
El ejemplo es audible: al final de la entrada guardará el tono de $9,000$ Hz muestreado a $16,000$ Hz en el archivo alias_9000_hz.wav. Al reproducirlo, lo que suena es un tono de $7,000$ Hz. En la práctica, los conversores analógico digitales evitan esto con un filtro antialiasing que elimina las frecuencias por encima del límite antes de muestrear, y las funciones de remuestreo (scipy.signal.resample_poly, por ejemplo) hacen lo mismo en digital.
Atención aquí: Nunca baje la frecuencia de muestreo de un audio tomando una de cada $n$ muestras (y[::3], por ejemplo). Sin un filtro paso bajo previo, todo el contenido por encima del nuevo límite de Nyquist se pliega como alias dentro de la banda audible y queda mezclado con la voz para siempre. Use una función de remuestreo con filtro, como scipy.signal.resample_poly(y, 1, 3), y compruebe el resultado escuchándolo.
Del tiempo a la frecuencia: la FFT
La forma de onda del acorde era ilegible porque mezcla tres frecuencias en una sola curva. La transformada discreta de Fourier (o DFT, por sus siglas en inglés: “Discrete Fourier Transform”) hace la operación inversa: mide cuánto de cada frecuencia contiene una señal. La transformada rápida de Fourier (o FFT, por sus siglas en inglés: “Fast Fourier Transform”) es el algoritmo que la calcula en $N \log N$ operaciones en lugar de $N^2$, y es la razón de que el análisis espectral sea instantáneo en cualquier computadora.
$$ X[k] = \sum_{n=0}^{N-1} x[n] , e^{-i 2\pi k n / N}, \qquad f_k = k , \frac{f_s}{N}, \quad k = 0, 1, \dots, \frac{N}{2} $$
La lógica detrás de esta fórmula es la siguiente:
- Para cada frecuencia candidata $f_k$, la fórmula multiplica la señal por una oscilación de prueba de esa frecuencia y suma los productos. Si la señal contiene esa frecuencia, los productos se alinean y la suma es grande; si no, se cancelan y la suma es casi cero.
- La exponencial compleja $e^{-i\theta} = \cos\theta - i \sin\theta$ prueba a la vez un coseno y un seno, de modo que el módulo $|X[k]|$ no depende de la fase de la señal.
- Las frecuencias candidatas están separadas por $f_s / N$ hercios: esa es la resolución en frecuencia. Con $N = 16,000$ muestras a $16,000$ Hz, la resolución es de $1$ Hz.
- En conclusión, como el audio es real, basta con la mitad positiva del espectro, $N/2 + 1$ valores, que es lo que devuelve
np.fft.rfft;np.fft.rfftfreqda la frecuencia en hercios de cada posición.
Cada una de esas posiciones del espectro se llama intervalo de frecuencia (en inglés, bin). El siguiente bloque calcula el espectro de magnitud del acorde, lo escala para que cada pico se lea como la amplitud de su seno ($2|X[k]|/N$) y localiza los tres picos más altos con np.argsort:
# Espectro de magnitud del acorde con la FFT en Python:
X = np.fft.rfft(acorde)
frecuencias = np.fft.rfftfreq(len(acorde), 1 / fs)
magnitud = 2 * np.abs(X) / len(acorde)

# Los tres picos más altos del espectro:
picos = np.sort(np.argsort(magnitud)[-3:])
print('Número de bins:', len(frecuencias), '| resolución:', frecuencias[1], 'Hz')
for i in picos:
    print(f'Pico en {frecuencias[i]:>6.1f} Hz | amplitud estimada {magnitud[i]:.3f}')
print(f'Cuarto valor más alto: {frecuencias[np.argsort(magnitud)[-4]]:.1f} Hz, amplitud {np.sort(magnitud)[-4]:.3f}')

plt.figure(figsize = (8, 4.2))
plt.plot(frecuencias, magnitud, color = '#1B3A4B', lw = 1.2)
for i, nombre in zip(picos, notas_acorde):
    plt.annotate(f'{nombre}\n{frecuencias[i]:.0f} Hz', (frecuencias[i], magnitud[i]),
                 xytext = (12, -4), textcoords = 'offset points', fontsize = 10, color = '#F78154')
plt.xlim(0, 1000)
plt.ylim(0, 0.6)
plt.title('Espectro de magnitud del acorde de La mayor', fontsize = 16)
plt.xlabel('Frecuencia (Hz)')
plt.ylabel('Amplitud estimada')
plt.grid(alpha = 0.3)
plt.tight_layout()
plt.show()
Número de bins: 8001 | resolución: 1.0 Hz
Pico en  440.0 Hz | amplitud estimada 0.500
Pico en  554.0 Hz | amplitud estimada 0.237
Pico en  659.0 Hz | amplitud estimada 0.179
Cuarto valor más alto: 555.0 Hz, amplitud 0.139
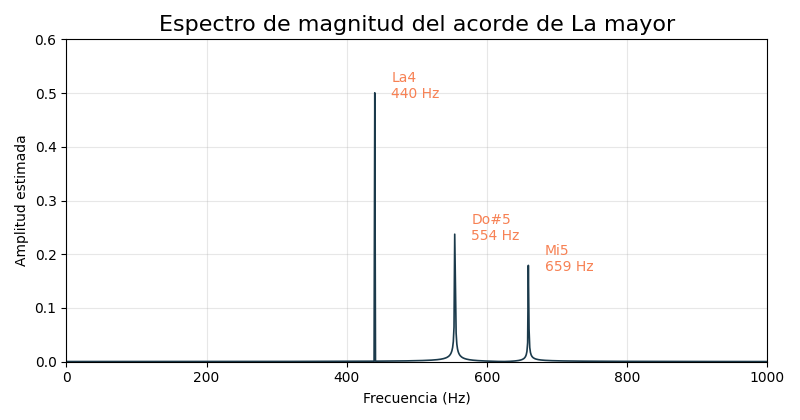
La FFT recupera las tres notas del acorde: picos en $440$, $554$ y $659$ Hz. El espectro tiene $8,001$ intervalos, uno por hercio de $0$ a $8,000$ Hz, exactamente $N/2 + 1$. Lo que el gráfico anterior muestra en una línea limpia es lo que la forma de onda escondía en una maraña.
Las amplitudes merecen una lectura más cuidadosa. La4 se estima en $0.500$, su valor exacto, porque $440$ Hz cae justo sobre un intervalo. Do#5, en cambio, se estima en $0.237$ en lugar de $0.3$, y Mi5 en $0.179$ en lugar de $0.2$. La causa es la fuga espectral: $554.37$ Hz cae entre los intervalos de $554$ y $555$ Hz, y su energía se reparte entre ambos y sus vecinos. Por eso el cuarto valor más alto del espectro no es una cuarta nota, sino el intervalo de $555$ Hz, con $0.139$, que es parte del mismo Do#5. La teoría lo predice con precisión: con una ventana rectangular, un tono desplazado $0.37$ intervalos conserva una fracción $\left|\frac{\sin(0.37\pi)}{0.37\pi}\right| \approx 0.79$ de su amplitud en el intervalo más cercano, y $0.3 \times 0.79 = 0.237$.
La FFT dice qué frecuencias hay en una señal, pero no cuándo suenan. Para un acorde que dura un segundo entero no importa, pero una melodía, una frase hablada o una canción cambian de frecuencia cada pocos milisegundos. Si se calcula una sola FFT de una frase entera, se obtienen todas las frecuencias de todas las sílabas superpuestas, sin orden. Hace falta una herramienta que mire el espectro por tramos.
La STFT y el espectrograma
La transformada de Fourier de tiempo corto (o STFT, por sus siglas en inglés: “Short-Time Fourier Transform”) resuelve ese problema con una idea sencilla: cortar la señal en tramos breves que se solapan, multiplicar cada tramo por una ventana que lo suaviza en los bordes y calcular la FFT de cada tramo por separado. El resultado es una matriz con el tiempo en las columnas y la frecuencia en las filas: el espectrograma.
$$ X[m, k] = \sum_{n=0}^{N-1} x[n + mH] , w[n] , e^{-i 2\pi k n / N}, \qquad \Delta f = \frac{f_s}{N}, \quad \Delta t = \frac{H}{f_s} $$
La lógica detrás de esta fórmula es la siguiente:
- $N$ es el tamaño de cada tramo y de su FFT (
n_fften librosa), y $H$ es el salto entre el inicio de un tramo y el del siguiente (hop_length). El tramo $m$ empieza en la muestra $mH$. - $w[n]$ es la ventana. La de Hann sube suavemente desde cero, llega a uno en el centro y vuelve a cero; así se evita que los cortes bruscos de cada tramo inventen frecuencias que no existen.
- La resolución en frecuencia es $\Delta f = f_s / N$, y la resolución en tiempo depende de dos cosas: el salto $H / f_s$ dice cada cuánto se toma una foto, y la longitud de la ventana $N / f_s$ dice cuánto tiempo abarca cada foto.
- En conclusión, $N$ grande da frecuencias finas pero mezcla en una misma foto lo que pasó en un intervalo largo; $N$ pequeño ve los cambios rápidos pero con frecuencias gruesas. Es el compromiso tiempo y frecuencia, y no hay ajuste que lo elimine.
Para ver una STFT en acción hace falta una señal que cambie en el tiempo. Sofía propone la melodía con la que calienta antes de practicar: Do4, Mi4, Sol4 y Do5, medio segundo cada nota, el arpegio de Do mayor. Para que suene a cuerda pulsada y no a un pitido de laboratorio, cada nota lleva su fundamental y dos armónicos (el doble y el triple de la frecuencia, con amplitudes $1$, $0.5$ y $0.25$), y una envolvente: un ataque de $10$ ms, una caída exponencial como la de una cuerda que deja de vibrar y una salida de $30$ ms. Sin esa salida, cada nota terminaría de golpe en un valor distinto de cero y se oiría un chasquido en cada cambio. Se añade además un ruido de fondo muy débil, de desviación $0.002$, generado con la semilla de la serie, para que el espectrograma tenga el piso de ruido que tiene cualquier grabación real. El bloque guarda el resultado en melodia.wav:
# Melodía de cuatro notas con timbre de cuerda pulsada y archivo WAV en Python:
notas_melodia = {'Do4': 261.63, 'Mi4': 329.63, 'Sol4': 392.00, 'Do5': 523.25}
dur_nota = 0.5
t_nota = np.arange(int(dur_nota * fs)) / fs

# Envolvente: ataque de 10 ms, caída exponencial y salida de 30 ms sin chasquidos:
envolvente = np.minimum(t_nota / 0.010, 1.0) * np.exp(-3 * t_nota)
envolvente *= np.minimum((dur_nota - t_nota) / 0.030, 1.0)

def nota_pulsada(f):
    # Fundamental y dos armónicos con amplitudes 1, 0.5 y 0.25:
    return sum(a * tono(k * f, dur_nota, fs) for k, a in [(1, 1.0), (2, 0.5), (3, 0.25)]) * envolvente

y = np.concatenate([nota_pulsada(f) for f in notas_melodia.values()])
y += rng.normal(0, 0.002, len(y))
y = 0.8 * y / np.max(np.abs(y))
ruta_melodia = carpeta_audio / 'melodia.wav'
wavfile.write(ruta_melodia, fs, np.round(y * 32767).astype(np.int16))
print(f'Melodía: {len(y)} muestras | {len(y) / fs:.1f} s | pico {np.max(np.abs(y)):.2f}')
print(f'{ruta_melodia.as_posix()} | {ruta_melodia.stat().st_size} bytes')
Melodía: 32000 muestras | 2.0 s | pico 0.80
cuaderno_vivo/audio/melodia.wav | 64044 bytes
La melodía tiene $32,000$ muestras, $2$ segundos a $16,000$ Hz, normalizada a un pico de $0.8$ para dejar margen antes del recorte. El archivo ocupa $64,044$ bytes: $32,000$ muestras de $2$ bytes más $44$ bytes de cabecera, el tamaño estándar de la cabecera de un WAV sin metadatos. La función scipy.io.wavfile.write decide el formato por el tipo del arreglo: al recibir enteros int16 escribe PCM de $16$ bits, lo mismo que haría soundfile.write(ruta, y, 16000, subtype = 'PCM_16').
El siguiente bloque construye la STFT a mano en cuatro líneas: sliding_window_view corta la señal en tramos de $1,024$ muestras, el paso [::256] aplica el salto, cada tramo se multiplica por la ventana de Hann y np.fft.rfft calcula todas las FFT a la vez. Después convierte la magnitud a decibelios relativos al máximo, con un piso de $-80$ dB, que es exactamente lo que hace librosa.amplitude_to_db(S, ref = np.max, top_db = 80):
# STFT a mano con ventana de Hann y espectrograma en dB en Python:
n_fft, hop = 1024, 256
ventana = signal.windows.hann(n_fft, sym = False)
marcos = np.lib.stride_tricks.sliding_window_view(y, n_fft)[::hop]
S = np.abs(np.fft.rfft(marcos * ventana, axis = 1)).T

# Decibelios relativos al máximo, con un piso de -80 dB:
S_db = np.maximum(20 * np.log10(np.maximum(S, 1e-10) / S.max()), -80)
f_bins = np.fft.rfftfreq(n_fft, 1 / fs)
t_marcos = (np.arange(S.shape[1]) * hop + n_fft / 2) / fs
print('Forma del espectrograma (bins x marcos):', S_db.shape)
print(f'Resolución: {fs / n_fft:.3f} Hz por bin | {1000 * hop / fs:.0f} ms por salto')

# Bin más fuerte en el centro de cada nota frente a la frecuencia real:
for j, (nombre, f) in enumerate(notas_melodia.items()):
    marco = np.argmin(np.abs(t_marcos - (j + 0.5) * dur_nota))
    print(f'{nombre:<5} real {f:>7.2f} Hz | bin más fuerte {f_bins[np.argmax(S[:, marco])]:>7.2f} Hz')

plt.figure(figsize = (8, 4.6))
plt.pcolormesh(t_marcos, f_bins, S_db, shading = 'auto', cmap = 'magma')
plt.colorbar(label = 'dB respecto al máximo')
plt.ylim(0, 4000)
plt.title('Espectrograma de la melodía (n_fft = 1024, salto = 256)', fontsize = 14)
plt.xlabel('Tiempo (s)')
plt.ylabel('Frecuencia (Hz)')
plt.tight_layout()
plt.show()
Forma del espectrograma (bins x marcos): (513, 122)
Resolución: 15.625 Hz por bin | 16 ms por salto
Do4   real  261.63 Hz | bin más fuerte  265.62 Hz
Mi4   real  329.63 Hz | bin más fuerte  328.12 Hz
Sol4  real  392.00 Hz | bin más fuerte  390.62 Hz
Do5   real  523.25 Hz | bin más fuerte  515.62 Hz
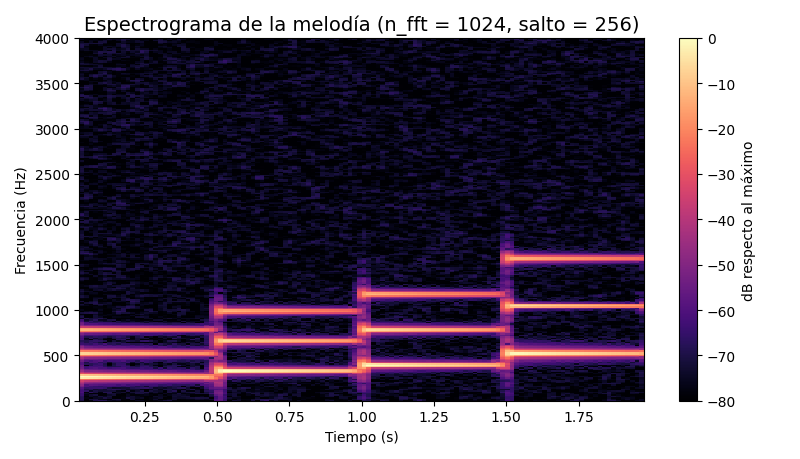
El espectrograma tiene $513$ intervalos de frecuencia ($1,024/2 + 1$) y $122$ marcos, uno cada $16$ ms. Cada intervalo mide $15.625$ Hz. En el gráfico anterior se leen las cuatro notas como escalones de izquierda a derecha y, encima de cada fundamental, sus dos armónicos: la primera nota muestra líneas cerca de $262$, $523$ y $785$ Hz, y la última, cerca de $523$, $1,047$ y $1,570$ Hz. El brillo se apaga dentro de cada nota por la caída exponencial de la envolvente, y en cada cambio de nota aparece una franja vertical tenue: es el ataque, un cambio brusco que, como cualquier evento breve, reparte energía por muchas frecuencias.
La comparación de la salida entre la frecuencia real y el intervalo más fuerte muestra el precio de la resolución. Do4, a $261.63$ Hz, aparece en $265.62$ Hz; Do5, a $523.25$ Hz, en $515.62$ Hz. Ninguna nota cae exactamente en un intervalo, así que el espectrograma la redondea al más cercano, con un error de hasta la mitad de $15.625$ Hz. Para un modelo de voz eso no es grave, porque la información está en el patrón completo de armónicos y no en un intervalo aislado; para un afinador de guitarra sí lo sería, y por eso los afinadores usan ventanas mucho más largas o métodos específicos de estimación de la altura tonal, como librosa.pyin.
Equivalencias con librosa: el bloque anterior equivale a np.abs(librosa.stft(y, n_fft = 1024, hop_length = 256, window = 'hann', center = False)). Con el valor por omisión center = True, librosa rellena la señal con $512$ muestras a cada lado y obtiene $126$ marcos en lugar de $122$, con el primer marco centrado en el instante cero. El dibujo con librosa.display.specshow(S_db, sr = 16000, hop_length = 256, x_axis = 'time', y_axis = 'linear') es el mismo que hace aquí plt.pcolormesh.
La escala mel
El espectrograma de la melodía tiene $513$ números por marco, pero la mayoría de ellos describe con un detalle de $15.625$ Hz unas frecuencias agudas que el oído agrupa en regiones mucho más anchas. El oído humano no percibe la frecuencia de forma lineal: la distancia entre $100$ y $200$ Hz suena enorme (una octava completa), mientras que la distancia entre $7,000$ y $7,100$ Hz apenas se nota. En 1937, Stevens, Volkmann y Newman pidieron a oyentes que ajustaran un tono hasta que sonara “a la mitad de altura” que otro y construyeron con esas respuestas una escala de altura percibida, la escala mel (de “melodía”). La fórmula más usada hoy para aproximarla es:
$$ m = 2595 \log_{10}\left(1 + \frac{f}{700}\right) $$
La lógica detrás de esta fórmula es la siguiente:
- Por debajo de unos $700$ Hz, el cociente $f / 700$ es pequeño y $\log_{10}(1 + u) \approx u / \ln 10$, de modo que la escala es casi lineal: cada hercio vale aproximadamente $1.4$ mel.
- Por encima de $700$ Hz domina el logaritmo, y cada duplicación de la frecuencia añade una cantidad de mel parecida, como hace el oído con las octavas.
- La constante $2595$ está elegida para que $1,000$ Hz correspondan a unos $1,000$ mel, el punto de anclaje de la escala original.
- En conclusión, la escala mel estira las frecuencias graves, donde están la voz y la altura de las notas, y comprime las agudas, donde basta con saber cuánta energía hay en regiones anchas.
Espectrograma de mel
Un espectrograma de mel agrupa los intervalos de frecuencia del espectrograma en bandas que son igual de anchas en la escala mel. Cada banda es un filtro triangular: sube desde el centro de la banda anterior, llega a uno en su propio centro y baja hasta el centro de la siguiente. Como los centros están equiespaciados en mel, los filtros son estrechos en los graves y anchos en los agudos. Al multiplicar la matriz de filtros por la potencia del espectrograma (la magnitud al cuadrado) se obtiene la energía de cada banda en cada marco.
El siguiente bloque define las funciones de conversión entre hercios y mel, construye un banco de $64$ filtros entre $0$ y $8,000$ Hz, calcula el espectrograma de mel en decibelios y, a partir de él, los MFCC que se explican en el apartado siguiente:
# Banco de filtros de mel, espectrograma de mel y MFCC en Python:
def hz_a_mel(f):
    return 2595 * np.log10(1 + np.asarray(f) / 700)

def mel_a_hz(m):
    return 700 * (10 ** (np.asarray(m) / 2595) - 1)

def banco_mel(n_mels, n_fft, fs, f_min = 0.0, f_max = None):
    # Triángulos con centros equiespaciados en mel (convención HTK):
    f_max = f_max or fs / 2
    bordes = mel_a_hz(np.linspace(hz_a_mel(f_min), hz_a_mel(f_max), n_mels + 2))
    f_bins = np.fft.rfftfreq(n_fft, 1 / fs)
    banco = np.zeros((n_mels, len(f_bins)))
    for m in range(n_mels):
        izq, centro, der = bordes[m], bordes[m + 1], bordes[m + 2]
        subida = (f_bins - izq) / (centro - izq)
        bajada = (der - f_bins) / (der - centro)
        banco[m] = np.maximum(0, np.minimum(subida, bajada))
    return banco, bordes

banco, bordes = banco_mel(64, n_fft, fs)
mel_pot = banco @ (S ** 2)
mel_db = np.maximum(10 * np.log10(np.maximum(mel_pot, 1e-10) / mel_pot.max()), -80)

# MFCC: transformada de coseno discreta del logaritmo de la energía de mel:
mfcc = dct(mel_db, type = 2, norm = 'ortho', axis = 0)[:13]
print('Banco de filtros:', banco.shape, '| espectrograma de mel:', mel_db.shape, '| MFCC:', mfcc.shape)
print(f'Ancho del primer filtro: {bordes[2] - bordes[0]:.1f} Hz | del último: {bordes[-1] - bordes[-3]:.1f} Hz')
print(f'Compresión: {S.shape[0]} bins -> 64 bandas -> 13 coeficientes por marco')
print(f'Coeficiente 0 (energía media): de {mfcc[0].min():.1f} a {mfcc[0].max():.1f} | coeficientes 1 a 12: de {mfcc[1:].min():.1f} a {mfcc[1:].max():.1f}')

fig, (eje1, eje2) = plt.subplots(2, 1, figsize = (8, 6.4), sharex = True)
malla = eje1.pcolormesh(t_marcos, np.arange(64), mel_db, shading = 'auto', cmap = 'magma')
fig.colorbar(malla, ax = eje1, label = 'dB')
eje1.set_title('Espectrograma de mel (64 bandas)', fontsize = 13)
eje1.set_ylabel('Banda de mel')
limite = np.abs(mfcc[1:]).max()
malla2 = eje2.pcolormesh(t_marcos, np.arange(1, 13), mfcc[1:], shading = 'auto', cmap = 'coolwarm',
                        vmin = -limite, vmax = limite)
fig.colorbar(malla2, ax = eje2, label = 'Valor')
eje2.set_title('MFCC 1 a 12 (el coeficiente 0 se omite del color)', fontsize = 13)
eje2.set_ylabel('Coeficiente')
eje2.set_xlabel('Tiempo (s)')
fig.suptitle('Dos vistas compactas de la misma melodía', fontsize = 16)
plt.tight_layout()
plt.show()
Banco de filtros: (64, 513) | espectrograma de mel: (64, 122) | MFCC: (13, 122)
Ancho del primer filtro: 56.4 Hz | del último: 649.1 Hz
Compresión: 513 bins -> 64 bandas -> 13 coeficientes por marco
Coeficiente 0 (energía media): de -503.9 a -413.3 | coeficientes 1 a 12: de -78.2 a 109.0
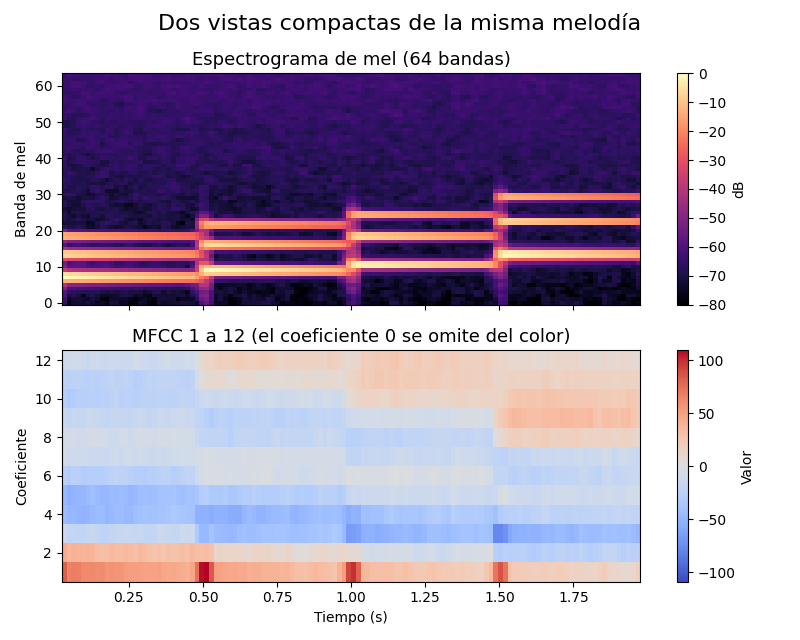
El banco de filtros es una matriz de $64 \times 513$ que convierte cada marco de $513$ intervalos en $64$ bandas: el espectrograma de mel tiene forma $64 \times 122$, ocho veces menos números que el original, y los MFCC, $13 \times 122$, casi cuarenta veces menos. La diferencia de anchos resume la escala mel: el primer filtro abarca $56.4$ Hz y el último, $649.1$ Hz, más de once veces más.
En el panel superior del gráfico anterior se ven las mismas cuatro notas y sus armónicos, pero ahora ocupan la mitad inferior de la imagen: las bandas $5$ a $30$ cubren de unos $200$ a unos $1,700$ Hz, la región donde vive casi toda la información de la melodía, mientras que las bandas superiores, que reúnen miles de hercios cada una, solo contienen el ruido de fondo. Esa redistribución es exactamente lo que se busca: dar más resolución a lo que el oído distingue mejor.
Este bloque equivale a librosa.feature.melspectrogram(S = S ** 2, sr = 16000, n_mels = 64, htk = True, norm = None) seguido de librosa.power_to_db(..., ref = np.max). Las dos opciones del final importan: por omisión, librosa usa la variante de Slaney de la escala mel (htk = False) y normaliza cada filtro por su ancho (norm = 'slaney'), así que sus cifras no coinciden con las de la fórmula de este apartado salvo que se le indique lo contrario. Verá la diferencia numérica entre ambas variantes en la sección siguiente.
MFCC
Los coeficientes cepstrales en las frecuencias de mel (o MFCC, por sus siglas en inglés: “Mel-Frequency Cepstral Coefficients”) son una compresión más del espectrograma de mel. Se calculan aplicando a cada marco la transformada de coseno discreta (o DCT, por sus siglas en inglés: “Discrete Cosine Transform”) sobre el logaritmo de la energía de las bandas y quedándose con los primeros coeficientes:
$$ c_q = \sqrt{\frac{2 - \delta_{q0}}{J}} \sum_{j=0}^{J-1} \log E_j , \cos\left(\frac{\pi q ,(j + \frac{1}{2})}{J}\right), \qquad q = 0, 1, \dots, 12 $$
La lógica detrás de esta fórmula es la siguiente:
- $E_j$ es la energía de la banda de mel $j$ en un marco, y $J = 64$ es el número de bandas. El logaritmo convierte los productos en sumas y se parece a la forma en que el oído percibe la intensidad.
- Cada coeficiente $c_q$ compara el perfil de energía de las $64$ bandas con un coseno que da $q/2$ oscilaciones a lo largo de ellas. El coeficiente $0$ es simplemente la energía media del marco; el $1$ dice si hay más energía en los graves o en los agudos; los siguientes describen ondulaciones cada vez más finas del perfil.
- El factor $\sqrt{(2 - \delta_{q0})/J}$ es la normalización ortonormal (
norm = 'ortho'), con $\delta_{q0} = 1$ si $q = 0$ y $0$ en otro caso; es la misma que usa librosa. - En conclusión, quedarse con los $13$ primeros coeficientes es quedarse con la forma suave del espectro, su envolvente, y descartar el detalle fino de cada armónico.
Por eso se dice que los MFCC son una “huella” del timbre: en la voz, la envolvente del espectro la dibujan las resonancias de la garganta, la boca y la nariz (los formantes), que distinguen una “a” de una “i” y una persona de otra, mientras que el detalle fino corresponde sobre todo a la altura de la voz. En el panel inferior del gráfico anterior, el coeficiente $0$ se ha retirado del color porque su escala es otra: según la salida, va de $-503.9$ a $-413.3$, mientras que los coeficientes $1$ a $12$ se mueven entre $-78.2$ y $109.0$. Se ve que el patrón cambia en cada nota y que en los ataques aparecen marcos distintos, más rojos en el coeficiente $1$.
Una advertencia honesta sobre este ejemplo: la melodía tiene solo tres armónicos por nota, así que su “envolvente” es muy pobre y los MFCC cambian sobre todo con la altura de la nota, no con un timbre. En voz real, con decenas de armónicos y formantes marcados, los MFCC sí separan bien vocales y hablantes, y durante tres décadas fueron la entrada estándar del reconocimiento de voz, desde el trabajo de Davis y Mermelstein de 1980. Hoy los modelos neuronales prefieren el espectrograma de mel completo, porque pueden aprender por sí mismos qué detalle conservar.
Afinar la lupa: parámetros y conversiones
Las tres representaciones del día dependen de parámetros que la mayoría de los tutoriales copian sin explicar: n_fft = 2048, hop_length = 512, n_mels = 128. ¿De dónde salen esos números y qué pasa si se cambian? Esta sección responde con dos cálculos breves: una tabla de resoluciones de la STFT y una comparación de las variantes de la escala mel.
Resoluciones de la STFT
El siguiente bloque calcula, para tres tamaños de FFT y dos saltos, la longitud de la ventana, el salto en milisegundos, la resolución en frecuencia, el porcentaje de solapamiento entre ventanas consecutivas y el número de marcos que produciría la melodía de $2$ segundos:
# Tabla de resoluciones de la STFT a 16 000 Hz en Python:
filas = []
for n in [512, 1024, 2048]:
    for h in [128, 256]:
        filas.append({'n_fft': n, 'hop_length': h,
                      'ventana_ms': 1000 * n / fs, 'salto_ms': 1000 * h / fs,
                      'hz_por_bin': fs / n, 'solape_%': 100 * (1 - h / n),
                      'marcos_en_2s': (len(y) - n) // h + 1})
resoluciones = pd.DataFrame(filas)
print(resoluciones.round(2).to_string(index = False))
 n_fft  hop_length  ventana_ms  salto_ms  hz_por_bin  solape_%  marcos_en_2s
   512         128        32.0       8.0       31.25     75.00           247
   512         256        32.0      16.0       31.25     50.00           124
  1024         128        64.0       8.0       15.62     87.50           243
  1024         256        64.0      16.0       15.62     75.00           122
  2048         128       128.0       8.0        7.81     93.75           235
  2048         256       128.0      16.0        7.81     87.50           118
La Tabla 2 reúne esas cifras en el formato de la serie.
Tabla 2. Parámetros de la STFT y su resolución en tiempo y en frecuencia a 16 000 Hz.
| n_fft | hop_length | Ventana (ms) | Salto (ms) | Hz por intervalo | Solapamiento | Marcos en 2 s |
|---|---|---|---|---|---|---|
| 512 | 128 | 32 | 8 | 31.25 | 75 % | 247 |
| 512 | 256 | 32 | 16 | 31.25 | 50 % | 124 |
| 1024 | 128 | 64 | 8 | 15.62 | 87.5 % | 243 |
| 1024 | 256 | 64 | 16 | 15.62 | 75 % | 122 |
| 2048 | 128 | 128 | 8 | 7.81 | 93.75 % | 235 |
| 2048 | 256 | 128 | 16 | 7.81 | 87.5 % | 118 |
La tabla hace visible el compromiso tiempo y frecuencia. Con n_fft = 512, cada intervalo mide $31.25$ Hz: Do4 ($261.63$ Hz) y Mi4 ($329.63$ Hz), separados por $68$ Hz, quedan a poco más de dos intervalos de distancia y, con el lóbulo ancho de la ventana de Hann, sus picos casi se tocan. Con n_fft = 2048, los intervalos miden $7.81$ Hz, pero cada ventana abarca $128$ ms, una cuarta parte de cada nota de la melodía y más que la duración de muchas consonantes del habla. La configuración elegida, n_fft = 1024 con salto $256$, da $15.62$ Hz y una foto cada $16$ ms con un solapamiento del $75%$: el punto medio habitual en voz a $16,000$ Hz.
Observe también que el salto, y no el tamaño de la ventana, decide cuántos marcos hay: con salto $128$ se obtienen el doble de marcos que con $256$, para cualquier n_fft. Más marcos significan más datos que el modelo debe procesar, y en un modelo de voz eso se traduce en más memoria y más tiempo de cálculo por segundo de audio.
Hercios y mel, ida y vuelta
La fórmula de mel de este día se conoce como variante HTK, por el conjunto de herramientas de reconocimiento de voz en el que se popularizó. A menudo aparece escrita con logaritmo natural, $m = 1127 \ln(1 + f/700)$; ambas formas son la misma función, porque $2595 / \ln 10 \approx 1127$. La variante de Slaney, la que librosa usa por omisión, es lineal hasta $1,000$ Hz y logarítmica por encima, y usa otras unidades. El siguiente bloque compara las tres y comprueba que mel_a_hz deshace exactamente lo que hace hz_a_mel:
# Conversión de hercios a mel: fórmula HTK, forma natural y variante de Slaney en Python:
def hz_a_mel_slaney(f):
    # Lineal hasta 1 000 Hz y logarítmica por encima (la opción por omisión de librosa):
    f = np.asarray(f, dtype = float)
    lineal = f / (200 / 3)
    paso_log = np.log(6.4) / 27
    return np.where(f < 1000, lineal, 15 + np.log(np.maximum(f, 1e-9) / 1000) / paso_log)

prueba = np.array([100, 440, 1000, 4000, 8000])
conversion = pd.DataFrame({
    'hz': prueba,
    'mel_htk': hz_a_mel(prueba),
    'mel_1127_ln': 1127 * np.log(1 + prueba / 700),
    'ida_y_vuelta_hz': mel_a_hz(hz_a_mel(prueba)),
    'mel_slaney': hz_a_mel_slaney(prueba),
})
print(conversion.round(2).to_string(index = False))
print(f'Mel por cada Hz cerca de 100 Hz: {(hz_a_mel(101) - hz_a_mel(100)):.3f} | cerca de 8000 Hz: {(hz_a_mel(8001) - hz_a_mel(8000)):.3f}')
  hz  mel_htk  mel_1127_ln  ida_y_vuelta_hz  mel_slaney
 100   150.49       150.49            100.0        1.50
 440   549.64       549.64            440.0        6.60
1000   999.99       999.99           1000.0       15.00
4000  2146.06      2146.08           4000.0       35.16
8000  2840.02      2840.04           8000.0       45.25
Mel por cada Hz cerca de 100 Hz: 1.408 | cerca de 8000 Hz: 0.130
La Tabla 4 resume la comparación para cinco frecuencias, desde una voz grave hasta el límite de Nyquist del día.
Tabla 4. Conversión de cinco frecuencias a la escala mel en sus variantes HTK y Slaney.
| Frecuencia (Hz) | Mel HTK (2595 log10) | Mel HTK (1127 ln) | Ida y vuelta (Hz) | Mel Slaney (librosa por omisión) |
|---|---|---|---|---|
| 100 | 150.49 | 150.49 | 100.0 | 1.50 |
| 440 | 549.64 | 549.64 | 440.0 | 6.60 |
| 1 000 | 999.99 | 999.99 | 1 000.0 | 15.00 |
| 4 000 | 2 146.06 | 2 146.08 | 4 000.0 | 35.16 |
| 8 000 | 2 840.02 | 2 840.04 | 8 000.0 | 45.25 |
Las dos escrituras de la fórmula HTK coinciden hasta la segunda decimal y solo se separan en una centésima a $4,000$ y $8,000$ Hz, por el redondeo de las constantes $2595$ y $1127$. La ida y vuelta recupera exactamente las cinco frecuencias, de modo que el banco de filtros del bloque 8 coloca sus bordes donde debe. La última línea de la salida cuantifica la compresión de la escala: cerca de $100$ Hz, un hercio vale $1.408$ mel; cerca de $8,000$ Hz, solo $0.130$ mel, más de diez veces menos.
La columna de Slaney muestra por qué conviene fijar la variante: $1,000$ Hz son $15$ en sus unidades y casi $1,000$ en las de HTK. Mezclar un banco de filtros entrenado con una variante y una conversión calculada con la otra es un error silencioso: no da ningún aviso, pero desplaza todas las bandas. Si en los días siguientes un modelo pide “espectrogramas de mel de $80$ bandas”, su documentación o su código dirán con qué variante; esa es la que hay que usar.
Cómo representan el audio los modelos generativos
Con estas piezas ya se puede leer el mapa de los sistemas de voz y audio que usará el resto del módulo. Hay dos grandes familias, y la diferencia entre ellas está precisamente en la representación intermedia.
Espectrograma de mel más vocodificador
La primera familia divide el trabajo en dos modelos. Un modelo acústico convierte el texto (o una descripción) en un espectrograma de mel, y un vocodificador (vocoder) convierte ese espectrograma en una forma de onda. Es la arquitectura de Tacotron 2 (Shen y colaboradores, 2018), que predecía espectrogramas de mel de $80$ bandas y usaba una versión de WaveNet como vocodificador, y de muchos sistemas posteriores que sustituyeron WaveNet por vocodificadores mucho más rápidos, como HiFi-GAN (Kong, Kim y Bae, 2020).
¿Por qué hace falta un segundo modelo? Porque el espectrograma de mel es una representación con pérdida. Para obtenerlo se tomó el módulo de la STFT, así que se descartó la fase, y después se sumaron los intervalos dentro de cada banda, así que se perdió el detalle fino. Invertirlo exige “inventar” de forma plausible la información que falta, y eso es justamente lo que aprende el vocodificador. Cuando una voz sintética suena metálica o con un zumbido, la causa suele estar en esta etapa.
Fichas de un códec neuronal
La segunda familia trata el audio como trata el texto un modelo de lenguaje: como una secuencia de fichas discretas. Un códec neuronal, como SoundStream (Zeghidour y colaboradores, 2021) o EnCodec (Défossez y colaboradores, 2022), comprime la forma de onda en una secuencia de vectores, uno por marco, y cuantiza cada vector con varios libros de códigos sucesivos (cuantización vectorial residual): el primero captura lo grueso, y cada uno de los siguientes corrige el error del anterior. Cada marco queda descrito por unos pocos enteros, y un modelo de lenguaje puede aprender a predecir el siguiente entero como predecía la siguiente palabra en el Día 3. VALL-E (2023) y muchos modelos de voz y música actuales trabajan así, y el decodificador del códec hace el papel del vocodificador.
La Tabla 5 compara cuántos números por segundo produce cada representación. Las configuraciones de HiFi-GAN y EnCodec son las publicadas en sus artículos; las demás son las de este día.
Tabla 5. Cantidad de datos por segundo de audio en cada representación.
| Representación | Configuración | Marcos por segundo | Valores por marco | Valores por segundo |
|---|---|---|---|---|
| Forma de onda PCM | 16 000 Hz, 16 bits | 16 000 | 1 | 16 000 (256 kbit/s) |
| Espectrograma de mel (este día) | 64 bandas, salto 256 a 16 000 Hz | 62.5 | 64 | 4 000 |
| MFCC (este día) | 13 coeficientes, salto 256 a 16 000 Hz | 62.5 | 13 | 812.5 |
| Mel de vocodificador (HiFi-GAN) | 80 bandas, salto 256 a 22 050 Hz | 86.13 | 80 | 6 890.6 |
| Fichas de EnCodec | 24 000 Hz, 8 libros de 1 024 códigos | 75 | 8 | 600 (6 kbit/s) |
Las cifras explican por qué los modelos generativos no suelen trabajar directamente sobre la onda. Generar $16,000$ valores por segundo, uno tras otro, es lo que hacía WaveNet, y era extraordinariamente lento. El espectrograma de mel reduce la secuencia a $62.5$ o $86$ marcos por segundo, y las fichas de EnCodec, a $75$ marcos de $8$ enteros, cada uno de $10$ bits ($2^{10} = 1,024$ códigos), es decir, $6,000$ bits por segundo: unas $43$ veces menos que la onda PCM de $16$ bits a $16,000$ Hz, y $64$ veces menos que la de $24,000$ Hz que comprime EnCodec. Un modelo que predice $600$ fichas por segundo se parece mucho más a un modelo de lenguaje que a un sintetizador de ondas.
Diego, cuando vio esta tabla, hizo la pregunta incómoda del día: si $600$ números por segundo bastan para reconstruir una voz reconocible, ¿cuántos segundos de su voz necesita alguien para imitarla? La respuesta, que el Día 15 tratará con detalle, es que los sistemas de clonación actuales funcionan con muestras de unos pocos segundos. Por eso este módulo trabaja solo con señales sintéticas y, cuando llegue la clonación, con la voz propia del lector y con consentimiento escrito.
Atención aquí: La voz es un dato biométrico. Permite identificar a una persona, y en muchas legislaciones, como el Reglamento General de Protección de Datos de la Unión Europea (artículo 9), los datos biométricos tratados para identificar a alguien son una categoría especial que exige un consentimiento explícito. En este módulo, “la voz de Sofía” es siempre una señal sintetizada con numpy; cuando se trabaje con voz real, será solo la del propio lector, grabada por él y con un consentimiento documentado en consentimiento_voz.json. No grabe ni procese la voz de otra persona sin su permiso escrito, aunque sea para un proyecto privado.
Guardar y escuchar
Un espectrograma se mira; un sonido se escucha. La última pieza del día es guardar el audio en un formato que cualquier reproductor entienda y comprobar que al guardarlo no se pierde calidad audible. El formato de trabajo del módulo es WAV con PCM de $16$ bits: sin compresión, sin pérdida y legible por cualquier biblioteca. Cada muestra en coma flotante entre $-1$ y $1$ se multiplica por $32,767$, el mayor entero de $16$ bits con signo, y se redondea. Ese redondeo introduce un error, el ruido de cuantización, cuya magnitud teórica para un seno a escala completa es:
$$ \text{SNR} \approx 6.02 , b + 1.76 \ \text{dB} $$
La lógica detrás de esta fórmula es la siguiente:
- La relación señal a ruido (o SNR, por sus siglas en inglés: “Signal-to-Noise Ratio”) compara la potencia de la señal con la del error, en decibelios: $10 \log_{10}(P_{\text{señal}} / P_{\text{ruido}})$.
- Cada bit adicional duplica el número de niveles, divide entre dos el tamaño del escalón y, por tanto, divide entre cuatro la potencia del error: $10 \log_{10} 4 = 6.02$ dB por bit.
- El término $1.76$ dB sale de comparar la potencia de un seno a escala completa ($1/2$) con la de un error repartido uniformemente en medio escalón ($\Delta^2 / 12$).
- En conclusión, $16$ bits dan unos $98$ dB de margen y $8$ bits, unos $50$ dB; pero la fórmula supone una señal que usa todo el rango, y una señal más baja pierde SNR en la misma proporción en que pierde potencia.
El siguiente bloque guarda el acorde (normalizado a un pico de $0.8$) y el tono del aliasing, relee uno de los archivos para comprobar su cabecera, lista los tres archivos del día y mide la SNR real de la cuantización a $8$ y a $16$ bits:
# Guardar en WAV de 16 bits, releer y medir el ruido de cuantización en Python:
def cuantizar(x, bits):
    nivel = 2 ** (bits - 1) - 1
    return np.round(x * nivel) / nivel

def snr_db(original, aproximada):
    return 10 * np.log10(np.sum(original ** 2) / np.sum((original - aproximada) ** 2))

archivos = {'acorde_la_mayor.wav': acorde / np.max(np.abs(acorde)) * 0.8,
            'alias_9000_hz.wav': 0.5 * tono(f_tono, 1.0, fs)}
for nombre, senal in archivos.items():
    wavfile.write(carpeta_audio / nombre, fs, np.round(senal * 32767).astype(np.int16))

# Relectura del archivo y comprobación de la cabecera:
fs_leida, datos_wav = wavfile.read(carpeta_audio / 'acorde_la_mayor.wav')
print('Leído:', fs_leida, 'Hz |', datos_wav.dtype, '|', datos_wav.shape, '| primeras muestras:', datos_wav[:4])
propios = ['acorde_la_mayor.wav', 'alias_9000_hz.wav', 'melodia.wav']
for nombre in propios:
    print(f'{nombre:<20} {(carpeta_audio / nombre).stat().st_size:>6} bytes')

# Relación señal a ruido medida frente a la teórica 6.02 b + 1.76 dB:
senal = archivos['acorde_la_mayor.wav']
for bits in [8, 16]:
    print(f'{bits:>2} bits | SNR medida {snr_db(senal, cuantizar(senal, bits)):5.1f} dB | teórica {6.02 * bits + 1.76:5.1f} dB')
Leído: 16000 Hz | int16 | (16000,) | primeras muestras: [    0  5307 10377 14984]
acorde_la_mayor.wav   32044 bytes
alias_9000_hz.wav     32044 bytes
melodia.wav           64044 bytes
 8 bits | SNR medida  43.8 dB | teórica  49.9 dB
16 bits | SNR medida  91.9 dB | teórica  98.1 dB
La relectura devuelve $16,000$ Hz, tipo int16 y $16,000$ muestras: la cabecera guarda la frecuencia de muestreo y el formato, de modo que cualquier programa que abra el archivo sabrá cómo interpretarlo. Las primeras muestras, $0$, $5,307$, $10,377$ y $14,984$, son el comienzo del acorde a escala entera: el seno arranca en cero y sube. Los tres archivos ocupan $32,044$, $32,044$ y $64,044$ bytes, $44$ bytes de cabecera más $2$ bytes por muestra.
La SNR medida es de $91.9$ dB con $16$ bits y de $43.8$ dB con $8$ bits, unos $6$ dB por debajo de la teoría en ambos casos. La diferencia no es un error, es la última viñeta de la fórmula: el acorde guardado tiene un pico de $0.8$ y un RMS de $0.4360 \times 0.8 / 0.9976 \approx 0.35$, frente a los $0.707$ de un seno a escala completa, y $20 \log_{10}(0.35 / 0.707) \approx -6.1$ dB. Con $16$ bits, el ruido de cuantización queda unos $92$ dB por debajo de la señal, por debajo de lo que el oído percibe en condiciones normales de escucha; con $8$ bits, el siseo de fondo ya es audible en los pasajes suaves. Por eso $16$ bits es el estándar del disco compacto y del audio de voz, y por eso no hace falta más para el Cuaderno Vivo.
Los archivos de un page bundle de Hugo se publican junto a la entrada, así que basta con copiarlos a la carpeta del post y añadir un reproductor HTML con la etiqueta <audio controls>. Estos son los tres archivos del día; escuche primero el acorde, después la melodía y, por último, el tono de $9,000$ Hz que suena a $7,000$ Hz:
Acorde de La mayor (1 s, 16 000 Hz, 16 bits)
Melodía Do4, Mi4, Sol4, Do5 (2 s, 16 000 Hz, 16 bits)
Tono de 9 000 Hz muestreado a 16 000 Hz (suena a 7 000 Hz; baje el volumen antes de reproducirlo)
El atributo preload="none" evita que el navegador descargue los archivos hasta que el lector pulse reproducir, y controls muestra los botones del navegador. Si usted reproduce este código en su propio blog, coloque los WAV en la misma carpeta que el index.md y haga referencia a ellos por su nombre, igual que a las figuras. Para archivos largos, como el resumen semanal narrado del Día 16, convendrá convertir a un formato comprimido (MP3 u Opus), porque un minuto de WAV a $16,000$ Hz ocupa casi $2$ MB.
Consideraciones finales
Este día no generó nada con inteligencia artificial y, sin embargo, es el cimiento de todo el módulo. Todo lo que sigue descansa en estas representaciones: el Día 14 convertirá texto en espectrogramas de mel y estos en ondas, el Día 15 medirá el parecido entre voces comparando sus vectores MFCC medios y el Día 16 mezclará la narración con música sintetizada y le añadirá una marca de agua de espectro ensanchado. Si algo falla en esos días, el diagnóstico empezará casi siempre por mirar un espectrograma.
Las cifras de hoy tienen límites claros. Las señales son sintéticas: tonos puros con dos armónicos y un ruido de fondo artificial, mucho más simples que una voz o una guitarra reales. Los MFCC de la melodía describen sobre todo la altura de cada nota y no un timbre, por la pobreza de su espectro. Las configuraciones de HiFi-GAN y EnCodec de la Tabla 5 son las de sus artículos originales; otras versiones usan otras. Ninguno de esos límites invalida el método, que es el mismo que se aplica a una grabación real.
Antes de pasar al día siguiente, conviene hacerse algunas preguntas:
- ¿A qué frecuencia de muestreo trabaja el modelo de voz que piensa usar, y a cuál está grabado su audio? Si no coinciden, ¿lo remuestrea con filtro?
- ¿Con qué variante de la escala mel, cuántas bandas y qué salto se entrenó el modelo? Un espectrograma calculado con otros parámetros no le sirve.
- ¿Su audio llega alguna vez a $1$ o a $-1$? Si es así, se está recortando y conviene normalizarlo con margen.
- ¿Qué parte de su voz, en número de segundos, queda guardada en su proyecto, y quién tiene acceso a ella?
Un gran libro que habla de esto es Fundamentos del procesamiento de música (o Fundamentals of Music Processing), en el que Meinard Müller explica la transformada de Fourier, la STFT, las representaciones de altura y de timbre y sus aplicaciones con ejemplos musicales y cuadernos de Python. Su lectura le ayudará a pasar de los tonos sintéticos de este día a grabaciones reales, y a entender por qué cada decisión de parámetros es en realidad una decisión sobre qué información del sonido se considera importante.
Un modelo de voz nunca escucha un sonido: lee la representación que usted le entrega, y lo que esa representación descarta no lo puede recuperar. La frecuencia de muestreo fija el techo de lo que existe, la STFT decide qué se ve en el tiempo y qué en la frecuencia, y la escala mel elige qué detalle conservar. Con un acorde de $16,000$ muestras, un alias de $7,000$ Hz y tres archivos WAV de $16$ bits, el Cuaderno Vivo ya sabe qué es un sonido; mañana aprenderá a producir uno a partir de un texto.
Conclusiones clave
Ondas y muestreo
- Un tono puro se describe con frecuencia, amplitud y fase, $x(t) = A \sin(2\pi f t + \phi)$, y los sonidos complejos son sumas de tonos: el acorde de La mayor suma $440$, $554.37$ y $659.25$ Hz, con un RMS de $0.4360$ que coincide con la teoría.
- Muestrear a $f_s$ solo permite representar frecuencias por debajo de $f_s/2$: a $16,000$ Hz, un tono de $9,000$ Hz produce exactamente las mismas muestras que uno de $7,000$ Hz invertido, con una diferencia de $9.94 \times 10^{-15}$.
- El aliasing no se puede eliminar después de muestrear; se evita con un filtro paso bajo antes de muestrear o de remuestrear.
- En WAV de $16$ bits, el ruido de cuantización del acorde queda $91.9$ dB por debajo de la señal; con $8$ bits, solo $43.8$ dB.
Frecuencia
- La FFT encuentra las tres notas del acorde en $440$, $554$ y $659$ Hz, con una resolución de $f_s/N = 1$ Hz; la fuga espectral reduce la amplitud estimada de Do#5 de $0.3$ a $0.237$.
- La STFT corta la señal en ventanas solapadas y da un espectrograma: con
n_fft = 1024y salto $256$ a $16,000$ Hz, cada intervalo mide $15.625$ Hz y cada marco avanza $16$ ms. - No hay parámetros que den a la vez resolución fina en tiempo y en frecuencia:
n_fft = 2048da $7.81$ Hz por intervalo, pero ventanas de $128$ ms.
Mel y MFCC
- La escala mel, $m = 2595 \log_{10}(1 + f/700)$, estira los graves y comprime los agudos como el oído: un hercio vale $1.408$ mel cerca de $100$ Hz y $0.130$ mel cerca de $8,000$ Hz.
- Un banco de $64$ filtros triangulares reduce $513$ intervalos a $64$ bandas, y la DCT de su logaritmo deja $13$ MFCC por marco, una huella compacta de la envolvente espectral.
- librosa usa por omisión la variante de Slaney ($1,000$ Hz son $15$ unidades, no $1,000$); hay que fijar
htkynormpara reproducir un modelo. - Los modelos generativos de voz trabajan con espectrogramas de mel y un vocodificador, o con fichas de un códec neuronal: EnCodec describe un segundo de audio con $600$ enteros de $10$ bits.
Mañana, en el Día 14: Síntesis de voz: del texto al habla. Con la onda, el espectrograma y la escala mel ya en la mano, verá cómo un sistema de síntesis convierte una frase escrita en sonido, desde una vocal fabricada con formantes en numpy hasta un modelo de texto a voz que el Cuaderno Vivo usará para leer en voz alta el resumen de Sofía.
Referencias
- Müller, M. (2021). Fundamentals of Music Processing: Using Python and Jupyter Notebooks (2.ª ed.). Springer.
- McFee, B., Raffel, C., Liang, D., Ellis, D. P. W., McVicar, M., Battenberg, E. y Nieto, O. (2015). librosa: Audio and Music Signal Analysis in Python. Proceedings of the 14th Python in Science Conference, 18-25.
- Stevens, S. S., Volkmann, J. y Newman, E. B. (1937). A Scale for the Measurement of the Psychological Magnitude Pitch. Journal of the Acoustical Society of America, 8(3), 185-190.
- Shannon, C. E. (1949). Communication in the Presence of Noise. Proceedings of the IRE, 37(1), 10-21.
- Davis, S. y Mermelstein, P. (1980). Comparison of Parametric Representations for Monosyllabic Word Recognition in Continuously Spoken Sentences. IEEE Transactions on Acoustics, Speech, and Signal Processing, 28(4), 357-366.
- Shen, J. et al. (2018). Natural TTS Synthesis by Conditioning WaveNet on Mel Spectrogram Predictions. IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 4779-4783.
- Kong, J., Kim, J. y Bae, J. (2020). HiFi-GAN: Generative Adversarial Networks for Efficient and High Fidelity Speech Synthesis. Advances in Neural Information Processing Systems, 33.
- Défossez, A., Copet, J., Synnaeve, G. y Adi, Y. (2022). High Fidelity Neural Audio Compression. arXiv:2210.13438.
- Virtanen, P. et al. (2020). SciPy 1.0: Fundamental Algorithms for Scientific Computing in Python. Nature Methods, 17, 261-272.