IA generativa en proyectos personales: Día 14
 Jeshua Romero Guadarrama
- 54 Min para leer
- 14 Jan, 2026
Índice de contenido
Resumen:
Un sistema de texto a voz no “lee” un texto: lo normaliza, lo convierte en fonemas, predice un espectrograma y lo transforma en una onda. En esta entrada se recorre esa cadena pieza por pieza con numpy y scipy: un normalizador de números y siglas, unas reglas de letras a fonemas, vocales sintetizadas con el modelo fuente-filtro, la entonación de una afirmación y de una pregunta medida con el algoritmo YIN y una envolvente ADSR. Después se usa un modelo VITS en español con coqui-tts para narrar un resumen que Claude escribe pensando en el oído, y se evalúa la voz con MOS y con la tasa de error de palabras. Al terminar, usted sabrá qué ocurre dentro de un TTS, cómo preparar el texto para que suene bien y cómo medir si una voz sintética es aceptable.
¿Cómo citar el presente artículo?
Romero, J. (14 de enero de 2026). IA generativa en proyectos personales: Día 14. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_14/.
IA generativa en proyectos personales: Día 14 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_14/.
Modelos, precios y regulación revisados en octubre de 2026.
Día 14. Síntesis de voz: del texto al habla
Introducción
Ayer, en el Día 13, vio que un sonido es una lista de números que se muestrea, se lleva al dominio de la frecuencia con la FFT y se dibuja como espectrograma de mel, y el Cuaderno Vivo ganó oídos: la capacidad de representar el audio con las mismas estructuras que usan los modelos de voz. Hoy toca el camino inverso. Ya no se trata de describir un sonido que existe, sino de fabricar uno a partir de un texto.
Sofía quiere escuchar su resumen semanal mientras camina a la universidad. Lleva dos semanas pidiéndole a Claude que resuma sus notas y leyendo el resultado en la pantalla del teléfono, pero el resumen llega a una hora en la que tiene las manos ocupadas con la guitarra o con la bolsa del mercado. Lo que necesita es que el cuaderno le lea en voz alta. Diego, fiel a su papel, ya tiene preguntas preparadas: ¿Cómo sabe usted que la voz pronuncia bien “3.84 USD”? y ¿Cómo va a demostrar que una voz suena mejor que otra, aparte de decir que “le gusta más”?
Las dos preguntas son buenas porque apuntan a los dos extremos de la cadena. La primera es un problema de texto: un modelo de voz no sabe que “USD” se lee “dólares” ni que “3.84” son tres dólares con ochenta y cuatro centavos, y si nadie se lo dice lo leerá letra por letra o lo saltará. La segunda es un problema de evaluación: la calidad de una voz es una opinión humana, y las opiniones también se pueden medir con método.
En la presente entrada, descubrirá cómo está organizado un sistema de texto a voz y qué hace cada etapa. Verá un normalizador de texto escrito a mano, unas reglas que convierten letras en fonemas del español, vocales sintetizadas con el modelo fuente-filtro (la idea que hay dentro de cada vocoder), la entonación de una afirmación y de una pregunta medida con el algoritmo YIN y la envolvente ADSR que evita los chasquidos. Después usará un modelo abierto en español con coqui-tts para narrar un resumen escrito por Claude Haiku 5.5, y terminará midiendo la calidad con la puntuación media de opinión (MOS) y la tasa de error de palabras (WER). La pieza que gana hoy el Cuaderno Vivo es una voz genérica: todavía no la de Sofía, pero sí una cadena completa del texto al archivo WAV.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Describir la cadena de un sistema TTS: normalización del texto, modelo acústico y vocoder.
- Sintetizar vocales con un modelo fuente-filtro (formantes) para entender qué hace un vocoder.
- Analizar la prosodia (frecuencia fundamental, duración y energía) de una frase.
- Usar un modelo TTS abierto en español con
coqui-ttsy narrar un resumen escrito por Claude. - Evaluar voces sintéticas con MOS y con la tasa de error de palabras (WER).
La cadena de un sistema TTS
Un sistema de texto a voz (o TTS, por sus siglas en inglés: “Text-to-Speech”) recibe una cadena de caracteres y devuelve una onda sonora. Entre los dos extremos hay varias transformaciones encadenadas, lo que en ingeniería se llama una cadena de procesamiento (o pipeline). Cada etapa resuelve un problema distinto y, sobre todo, falla de una manera distinta: si la voz dice “seis cero cero” en lugar de “seiscientas”, el error no está en la red neuronal, sino en la primera etapa.
Comencemos por preparar el entorno. Como el resto del módulo, todo el código ejecutable de hoy usa solo numpy, scipy, pandas y matplotlib; los archivos de audio se escriben con scipy.io.wavfile en la carpeta cuaderno_vivo/audio/ con el prefijo dia14_, y la frecuencia de muestreo es de $16,000$ Hz, la misma del Día 13:
# Importaciones base, semilla de la serie y carpeta de audio en Python:
import warnings
warnings.filterwarnings('ignore')
import re
from pathlib import Path
import numpy as np
import pandas as pd
import scipy
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
FS = 16000                     # frecuencia de muestreo del módulo, en Hz
carpeta = Path('cuaderno_vivo')
audio = carpeta / 'audio'
audio.mkdir(parents = True, exist_ok = True)
print('numpy', np.__version__, '| scipy', scipy.__version__, '| pandas', pd.__version__)
print('Frecuencia de muestreo:', FS, 'Hz | carpeta de audio:', audio.as_posix())
numpy 2.4.6 | scipy 1.17.1 | pandas 3.0.3
Frecuencia de muestreo: 16000 Hz | carpeta de audio: cuaderno_vivo/audio
La carpeta de audio ya existe y la semilla global de la serie, $2026$, queda fijada aunque hoy casi todo el código es determinista: las señales se construyen con fórmulas, no con números aleatorios.
La Tabla 1 resume las etapas de un TTS moderno con lo que entra, lo que sale y un ejemplo con la frase que acompañará toda la entrada.
Tabla 1. Etapas de la cadena de un sistema de texto a voz.
| Etapa | Entrada | Salida | Ejemplo con la frase de Sofía |
|---|---|---|---|
| Normalización | Texto con cifras, siglas y abreviaturas | Texto solo con palabras | “3.84 USD” pasa a “tres dólares con ochenta y cuatro centavos” |
| Conversión a fonemas | Palabras | Secuencia de fonemas | “centavos” pasa a /sentabos/ |
| Modelo acústico | Fonemas (y a veces un hablante) | Espectrograma de mel | Una matriz de 80 bandas por cientos de marcos |
| Vocoder | Espectrograma de mel | Onda (muestras) | $22,050$ números por segundo de audio |
| Posproceso | Onda | Archivo WAV o MP3 | dia14_resumen_semana.wav con la etiqueta “Voz generada con IA” |
Las dos primeras etapas forman la interfaz de texto (en inglés se le llama front-end) y en muchos sistemas siguen siendo reglas y diccionarios escritos por personas. Las dos siguientes son la parte neuronal, aprendida a partir de horas de grabaciones con su transcripción. Algunos modelos recientes, como VITS, juntan el modelo acústico y el vocoder en una sola red, pero la interfaz de texto sigue existiendo delante.
Normalizar el texto
Normalizar es reescribir el texto de modo que todo lo que aparezca se pueda pronunciar tal cual. Los números son el caso más frecuente, pero no el único: abreviaturas como “Dr.” o “pág.”, siglas como “IA” o “CSV”, unidades, fechas, horas, direcciones de correo y emojis. Cada una necesita una regla, y algunas dependen del contexto: “1” se lee “uno” al contar, pero “un” delante de “dólar” y “una” delante de “nota”.
El siguiente normalizador cubre solo lo que el Cuaderno Vivo necesita hoy: números de $0$ a $99$ con un diccionario, cantidades en dólares, decimales, cuatro abreviaturas y tres siglas. Lo importante no es su cobertura, sino el orden de las reglas: primero el dinero, porque “3.84 USD” contiene un decimal que otra regla leería como “tres punto ochenta y cuatro”; después los decimales; luego abreviaturas y siglas; y al final los números sueltos que hayan quedado:
# Normalizador de texto mínimo para TTS en Python:
UNIDADES = ['cero', 'uno', 'dos', 'tres', 'cuatro', 'cinco', 'seis', 'siete', 'ocho', 'nueve',
            'diez', 'once', 'doce', 'trece', 'catorce', 'quince', 'dieciséis', 'diecisiete',
            'dieciocho', 'diecinueve', 'veinte', 'veintiuno', 'veintidós', 'veintitrés',
            'veinticuatro', 'veinticinco', 'veintiséis', 'veintisiete', 'veintiocho', 'veintinueve']
DECENAS = {3: 'treinta', 4: 'cuarenta', 5: 'cincuenta', 6: 'sesenta',
           7: 'setenta', 8: 'ochenta', 9: 'noventa'}
ABREVIATURAS = {'Dr.': 'doctor', 'Dra.': 'doctora', 'pág.': 'página', 'núm.': 'número'}
SIGLAS = {'IA': 'inteligencia artificial', 'CSV': 'ce ese uve', 'TTS': 'te te ese'}

def numero_a_letras(n):
    # Diccionario de 0 a 99; fuera de ese rango se lee cifra por cifra:
    if n < 30:
        return UNIDADES[n]
    if n < 100:
        decena, unidad = divmod(n, 10)
        return DECENAS[decena] + ('' if unidad == 0 else ' y ' + UNIDADES[unidad])
    return ' '.join(UNIDADES[int(c)] for c in str(n))

def apocopar(palabras):
    # "uno" se acorta delante de un sustantivo masculino: un dólar, veintiún centavos:
    return re.sub(r'(veinti)?uno$', lambda m: 'veintiún' if m.group(1) else 'un', palabras)

def dinero(m):
    # "3.84 USD" se lee como dólares con centavos:
    enteros, centavos = int(m.group(1)), int(m.group(2) or 0)
    texto = apocopar(numero_a_letras(enteros)) + (' dólar' if enteros == 1 else ' dólares')
    if centavos:
        texto += ' con ' + apocopar(numero_a_letras(centavos)) + (' centavo' if centavos == 1 else ' centavos')
    return texto

def normalizar(texto):
    # Orden de las reglas: dinero, decimales, abreviaturas, siglas y números sueltos:
    texto = re.sub(r'(\d+)(?:\.(\d{2}))?\s*USD', dinero, texto)
    texto = re.sub(r'(\d+)\.(\d+)', lambda m: f'{m.group(1)} punto {m.group(2)}', texto)
    for abreviatura, completa in ABREVIATURAS.items():
        texto = texto.replace(abreviatura, completa)
    for sigla, lectura in SIGLAS.items():
        texto = re.sub(rf'\b{sigla}\b', lectura, texto)
    return re.sub(r'\d+', lambda m: numero_a_letras(int(m.group())), texto)

frases = ['El Dr. Ruiz revisó la pág. 12 del cuaderno de Sofía.',
          'Con Sonnet 5.5, las 600 consultas del mes cuestan 3.84 USD.',
          'Pandas lee un CSV de 45 filas y la IA resume 12 notas.']
for frase in frases:
    print(frase, '\n  ->', normalizar(frase))
El Dr. Ruiz revisó la pág. 12 del cuaderno de Sofía.
  -> El doctor Ruiz revisó la página doce del cuaderno de Sofía.
Con Sonnet 5.5, las 600 consultas del mes cuestan 3.84 USD.
  -> Con Sonnet cinco punto cinco, las seis cero cero consultas del mes cuestan tres dólares con ochenta y cuatro centavos.
Pandas lee un CSV de 45 filas y la IA resume 12 notas.
  -> Pandas lee un ce ese uve de cuarenta y cinco filas y la inteligencia artificial resume doce notas.
Las tres frases muestran tres resultados distintos, y conviene mirarlos uno por uno:
- La primera sale perfecta. “Dr.” pasa a “doctor”, “pág.” a “página” y $12$ a “doce”. Es el tipo de frase para la que se diseñó el diccionario.
- La segunda tiene un acierto y un error. “3.84 USD” se lee “tres dólares con ochenta y cuatro centavos”, justo lo que preguntaba Diego, y “5.5” se lee “cinco punto cinco”. Pero “600” queda como “seis cero cero”: el diccionario termina en $99$ y, fuera de ese rango, la función lee cifra por cifra. Un oyente entendería “seis, cero, cero consultas” y se quedaría con una sensación de máquina.
- La tercera muestra las siglas. “CSV” se deletrea (“ce ese uve”) y “IA” se expande (“inteligencia artificial”). Las dos decisiones son correctas, pero son decisiones: un hablante de México diría “ce ese ve”, y en un texto técnico quizá se prefiera “i a”. No hay una lectura universal de las siglas; hay una lectura que usted elige y documenta.
El error de “600” es instructivo: la mayor parte de los fallos que un oyente atribuye a “la IA” son fallos de normalización. Un normalizador de producción usa gramáticas completas para números cardinales, ordinales, fechas y monedas (bibliotecas como num2words o las gramáticas de normalización de NVIDIA NeMo), y aun así se revisa con listas de casos difíciles. Para el Cuaderno Vivo hay una solución más barata, que se verá más abajo: pedirle a Claude que escriba el resumen ya normalizado, con los números en letra, y dejar este normalizador como red de seguridad.
De letras a fonemas
La segunda etapa convierte palabras en fonemas, las unidades de sonido que distinguen significados. El español es una lengua generosa para esto: su ortografía es casi fonológica, y unas veinte reglas bastan para transcribir la mayoría de las palabras. Las lenguas como el inglés, en cambio, necesitan un diccionario de pronunciaciones con cientos de miles de entradas y un modelo para las palabras que no estén en él.
El bloque siguiente aplica reglas de grafema a fonema del español de México, con seseo (“ce” y “zeta” suenan como /s/), escritas en el alfabeto fonético internacional (AFI) simplificado. La función recorre cada palabra y aplica siempre la regla más larga que coincide, de modo que “ch” gane a “c” y “que” gane a “qu”. Después dibuja la cadena completa del TTS como en la Tabla 1:
# De letras a fonemas y diagrama del pipeline TTS en Python:
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

# Reglas de grafema a fonema del español de México (con seseo), en AFI simplificado:
REGLAS = {'ch': 'tʃ', 'll': 'ʝ', 'rr': 'r', 'que': 'ke', 'qui': 'ki', 'gue': 'ge', 'gui': 'gi',
          'ce': 'se', 'ci': 'si', 'ge': 'xe', 'gi': 'xi', 'c': 'k', 'z': 's', 'j': 'x',
          'ñ': 'ɲ', 'v': 'b', 'h': '', 'y': 'ʝ', 'x': 'ks', 'r': 'ɾ'}
ORDEN = sorted(REGLAS, key = len, reverse = True)
SIN_TILDES = str.maketrans('áéíóúü', 'aeiouu')

def a_fonemas(palabra):
    # Recorre la palabra y aplica siempre la regla más larga que coincide:
    p = palabra.lower().translate(SIN_TILDES)
    if p == 'y':
        return 'i'
    salida, i = [], 0
    while i < len(p):
        if i == 0 and p[0] == 'r':
            salida.append('r'); i += 1; continue
        if p[i] == 'y' and i == len(p) - 1:
            salida.append('i'); i += 1; continue
        regla = next((g for g in ORDEN if p.startswith(g, i)), None)
        if regla:
            salida.append(REGLAS[regla]); i += len(regla)
        else:
            salida.append(p[i]); i += 1
    return ''.join(salida)

texto = 'Sofía gastó 3.84 USD en 30 días.'
normalizado = normalizar(texto)
palabras = re.findall(r'\w+', normalizado)
fonemas = ' '.join(a_fonemas(p) for p in palabras)
print('Texto:      ', texto)
print('Normalizado:', normalizado)
print('Fonemas:    ', fonemas)
print('Palabras:', len(palabras), '| símbolos fonéticos:', len(fonemas.replace(' ', '').replace('ʃ', '')))

# Las siete cajas del pipeline con su ejemplo debajo:
etapas = [('Texto', '"3.84 USD"'), ('Normalización', '"tres dólares con\nochenta y cuatro..."'),
          ('Fonemas', 'tɾes dolaɾes kon\notʃenta i kuatɾo...'), ('Modelo acústico', 'Tacotron 2, VITS\n(red neuronal)'),
          ('Espectrograma\nde mel', '80 bandas ×\n1 marco cada 11.6 ms'), ('Vocoder', 'WaveNet, HiFi-GAN\n(red neuronal)'),
          ('Onda', '22 050 muestras\npor segundo')]
colores = ['#f0efec', '#cde2fb', '#cde2fb', '#fde0d3', '#fde0d3', '#d4f0e4', '#f0efec']
fig, eje = plt.subplots(figsize = (13, 3.6))
for k, ((titulo, ejemplo), color) in enumerate(zip(etapas, colores)):
    x = k * 1.85
    eje.add_patch(FancyBboxPatch((x, 1.1), 1.45, 0.9, boxstyle = 'round,pad=0.04', fc = color, ec = '#52514e'))
    eje.text(x + 0.725, 1.55, titulo, ha = 'center', va = 'center', fontsize = 11, fontweight = 'bold', color = '#0b0b0b')
    eje.text(x + 0.725, 0.65, ejemplo, ha = 'center', va = 'center', fontsize = 9, color = '#52514e')
    if k < len(etapas) - 1:
        eje.add_patch(FancyArrowPatch((x + 1.5, 1.55), (x + 1.8, 1.55), arrowstyle = '-|>', mutation_scale = 14, color = '#52514e'))
eje.text(1.85 * 1.5 + 0.725, 2.3, 'Interfaz de texto (reglas y diccionarios)', ha = 'center', fontsize = 10, color = '#1c5cab')
eje.text(1.85 * 4.5 + 0.725, 2.3, 'Parte neuronal (aprendida de grabaciones)', ha = 'center', fontsize = 10, color = '#b8481f')
eje.set_xlim(-0.1, 12.6); eje.set_ylim(0.2, 2.6); eje.axis('off')
eje.set_title('Pipeline de un sistema de texto a voz (TTS)', fontsize = 16)
plt.tight_layout()
plt.show()
Texto:       Sofía gastó 3.84 USD en 30 días.
Normalizado: Sofía gastó tres dólares con ochenta y cuatro centavos en treinta días.
Fonemas:     sofia gasto tɾes dolaɾes kon otʃenta i kuatɾo sentabos en tɾeinta dias
Palabras: 12 | símbolos fonéticos: 58
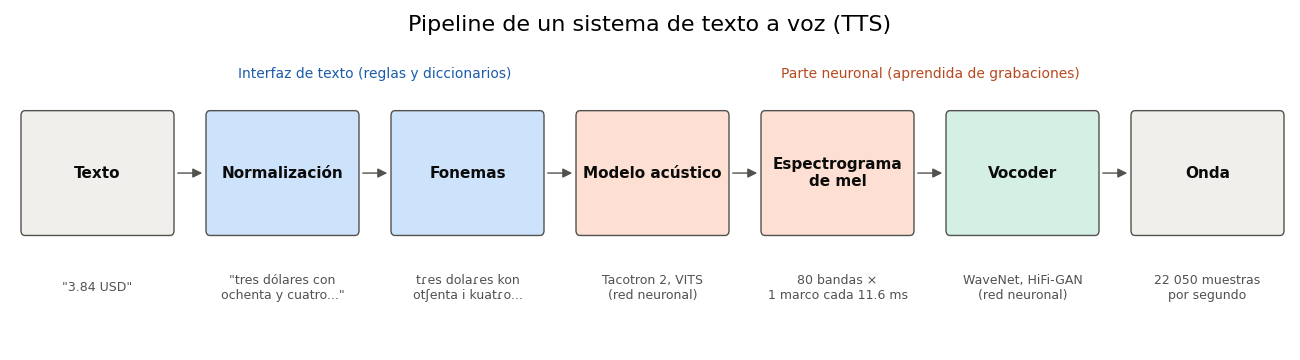
La frase de Sofía tiene $12$ palabras y $58$ símbolos fonéticos una vez normalizada. Fíjese en los cambios que hacen las reglas: “tres” pasa a “tɾes” porque la erre simple entre consonante y vocal es una vibrante simple (/ɾ/), “ochenta” pasa a “otʃenta” porque “ch” es un solo sonido, “centavos” pasa a “sentabos” porque en México no se distingue la “c” de la “s” ni la “v” de la “b”, y la conjunción “y” pasa a “i”. Para contar los símbolos, el código trata “tʃ” como uno solo, igual que el fonema que representa.
Las reglas tienen límites conocidos. No modelan los alófonos, las variantes de un fonema según su posición: la “d” de “dólares” es oclusiva [d], pero la de “todo” se suaviza en [ð], y un modelo acústico entrenado con voz real aprende esa diferencia por su cuenta. Tampoco resuelven las palabras extranjeras: con estas reglas, “Python” se convierte en “pʝton”, una secuencia que nadie pronuncia, y un sistema real necesita un diccionario de excepciones para esas palabras.
La figura del bloque resume la cadena. Las dos cajas azules son la interfaz de texto que acaba de escribir; las dos de color salmón son el modelo acústico y su salida, el espectrograma de mel que conoció ayer (80 bandas, un marco cada $256/22,050 \approx 11.6$ ms en muchos modelos de coqui-tts); la verde es el vocoder, que convierte ese espectrograma en una onda. El modelo fuente-filtro de la siguiente sección es la versión más antigua y transparente de esa última caja.
El modelo fuente-filtro
Antes de las redes neuronales, la síntesis de voz se apoyaba en una idea de la acústica de los años cincuenta, formulada con detalle por Gunnar Fant en 1960: la voz es una fuente filtrada. La fuente son las cuerdas vocales, que se abren y se cierran decenas o cientos de veces por segundo y producen un tren de pulsos de aire. El filtro es el tracto vocal (la garganta, la boca y los labios), cuya forma refuerza unas frecuencias y atenúa otras. Al cambiar la posición de la lengua y de los labios, el filtro cambia y el mismo zumbido de las cuerdas se convierte en /a/, /i/ o /u/.
En el dominio de la frecuencia, la idea cabe en una multiplicación:
$$ Y(f)=E(f)\cdot H(f) $$
La lógica de esta fórmula es la siguiente:
- $E(f)$ es el espectro de la fuente (la excitación). Un tren de pulsos que se repite cada $T_0$ segundos tiene energía solo en los múltiplos de su frecuencia fundamental $F_0 = 1/T_0$: los armónicos $F_0$, $2F_0$, $3F_0$ y así sucesivamente. La fuente decide la altura de la voz.
- $H(f)$ es la respuesta del filtro: una curva suave con picos llamados formantes ($F_1$, $F_2$, $F_3$…). El filtro decide qué vocal se oye.
- $Y(f)$, el espectro de la voz, es el producto de los dos: los armónicos de la fuente con la altura que les da la curva del filtro. Por eso una misma vocal se reconoce cantada en notas distintas (cambia $E$, se mantiene $H$) y dos vocales distintas se pueden decir en la misma nota (se mantiene $E$, cambia $H$).
La separación entre fuente y filtro es lo que hace manejable el problema. Un vocoder clásico transmite por separado la altura (un número por marco) y la forma del filtro (unos pocos coeficientes por marco); un vocoder neuronal como HiFi-GAN aprende a hacer lo mismo a partir del espectrograma de mel, que es, en el fondo, una foto borrosa de $|Y(f)|$ en cada instante.
Vocales sintéticas
Cada formante se puede imitar con un resonador de segundo orden, un filtro digital que tiene un pico en una frecuencia $F$ y un ancho de banda $B$. Es el bloque básico del sintetizador de formantes de Dennis Klatt (1980), con el que se construyeron voces sintéticas célebres de los años ochenta. Su ecuación en diferencias es:
$$ y[n]=A,x[n]+2r\cos\theta;y[n-1]-r^{2},y[n-2],\qquad r=e^{-\pi B/f_s},\quad \theta=\frac{2\pi F}{f_s} $$
La lógica detrás del resonador es múltiple:
- La salida depende de las dos salidas anteriores. Eso hace que el filtro “suene” por sí mismo, como una cuerda que vibra después de pulsarla; la frecuencia de esa vibración es $F$ y queda fijada por el ángulo $\theta$.
- El radio $r$ controla cuánto dura la vibración. Si $r$ está muy cerca de $1$, el filtro tarda en apagarse y el pico es estrecho; si $r$ es menor, se apaga rápido y el pico es ancho. La relación $r = e^{-\pi B/f_s}$ traduce el ancho de banda $B$, en hercios, a ese radio.
- La ganancia $A = 1 - 2r\cos\theta + r^2$ normaliza el filtro para que una señal constante (0 Hz) pase sin cambios. Sin ella, cada resonador multiplicaría la amplitud por un factor distinto y las vocales saldrían con volúmenes muy diferentes.
- En conclusión, dos números por formante, $F$ y $B$, bastan para describir la resonancia. Con dos formantes se distinguen las vocales del español; con cinco, la voz empieza a sonar a una persona concreta.
La Tabla 2 reúne los dos primeros formantes de las tres vocales que se sintetizarán. Son valores de referencia redondeados para una voz adulta; varían de una persona a otra, y las voces más agudas tienen formantes más altos.
Tabla 2. Formantes aproximados de tres vocales del español (valores de referencia redondeados).
| Vocal | Articulación | $F_1$ (Hz) | $F_2$ (Hz) | Qué refleja |
|---|---|---|---|---|
| /a/ | Abierta, central | 800 | 1200 | Boca abierta: $F_1$ alto |
| /i/ | Cerrada, anterior | 300 | 2300 | Lengua adelante: $F_2$ muy alto |
| /u/ | Cerrada, posterior, labios redondeados | 300 | 800 | Lengua atrás y labios en círculo: $F_2$ bajo |
Las dos columnas tienen una lectura articulatoria sencilla: $F_1$ sube cuanto más se abre la boca y $F_2$ sube cuanto más adelante está la lengua. Por eso /i/ y /u/ comparten $F_1$ (las dos son cerradas) y se separan por $F_2$.
El bloque siguiente construye la fuente como un tren de pulsos a $F_0 = 120$ Hz, una voz masculina grave, con una ligera inclinación espectral (los armónicos agudos pierden energía, como en la glotis real). Luego la pasa por los dos resonadores de cada vocal con scipy.signal.lfilter, guarda dia14_a.wav, dia14_i.wav y dia14_u.wav, y compara el espectro de cada vocal con la curva teórica del filtro:
# Modelo fuente-filtro: vocales /a/, /i/ y /u/ con dos formantes en Python:
from scipy.signal import lfilter, freqz, find_peaks
from scipy.fft import rfft, rfftfreq
from scipy.io import wavfile

F0 = 120
FORMANTES = {'a': (800, 1200), 'i': (300, 2300), 'u': (300, 800)}
ANCHOS = (80, 120)   # anchos de banda de F1 y F2, en Hz

def fuente(f0, n, fs = FS):
    # Tren de pulsos glotales: un impulso cada vez que la fase acumulada completa un ciclo:
    f0 = np.broadcast_to(np.asarray(f0, dtype = float), (n,))
    fase = np.cumsum(f0) / fs
    x = np.zeros(n)
    x[1:][np.diff(np.floor(fase)) > 0] = 1.0
    # Inclinación espectral de la glotis: los armónicos agudos pierden energía:
    return lfilter([1.0], [1.0, -0.9], x)

def resonador(f, ancho, fs = FS):
    # Resonador de segundo orden (un formante) con ganancia 1 en 0 Hz:
    r = np.exp(-np.pi * ancho / fs)
    theta = 2 * np.pi * f / fs
    a = [1.0, -2 * r * np.cos(theta), r ** 2]
    return [sum(a)], a

def filtrar(x, nombre, fs = FS):
    # Pasa la fuente por los dos formantes de la vocal, uno detrás del otro:
    for f, ancho in zip(FORMANTES[nombre], ANCHOS):
        b, a = resonador(f, ancho, fs)
        x = lfilter(b, a, x)
    return 0.9 * x / np.max(np.abs(x))

def guardar_wav(nombre, y, fs = FS):
    # WAV de 16 bits con una rampa de 10 ms en cada extremo:
    n = int(0.01 * fs)
    rampa = np.ones(len(y)); rampa[:n] = np.linspace(0, 1, n); rampa[-n:] = np.linspace(1, 0, n)
    ruta = audio / f'dia14_{nombre}.wav'
    wavfile.write(ruta, fs, (y * rampa * 32767).astype(np.int16))
    return ruta

n = int(0.8 * FS)
vocales = {v: filtrar(fuente(F0, n), v) for v in FORMANTES}
filas = []
fig, ejes = plt.subplots(1, 3, figsize = (13, 3.8), sharey = True)
for eje, (v, y) in zip(ejes, vocales.items()):
    guardar_wav(v, y)
    # Espectro de 0.5 s con ventana de Hann, en dB respecto al máximo:
    tramo = y[2000:10000] * np.hanning(8000)
    espectro = 20 * np.log10(np.abs(rfft(tramo)) + 1e-9)
    frecuencias = rfftfreq(len(tramo), 1 / FS)
    # Envolvente del filtro: producto de las respuestas de los dos resonadores:
    w, h = np.ones(1), np.ones(2048, dtype = complex)
    for f, ancho in zip(FORMANTES[v], ANCHOS):
        b, a = resonador(f, ancho)
        w, hk = freqz(b, a, worN = 2048, fs = FS)
        h = h * hk
    envolvente = 20 * np.log10(np.abs(h))
    picos, _ = find_peaks(envolvente)
    medidos = [round(float(w[p])) for p in picos[:2]]
    filas.append({'vocal': f'/{v}/', 'F1_tabla': FORMANTES[v][0], 'F2_tabla': FORMANTES[v][1],
                  'picos_envolvente': medidos, 'armonico_mas_fuerte': round(float(frecuencias[np.argmax(espectro)]))})
    visible = frecuencias <= 4000
    eje.plot(frecuencias[visible], espectro[visible] - espectro.max(), color = '#2a78d6', lw = 1, label = 'Espectro de la vocal')
    eje.plot(w[w <= 4000], envolvente[w <= 4000] - envolvente.max(), color = '#eb6834', lw = 2, label = 'Envolvente del filtro')
    for f, lado in zip(FORMANTES[v], ('right', 'left')):
        eje.axvline(f, color = '#52514e', ls = '--', lw = 1)
        eje.text(f - 40 if lado == 'right' else f + 40, 3, f'{f} Hz', ha = lado, fontsize = 9, color = '#52514e')
    eje.set_title(f'Vocal /{v}/ (F0 = {F0} Hz)', fontsize = 13)
    eje.set_xlabel('Frecuencia (Hz)')
    eje.set_ylim(-80, 10)
ejes[0].set_ylabel('Magnitud (dB respecto al máximo)')
ejes[0].legend(loc = 'lower left', fontsize = 9)
fig.suptitle('Modelo fuente-filtro: el mismo tren de pulsos con tres filtros distintos', fontsize = 16)
plt.tight_layout()
plt.show()
print(pd.DataFrame(filas).to_string(index = False))
print('Armónicos en 0.5 s de /a/ por debajo de 4 000 Hz:', int(4000 // F0))
vocal  F1_tabla  F2_tabla picos_envolvente  armonico_mas_fuerte
  /a/       800      1200      [801, 1188]                  840
  /i/       300      2300      [297, 2297]                  240
  /u/       300       800       [301, 785]                  240
Armónicos en 0.5 s de /a/ por debajo de 4 000 Hz: 33
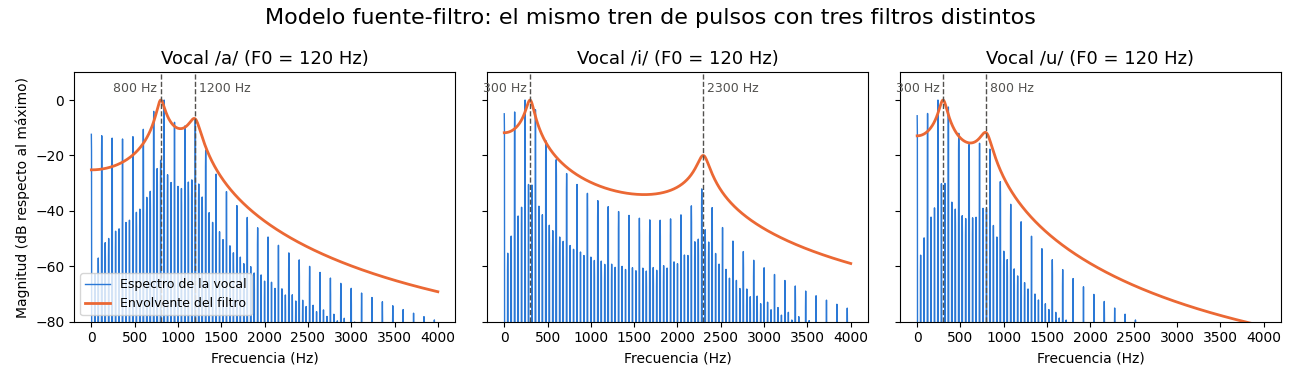
La figura muestra la idea del modelo con una claridad difícil de conseguir con voz real. En los tres paneles, las líneas azules están en los mismos sitios: son los armónicos de $120$ Hz, la misma fuente. Lo único que cambia es la curva naranja, y con ella la altura de cada armónico. En /a/ los armónicos más fuertes se agrupan entre $800$ y $1200$ Hz; en /i/ hay un grupo grave cerca de $300$ Hz y otro aislado cerca de $2300$ Hz; en /u/ todo queda por debajo de $1000$ Hz, lo que da a esa vocal su sonido oscuro.
La tabla de la salida confirma los números. Los picos de la envolvente aparecen en $801$ y $1188$ Hz para /a/, $297$ y $2297$ Hz para /i/ y $301$ y $785$ Hz para /u/: a pocos hercios de los valores de la Tabla 2. La pequeña desviación de $F_2$ en /a/ y /u/ se debe a que los dos resonadores están en cascada y la falda de uno inclina un poco el pico del otro, más cuanto más cerca están.
La última columna esconde una lección importante. El armónico más fuerte de /a/ está en $840$ Hz, no en $800$, y el de /i/ y /u/ está en $240$ Hz, no en $300$. La razón es que la fuente solo tiene energía en los múltiplos de $F_0$: $800$ no es múltiplo de $120$, así que el formante cae entre el sexto armónico ($720$ Hz) y el séptimo ($840$ Hz), y gana el más cercano a la cima. En /i/ y /u/, $300$ Hz queda justo entre el segundo armónico ($240$ Hz) y el tercero ($360$ Hz), y la inclinación de la fuente favorece al más grave. Con una voz aguda, de $F_0 = 300$ Hz, solo habría un armónico cada $300$ Hz y la curva del filtro quedaría muestreada en muy pocos puntos. Por eso es más difícil reconocer las vocales de una soprano en un agudo que las de un barítono, y por eso los modelos de voz trabajan peor con voces muy agudas.
Si escucha los tres archivos notará que se reconocen como vocales, pero suenan a zumbido electrónico. Faltan los formantes superiores, el ruido de la respiración, las pequeñas irregularidades de la altura (el jitter) y de la amplitud (el shimmer) y, sobre todo, la transición de un sonido al siguiente. Eso es lo que un modelo neuronal aprende de las grabaciones y que las reglas no consiguen describir.
Prosodia
Unas vocales bien formadas no bastan para que una frase suene natural. La misma secuencia de fonemas puede ser una afirmación, una pregunta, una orden o una ironía, y lo que las distingue es la prosodia: cómo cambia la altura de la voz (la frecuencia fundamental, $F_0$), cuánto dura cada sonido y con cuánta energía se dice. Cuando un oyente describe una voz sintética como “robótica”, casi siempre se refiere a una prosodia plana o mal colocada, no a los fonemas.
En español, la diferencia más clara está al final de la frase. Una afirmación neutra suele terminar con un descenso de $F_0$ (los fonetistas lo llaman declinación), mientras que una pregunta total, de las que se responden con sí o no, termina con un ascenso marcado. Sofía lo comprobó grabándose la misma frase dos veces: “El cuaderno ya habla.” y “¿El cuaderno ya habla?”.
Para medir la entonación hace falta estimar $F_0$ en cada instante, y uno de los métodos más usados es el algoritmo YIN de de Cheveigné y Kawahara (2002). Su punto de partida es la función de diferencia: si la señal se repite cada $\tau$ muestras, al restarle una copia desplazada $\tau$ muestras debería quedar casi cero. YIN normaliza esa diferencia con su media acumulada:
$$ d(\tau)=\sum_{j=1}^{W}\left(x_j-x_{j+\tau}\right)^{2},\qquad d’(\tau)=\frac{d(\tau)}{\frac{1}{\tau}\sum_{k=1}^{\tau}d(k)},\qquad F_0=\frac{f_s}{\tau^{*}} $$
La lógica del algoritmo es la siguiente:
- $d(\tau)$ mide cuánto se parece la ventana a sí misma desplazada. Si la voz tiene periodo $T_0$, $d$ cae casi a cero en $\tau = T_0 f_s$ y en sus múltiplos.
- La normalización $d’(\tau)$ evita el error más común, que es elegir $\tau = 0$ (donde $d$ siempre vale cero) o un múltiplo del periodo verdadero. Al dividir entre la media de los valores anteriores, $d’$ empieza en $1$ y solo baja de forma clara en el periodo real.
- $\tau^{*}$ es el primer mínimo de $d’$ que baja de un umbral (aquí, $0.1$), afinado con una interpolación parabólica para no quedar limitado a números enteros de muestras. Si ningún valor baja del umbral, el marco se declara sordo (sin altura definida), como un silencio o una consonante como la /s/.
La versión probabilística, pYIN (Mauch y Dixon, 2014), es la que ofrece librosa.pyin(y, fmin = 80, fmax = 400, sr = 16000); en lugar de un solo umbral prueba muchos y elige el contorno más coherente con un modelo oculto de Markov. Aquí se escribe YIN a mano, con la búsqueda limitada a $80$ a $400$ Hz como en esa llamada, para ver exactamente qué calcula.
El bloque siguiente sintetiza dos “frases” de vocal /a/ de $1.2$ s, rodeadas de $0.15$ s de silencio: una afirmación cuya $F_0$ baja de $170$ a $120$ Hz y una pregunta que se mantiene cerca de $150$ Hz y sube hasta $260$ Hz en los últimos $0.35$ s. Después estima $F_0$ con YIN y la compara con el contorno con el que se sintetizó:
# Prosodia: contornos de F0 de una afirmación y de una pregunta, y estimación con YIN en Python:
def contorno(puntos, duracion, fs = FS):
    # Interpola linealmente una lista de (tiempo, F0) a una F0 por muestra:
    t = np.arange(int(duracion * fs)) / fs
    tiempos, valores = zip(*puntos)
    return np.interp(t, tiempos, valores)

def frase(puntos, duracion = 1.2, silencio = 0.15, fs = FS):
    # Vocal /a/ con F0 variable, rodeada de silencio:
    f0 = contorno(puntos, duracion, fs)
    voz = filtrar(fuente(f0, len(f0), fs), 'a')
    pausa = np.zeros(int(silencio * fs))
    return np.concatenate([pausa, voz, pausa]), np.concatenate([np.full(len(pausa), np.nan), f0, np.full(len(pausa), np.nan)])

def yin(y, fs = FS, fmin = 80, fmax = 400, ventana = 400, salto = 160, umbral = 0.1):
    # Estimador de F0 de de Cheveigné y Kawahara (2002), sin la parte probabilística de pYIN:
    tau_min, tau_max = int(fs / fmax), int(fs / fmin)
    tiempos, f0s, energias = [], [], []
    for inicio in range(0, len(y) - ventana - tau_max, salto):
        marco = y[inicio: inicio + ventana + tau_max]
        x0 = marco[:ventana]
        d = np.array([np.sum((x0 - marco[tau: tau + ventana]) ** 2) for tau in range(tau_max + 1)])
        # Diferencia normalizada por su media acumulada:
        dn = np.ones_like(d)
        dn[1:] = d[1:] * np.arange(1, tau_max + 1) / np.maximum(np.cumsum(d[1:]), 1e-12)
        rms = np.sqrt(np.mean(x0 ** 2))
        candidatos = np.where(dn[tau_min:] < umbral)[0]
        f0 = np.nan
        if len(candidatos) and rms > 0.01:
            tau = tau_min + candidatos[0]
            while tau < tau_max and dn[tau + 1] < dn[tau]:
                tau += 1
            # Interpolación parabólica alrededor del mínimo:
            a, b, c = dn[tau - 1], dn[tau], dn[min(tau + 1, tau_max)]
            ajuste = 0.5 * (a - c) / (a - 2 * b + c) if (a - 2 * b + c) != 0 else 0.0
            f0 = fs / (tau + ajuste)
        tiempos.append((inicio + ventana / 2) / fs)
        f0s.append(f0)
        energias.append(20 * np.log10(rms + 1e-9))
    return np.array(tiempos), np.array(f0s), np.array(energias)

frases_prosodia = {'afirmacion': [(0, 170), (1.2, 120)],
                   'pregunta': [(0, 150), (0.85, 140), (1.2, 260)]}
resumen, fig = [], plt.figure(figsize = (12, 4))
for k, (nombre, puntos) in enumerate(frases_prosodia.items()):
    y, f0_real = frase(puntos)
    guardar_wav(nombre, y)
    t, f0_est, energia = yin(y)
    real_en_marcos = f0_real[(t * FS).astype(int)]
    sonoros = ~np.isnan(f0_est)
    error = np.nanmean(np.abs(f0_est - real_en_marcos))
    utiles = f0_est[sonoros]
    resumen.append({'frase': nombre, 'duracion_s': round(len(y) / FS, 2), 'marcos_sonoros': f'{sonoros.sum()} de {len(t)}',
                    'F0_inicio': round(utiles[0], 1), 'F0_final': round(utiles[-1], 1),
                    'error_medio_Hz': round(error, 2), 'energia_media_dB': round(energia[sonoros].mean(), 1)})
    eje = fig.add_subplot(1, 2, k + 1)
    eje.plot(np.arange(len(y)) / FS, f0_real, color = '#52514e', lw = 2, label = 'F0 con la que se sintetizó')
    eje.plot(t, f0_est, 'o', ms = 4, color = '#2a78d6' if k == 0 else '#eb6834', label = 'F0 estimada con YIN')
    eje.set_title('Afirmación: F0 descendente' if k == 0 else 'Pregunta: F0 ascendente al final', fontsize = 13)
    eje.set_xlabel('Tiempo (s)'); eje.set_ylabel('F0 (Hz)'); eje.set_ylim(80, 300)
    eje.legend(loc = 'upper left' if k == 1 else 'upper right', fontsize = 9)
fig.suptitle('Entonación sintetizada y recuperada', fontsize = 16)
plt.tight_layout()
plt.show()
print(pd.DataFrame(resumen).to_string(index = False))
     frase  duracion_s marcos_sonoros  F0_inicio  F0_final  error_medio_Hz  energia_media_dB
afirmacion         1.5     116 de 147      168.9     121.0            0.12             -11.1
  pregunta         1.5     105 de 147      149.5     254.2            0.19             -12.3
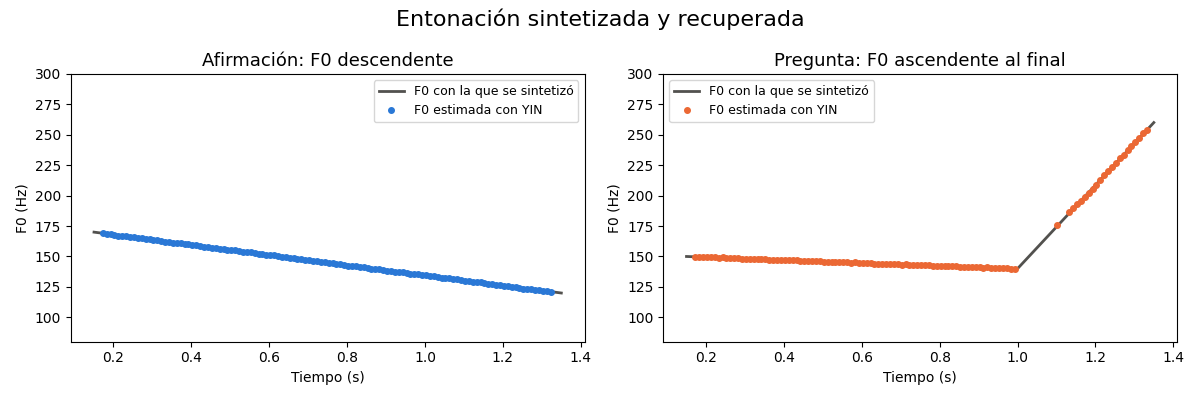
La figura muestra que YIN recupera los dos contornos casi sobre la línea gris. La tabla lo cuantifica: el error medio es de $0.12$ Hz en la afirmación y de $0.19$ Hz en la pregunta, menos de un $0.2%$ de la $F_0$. La afirmación baja de $168.9$ a $121.0$ Hz y la pregunta sube de $149.5$ a $254.2$ Hz, los dos patrones que distinguen una frase de la otra.
Los marcos sordos merecen una segunda mirada. Cada frase dura $1.5$ s y produce $147$ marcos de análisis (uno cada $10$ ms). En la afirmación, $116$ marcos son sonoros; los $31$ restantes coinciden con los dos silencios de $0.15$ s, como debe ser. En la pregunta, solo $105$ son sonoros: además de los silencios, YIN pierde unos $11$ marcos al comienzo del ascenso, el hueco que se ve en la gráfica entre $1.0$ y $1.1$ s. Allí $F_0$ sube unos $340$ Hz por segundo y, dentro de una ventana de $25$ ms, la señal ya no se repite igual de un periodo al siguiente, así que $d’$ no baja del umbral. YIN supone que la altura es estable dentro de la ventana; cuando cambia rápido, el estimador prefiere no responder antes que dar un valor equivocado. pYIN reduce esos huecos porque elige el contorno global más probable en lugar de decidir marco a marco.
La energía media de los marcos sonoros, de $-11.1$ dB en la afirmación y $-12.3$ dB en la pregunta (respecto al máximo digital), es la tercera dimensión de la prosodia. En estas frases sintéticas apenas cambia, porque la amplitud de los pulsos es constante; en la voz real, la sílaba acentuada suele tener más energía y más duración que las demás, y un modelo de TTS tiene que predecir las tres cosas a la vez. Por eso VITS incluye un predictor de duraciones que decide cuántos marcos dura cada fonema, y los modelos más recientes predicen además la altura y la energía de forma explícita.
Envolvente de energía
La energía también cambia dentro de cada sonido. Ninguna voz ni ningún instrumento pasa del silencio al volumen máximo en una sola muestra: hay un momento en el que el sonido crece, otro en el que se asienta y otro en el que se apaga. Los sintetizadores de música describen esa forma con cuatro parámetros, la envolvente ADSR: ataque (attack), decaimiento (decay), sostenido (sustain) y relajación (release).
$$ e(t)=\begin{cases}t/t_A & 0\le t<t_A\ 1-(1-S),\dfrac{t-t_A}{t_D} & t_A\le t<t_A+t_D\ S & t_A+t_D\le t<T-t_R\ S,\dfrac{T-t}{t_R} & T-t_R\le t\le T\end{cases} $$
La lógica de cada tramo es la siguiente:
- Ataque ($t_A$): la amplitud sube linealmente de $0$ a $1$. Un ataque corto da un sonido percusivo, como una consonante oclusiva o una cuerda pulsada; uno largo, un sonido que “entra” suave, como una vocal susurrada.
- Decaimiento ($t_D$): baja del pico al nivel de sostenido. Imita el golpe inicial que se relaja.
- Sostenido ($S$): es un nivel, no una duración. Se mantiene mientras dura la nota o la vocal.
- Relajación ($t_R$): la amplitud cae a cero. Es la parte que evita el chasquido final, porque la onda llega a cero en lugar de cortarse a mitad de un ciclo.
El bloque siguiente aplica una envolvente de $50$ ms de ataque, $100$ ms de decaimiento, sostenido de $0.6$ y $200$ ms de relajación a un tono de $220$ Hz y a la vocal /a/ del bloque 4, y compara cómo termina la vocal con y sin envolvente:
# Envolvente ADSR aplicada a un tono y a la vocal /a/ en Python:
def adsr(n, fs = FS, ataque = 0.05, decaimiento = 0.10, sostenido = 0.6, relajacion = 0.20):
    # Cuatro tramos lineales: subir, bajar al nivel de sostenido, mantener y apagar:
    na, nd, nr = int(ataque * fs), int(decaimiento * fs), int(relajacion * fs)
    ns = n - na - nd - nr
    return np.concatenate([np.linspace(0, 1, na, endpoint = False),
                           np.linspace(1, sostenido, nd, endpoint = False),
                           np.full(ns, sostenido),
                           np.linspace(sostenido, 0, nr)])

t = np.arange(FS) / FS
envolvente = adsr(len(t))
tono = np.sin(2 * np.pi * 220 * t)
tono_adsr = tono * envolvente
vocal_a = vocales['a']
vocal_adsr = vocal_a * adsr(len(vocal_a))
guardar_wav('tono_adsr', 0.9 * tono_adsr)
guardar_wav('a_adsr', vocal_adsr)
print('Muestras por tramo (A, D, S, R):', int(0.05 * FS), int(0.10 * FS), len(t) - int(0.35 * FS), int(0.20 * FS))
print(f'/a/ sin envolvente: primera muestra {vocal_a[0]:+.3f}, última {vocal_a[-1]:+.3f}, '
      f'salto final máximo {np.max(np.abs(np.diff(vocal_a[-50:]))):.3f}')
print(f'/a/ con ADSR:       primera muestra {vocal_adsr[0]:+.3f}, última {vocal_adsr[-1]:+.3f}, '
      f'salto final máximo {np.max(np.abs(np.diff(vocal_adsr[-50:]))):.3f}')
print(f'Energía conservada por la envolvente: {np.sum(tono_adsr ** 2) / np.sum(tono ** 2):.3f}')

# Envolvente sola y tono modulado por ella:
fig, ejes = plt.subplots(2, 1, figsize = (10, 5.2), sharex = True)
ejes[0].plot(t, envolvente, color = '#eb6834', lw = 2)
for inicio, fin, etiqueta in [(0, 0.05, 'A'), (0.05, 0.15, 'D'), (0.15, 0.8, 'S'), (0.8, 1.0, 'R')]:
    ejes[0].axvspan(inicio, fin, color = '#f0efec' if etiqueta in 'AS' else '#ffffff', zorder = 0)
    ejes[0].text((inicio + fin) / 2, 1.05, etiqueta, ha = 'center', fontsize = 12, fontweight = 'bold', color = '#0b0b0b')
ejes[0].set_ylim(0, 1.2); ejes[0].set_ylabel('Amplitud')
ejes[0].set_title('Envolvente ADSR: ataque 50 ms, decaimiento 100 ms, sostenido 0.6, relajación 200 ms', fontsize = 13)
ejes[1].plot(t, tono_adsr, color = '#2a78d6', lw = 0.4)
ejes[1].plot(t, envolvente, color = '#eb6834', lw = 1.5, ls = '--')
ejes[1].plot(t, -envolvente, color = '#eb6834', lw = 1.5, ls = '--')
ejes[1].set_xlabel('Tiempo (s)'); ejes[1].set_ylabel('Amplitud')
ejes[1].set_title('Tono de 220 Hz multiplicado por la envolvente', fontsize = 13)
plt.tight_layout()
plt.show()
Muestras por tramo (A, D, S, R): 800 1600 10400 3200
/a/ sin envolvente: primera muestra +0.000, última -0.010, salto final máximo 0.069
/a/ con ADSR:       primera muestra +0.000, última -0.000, salto final máximo 0.001
Energía conservada por la envolvente: 0.340
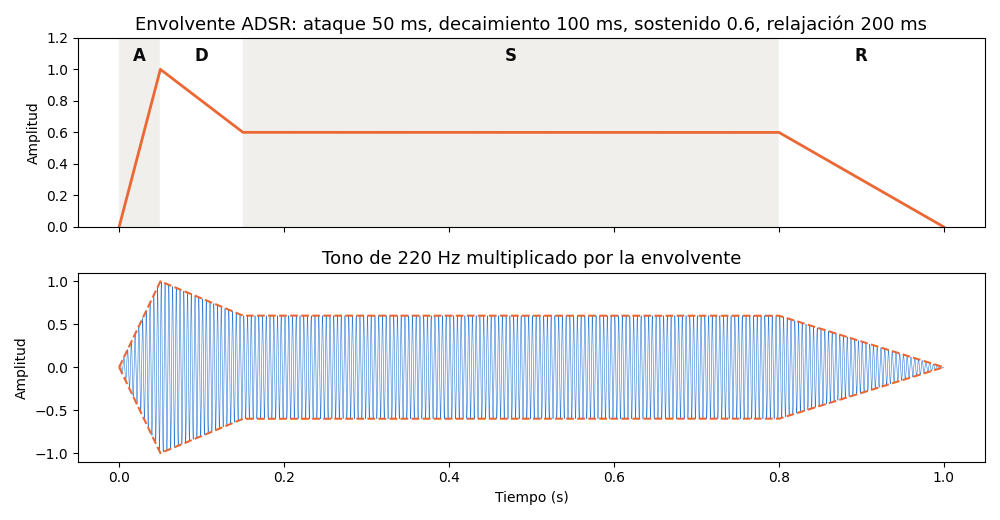
En un segundo de audio, la envolvente reparte $800$ muestras al ataque, $1600$ al decaimiento, $10,400$ al sostenido y $3200$ a la relajación. La salida muestra por qué importa: sin envolvente, la vocal /a/ termina en una muestra de $-0.010$ y sus últimas muestras saltan hasta $0.069$ de una a la siguiente; con la envolvente, la última muestra vale $0.000$ y el salto máximo baja a $0.001$. Un corte brusco equivale a multiplicar la señal por un escalón, y un escalón tiene energía en todas las frecuencias: el oído lo percibe como un “clic”. Por eso la función guardar_wav del bloque 4 ya aplicaba una rampa de $10$ ms en cada extremo.
La envolvente también tiene un coste: conserva solo $0.340$ de la energía del tono original, porque la mayor parte del tiempo la amplitud está en $0.6$ y la energía depende del cuadrado de la amplitud ($0.6^2 = 0.36$). Si dos sonidos deben oírse igual de fuertes, hay que normalizarlos después de aplicar la envolvente, no antes.
En un TTS neuronal nadie escribe una envolvente ADSR: la red aprende la forma de cada sonido de las grabaciones. Pero la envolvente sigue siendo útil en el Cuaderno Vivo para dos tareas del Día 16: unir fragmentos de voz sin chasquidos y hacer que la música de fondo entre y salga con suavidad.
De Tacotron a XTTS
Las piezas de las secciones anteriores (normalizar, convertir a fonemas, controlar la altura, la duración y la energía y producir una onda) han existido siempre. Lo que ha cambiado en cuarenta años es quién decide cada una: primero reglas escritas a mano, después estadística sobre grabaciones y, desde 2016, redes neuronales que aprenden casi toda la cadena. La Tabla 3 resume las generaciones.
Tabla 3. Generaciones de sistemas de texto a voz, con un ejemplo representativo y su año.
| Generación | Idea central | Ejemplo | Año | Fortaleza | Debilidad |
|---|---|---|---|---|---|
| Formantes por reglas | Fuente-filtro con parámetros escritos a mano | Sintetizador de Klatt | 1980 | Inteligible, ligero, controlable | Suena claramente artificial |
| Concatenativa | Pegar trozos de grabaciones reales | Selección de unidades (Hunt y Black) | 1996 | Muy natural dentro del dominio grabado | Saltos audibles; horas de grabación por voz |
| Paramétrica estadística | Modelos ocultos de Markov que predicen parámetros del vocoder | HTS | 2009 | Flexible, poca memoria | Voz “amortiguada” |
| Neuronal autorregresiva | Una red predice el espectrograma de mel y otra genera la onda | Tacotron 2 con WaveNet | 2018 | Naturalidad cercana a la humana | Lenta; a veces repite o salta palabras |
| Extremo a extremo | Una sola red del texto a la onda, con predictor de duraciones | VITS | 2021 | Rápida y natural | Un modelo por hablante o lista cerrada de hablantes |
| Multilingüe sin entrenamiento previo del hablante | Condicionar con unos segundos de una voz de referencia | XTTS (Coqui) | 2024 | Clona voces en muchos idiomas | Riesgo de suplantación; licencia restrictiva |
Tres hitos explican la tabla. WaveNet (van den Oord y colaboradores, 2016) demostró que una red podía generar audio muestra a muestra con una calidad nunca vista, aunque a costa de una lentitud enorme. Tacotron 2 (Shen y colaboradores, 2018) separó el problema en dos redes, una que predice el espectrograma de mel y un vocoder WaveNet que lo convierte en onda, y obtuvo un MOS de $4.53$ frente a $4.58$ de las grabaciones humanas en su evaluación. VITS (Kim, Kong y Son, 2021) unió las dos redes en un solo modelo entrenado de extremo a extremo con un autocodificador variacional y entrenamiento adversario, y añadió un predictor estocástico de duraciones para que la misma frase no suene siempre idéntica.
La última fila es la que da sentido a este módulo. Los modelos de clonación sin entrenamiento previo del hablante (en inglés, zero-shot), como XTTS, reciben un fragmento corto de una voz de referencia, extraen de él un vector que resume el timbre (un embedding de hablante, como los embeddings de texto del Día 2) y hablan con esa voz en cualquiera de sus idiomas. Es la tecnología con la que Sofía narrará con su propia voz, y también la que permite suplantar a otra persona con unos segundos de audio. Mañana se trabajará con ella, con sus reglas.
Los servicios comerciales, como ElevenLabs, ofrecen esta misma capacidad en la nube, con mejor calidad en muchos idiomas pero con un modelo cerrado y las grabaciones fuera de su equipo. Para hoy basta con un modelo abierto, local y con una sola voz genérica.
TTS abierto en español con coqui-tts
Coqui fue la empresa que mantuvo durante años la biblioteca de TTS abierta más usada en Python. Cerró sus servicios a finales de 2023 y su repositorio original quedó sin mantenimiento; desde entonces, el Instituto de Investigación Idiap de Suiza mantiene una bifurcación compatible que se instala con pip install coqui-tts y se importa exactamente igual que la original, con from TTS.api import TTS.
Revisado en octubre de 2026: la última versión publicada de coqui-tts en PyPI es la 0.27.5 (26 de enero de 2026), para Python 3.10 a 3.14 y con licencia MPL-2.0 para el código de la biblioteca. Cada modelo preentrenado tiene su propia licencia, que puede ser más restrictiva que la del código.
La Tabla 4 recoge los modelos del catálogo de coqui-tts que hablan español, con la licencia que declara el propio catálogo (.models.json del repositorio de Idiap).
Tabla 4. Modelos con español en el catálogo de coqui-tts (revisado en octubre de 2026).
| Identificador | Arquitectura | Datos | Licencia declarada | Uso en la serie |
|---|---|---|---|---|
tts_models/es/mai/tacotron2-DDC | Tacotron 2 con vocoder aparte | M-AILABS en español | MPL | Alternativa más lenta |
tts_models/es/css10/vits | VITS | CSS10 en español (audiolibros) | BSD-3-Clause | Voz genérica de hoy |
tts_models/multilingual/multi-dataset/xtts_v2 | XTTS-v2 | Multilingüe (17 idiomas) | Coqui Public Model License (no comercial) | Clonación de la voz propia, mañana |
El bloque siguiente necesita torch y coqui-tts, que no forman parte del entorno ligero de la serie; además, descarga el modelo la primera vez (unos cientos de megabytes). Funciona en CPU, solo que más despacio, y con una GPU la síntesis de una frase tarda una fracción de segundo. Por eso se muestra con una salida de ejemplo en lugar de ejecutarse:
# TTS abierto en español con coqui-tts, la bifurcación mantenida por Idiap, en Python:
# pip install coqui-tts   (versión 0.27.5; revisado en octubre de 2026)
import torch
from TTS.api import TTS

# Modelos del catálogo que hablan español:
modelos_es = [m for m in TTS().list_models() if '/es/' in m]
print(modelos_es)

# VITS entrenado con CSS10 en español; en CPU funciona, pero más despacio:
dispositivo = 'cuda' if torch.cuda.is_available() else 'cpu'
tts = TTS('tts_models/es/css10/vits').to(dispositivo)
frase_prueba = normalizar('Con Sonnet 5.5, el Cuaderno Vivo cuesta 3.84 USD al mes.')
tts.tts_to_file(text = frase_prueba, file_path = 'cuaderno_vivo/audio/dia14_vits_prueba.wav')
print('Texto enviado:', frase_prueba)
print('Frecuencia de muestreo del modelo:', tts.synthesizer.output_sample_rate, 'Hz')

# Salida de ejemplo (puede variar):
# ['tts_models/es/mai/tacotron2-DDC', 'tts_models/es/css10/vits']
# Texto enviado: Con Sonnet cinco punto cinco, el Cuaderno Vivo cuesta tres dólares con ochenta y cuatro
#                centavos al mes.
# Frecuencia de muestreo del modelo: 22050 Hz
Observe tres detalles. El primero es que el texto pasa por normalizar antes de llegar al modelo: VITS se entrenó con audiolibros, donde los números ya están escritos con letra, y no sabe qué hacer con “3.84”. El segundo es que el modelo trabaja a $22,050$ Hz, no a los $16,000$ Hz del módulo; si quiere mezclar su salida con las señales de hoy, tendrá que remuestrear con scipy.signal.resample_poly(y, 320, 441), que convierte exactamente de $22,050$ a $16,000$ Hz. El tercero es que TTS().list_models() consulta el catálogo de la versión instalada: antes de copiar un identificador de una entrada de blog, incluida esta, compruebe que sigue existiendo en su versión.
XTTS-v2 merece una advertencia aparte. Su licencia, la Coqui Public Model License, solo permite el uso no comercial, y la biblioteca pide aceptarla la primera vez que descarga el modelo (en un programa no interactivo, con la variable de entorno COQUI_TOS_AGREED=1). Para un cuaderno personal es suficiente; para un producto que se venda, no.
Narrar un resumen del Cuaderno Vivo
El normalizador del bloque 2 falla con “600” y fallaría con cualquier fecha, hora o porcentaje. Ampliarlo es posible, pero hay un camino más corto: escribir el resumen pensando en el oído desde el principio. Un texto para escuchar tiene reglas distintas de uno para leer. Las frases deben ser cortas, porque el oyente no puede volver atrás; no debe haber paréntesis, listas ni siglas, porque en voz alta no tienen forma; y los números deben ir en letra, para que la voz no tenga que adivinar.
El bloque siguiente le pide a Claude Haiku 5.5 un resumen de unas $60$ palabras de las cuatro notas de la semana, una por tema, tomadas de las 12 notas de Sofía de la Tabla 1 del Día 1. Haiku es el modelo adecuado: la tarea es corta y sencilla, y su precio es de $0.10$ USD por millón de tokens de entrada y $0.50$ por millón de salida. Como en el resto de la serie, no se envía temperature (los modelos actuales no aceptan valores distintos del predeterminado) y el gasto se controla con output_config = {'effort': 'low'}:
# Resumen pensado para el oído con Haiku 5.5 y narración con VITS en Python:
import anthropic

INSTRUCCIONES_ORALES = (
    'Usted escribe resúmenes que se van a escuchar, no a leer. '
    'Escriba unas 60 palabras en español, en frases de menos de 15 palabras. '
    'No use siglas, símbolos, listas ni paréntesis, y escriba los números con letra. '
    'Termine con una pregunta que invite a repasar.')
notas_semana = '\n'.join([
    'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.',
    'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.',
    'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.',
    'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'])

cliente = anthropic.Anthropic()   # lee ANTHROPIC_API_KEY del entorno
respuesta = cliente.messages.create(
    model = 'claude-haiku-5-5',
    max_tokens = 1024,
    system = INSTRUCCIONES_ORALES,
    output_config = {'effort': 'low'},
    messages = [{'role': 'user', 'content': f'<notas>\n{notas_semana}\n</notas>\nResuma la semana de estudio de Sofía.'}],
)
# Motivo de parada antes de leer el contenido:
if respuesta.stop_reason == 'refusal':
    raise RuntimeError('El modelo rechazó la petición.')
resumen = ''.join(b.text for b in respuesta.content if b.type == 'text')
uso = respuesta.usage
coste = uso.input_tokens * 0.10 / 1e6 + uso.output_tokens * 0.50 / 1e6
print(resumen)
print(f'Palabras: {len(resumen.split())} | entrada {uso.input_tokens} | salida {uso.output_tokens} | coste {coste:.6f} USD')

# El normalizador es la red de seguridad por si se cuela una cifra; luego narra VITS:
texto_oral = normalizar(resumen)
tts.tts_to_file(text = texto_oral, file_path = 'cuaderno_vivo/audio/dia14_resumen_semana.wav')

# Salida de ejemplo (puede variar):
# Esta semana, Sofía estudió cuatro temas. En estadística, aprendió que la media se deja llevar
# por los valores extremos. En Python, vio que pandas lee y resume tablas con pocas líneas. En
# arte, recordó que el impresionismo pintó la luz al aire libre. Y en música, practicó guitarra
# con metrónomo para tocar a tiempo. Buen trabajo. ¿Qué tema repasará mañana?
# Palabras: 60 | entrada 214 | salida 97 | coste 0.000070 USD
El ejemplo cumple las reglas: $60$ palabras, ninguna frase de más de $13$, los números con letra (“cuatro temas”) y una pregunta final. El coste de la llamada ronda los $0.00007$ USD; un resumen por semana cuesta menos de un centavo de dólar al año, una cifra que no cambia el presupuesto de $10$ USD al mes del Día 4.
Note también lo que el ejemplo no resuelve: “Python” y “pandas” siguen ahí. Son palabras que Sofía quiere oír, pero que un modelo entrenado con audiolibros en español pronunciará con reglas del español, como hacía la función a_fonemas del bloque 3. Para un cuaderno personal es aceptable; si le molesta, la solución es un pequeño diccionario de excepciones aplicado antes del modelo, del mismo estilo que SIGLAS.
Atención aquí: Toda narración sintética que vaya a escuchar otra persona debe decir que lo es. El Cuaderno Vivo añade al principio de cada audio la frase “Voz generada con IA” y la escribe en los metadatos del archivo. Revise además la licencia de cada modelo y de cada conjunto de datos antes de publicar: el corpus CSS10 en español procede de audiolibros de dominio público y el catálogo declara el modelo VITS como BSD-3-Clause, pero XTTS-v2 solo admite uso no comercial, y una voz de un conjunto de datos no le da derecho a presentarla como la de una persona concreta.
Evaluar una voz sintética
La segunda pregunta de Diego era cómo demostrar que una voz suena mejor que otra. La respuesta tiene dos partes, porque una voz sintética puede fallar de dos maneras distintas: puede sonar mal (metálica, plana, con chasquidos) o puede decir mal (saltarse una palabra, cambiar “treinta” por “trenta”). Lo primero se mide preguntando a personas; lo segundo, comparando lo que se pidió decir con lo que se entiende.
MOS: la opinión media de los oyentes
La puntuación media de opinión (o MOS, por sus siglas en inglés: “Mean Opinion Score”) es la métrica clásica, definida por la recomendación P.800 de la Unión Internacional de Telecomunicaciones para evaluar la calidad de las llamadas telefónicas. Un grupo de oyentes escucha cada muestra y la califica en una escala de $1$ (mala) a $5$ (excelente); el MOS es la media de esas calificaciones. Como cualquier media de una muestra pequeña, debe ir acompañada de su incertidumbre:
$$ \text{MOS}=\bar{x}=\frac{1}{n}\sum_{i=1}^{n}x_i,\qquad IC_{95%}=\bar{x}\pm 1.96,\frac{s}{\sqrt{n}} $$
La lógica detrás de esta métrica es la siguiente:
- $\bar{x}$ es la media de las $n$ calificaciones de un sistema. Resume la opinión del grupo en un solo número comparable entre sistemas.
- $s$ es la desviación estándar de las calificaciones, calculada con $n-1$ en el denominador. Mide cuánto discrepan los oyentes entre sí: si todos dan un $4$, $s = 0$; si unos dan $2$ y otros $5$, $s$ es grande.
- $s/\sqrt{n}$ es el error estándar de la media. Disminuye con la raíz del número de oyentes: para reducir el margen a la mitad, hacen falta cuatro veces más oyentes.
- $1.96$ es el valor de la distribución normal que deja el $95%$ de la probabilidad en el centro. En conclusión, el intervalo dice entre qué valores estaría el MOS verdadero si se repitiera el experimento con otros oyentes.
Sofía organizó una prueba de juguete con cinco amigos, entre ellos Diego. Cada uno escuchó tres muestras: la vocal sintética del bloque 4, la frase de VITS en español y la misma frase con XTTS-v2. Las $15$ calificaciones aparecen en la Tabla 5. Son datos de juguete, inventados para enseñar el cálculo, no una medición real de esos sistemas.
Tabla 5. MOS de juguete: tres sistemas calificados por cinco oyentes (escala de 1 a 5).
| Sistema | Oyente 1 | Oyente 2 | Oyente 3 | Oyente 4 | Oyente 5 |
|---|---|---|---|---|---|
| Vocal sintética (fuente-filtro) | 2 | 2 | 1 | 2 | 3 |
| VITS en español (CSS10) | 4 | 3 | 4 | 4 | 3 |
| XTTS-v2 multilingüe | 4 | 5 | 4 | 5 | 4 |
El bloque siguiente calcula la media, la desviación estándar y el intervalo al $95%$ de cada sistema y los dibuja como barras con su margen:
# MOS de juguete: 3 sistemas, 5 oyentes y un intervalo de confianza al 95 % en Python:
mos = pd.DataFrame({
    'Vocal sintética (fuente-filtro)': [2, 2, 1, 2, 3],
    'VITS en español (CSS10)': [4, 3, 4, 4, 3],
    'XTTS-v2 multilingüe': [4, 5, 4, 5, 4],
}, index = [f'oyente_{k}' for k in range(1, 6)])
resumen_mos = pd.DataFrame({'media': mos.mean(), 'desviacion': mos.std(ddof = 1), 'n': mos.count()})
resumen_mos['margen_95'] = 1.96 * resumen_mos['desviacion'] / np.sqrt(resumen_mos['n'])
resumen_mos['inferior'] = resumen_mos['media'] - resumen_mos['margen_95']
resumen_mos['superior'] = resumen_mos['media'] + resumen_mos['margen_95']
print(mos.T.to_string())
print(resumen_mos.round(2).to_string())

# Barras del MOS medio con su intervalo:
fig, eje = plt.subplots(figsize = (8, 4.6))
colores_mos = ['#2a78d6', '#eb6834', '#1baf7a']
eje.bar(range(3), resumen_mos['media'], yerr = resumen_mos['margen_95'], color = colores_mos,
        width = 0.55, capsize = 8, edgecolor = '#fcfcfb', linewidth = 2)
for k, (media, margen) in enumerate(zip(resumen_mos['media'], resumen_mos['margen_95'])):
    eje.text(k, media + margen + 0.12, f'{media:.2f} ± {margen:.2f}', ha = 'center', fontsize = 10, color = '#0b0b0b')
eje.set_xticks(range(3)); eje.set_xticklabels(['Vocal sintética', 'VITS en español', 'XTTS-v2'])
eje.set_ylim(0, 5.5); eje.set_ylabel('MOS (1 = malo, 5 = excelente)')
eje.axhline(4, color = '#52514e', ls = ':', lw = 1)
eje.text(-0.45, 4.05, 'MOS 4', fontsize = 9, color = '#52514e', ha = 'left', va = 'bottom')
eje.set_title('MOS de juguete con intervalo de confianza al 95 %', fontsize = 16)
plt.tight_layout()
plt.show()
                                 oyente_1  oyente_2  oyente_3  oyente_4  oyente_5
Vocal sintética (fuente-filtro)         2         2         1         2         3
VITS en español (CSS10)                 4         3         4         4         3
XTTS-v2 multilingüe                     4         5         4         5         4
                                 media  desviacion  n  margen_95  inferior  superior
Vocal sintética (fuente-filtro)    2.0        0.71  5       0.62      1.38      2.62
VITS en español (CSS10)            3.6        0.55  5       0.48      3.12      4.08
XTTS-v2 multilingüe                4.4        0.55  5       0.48      3.92      4.88
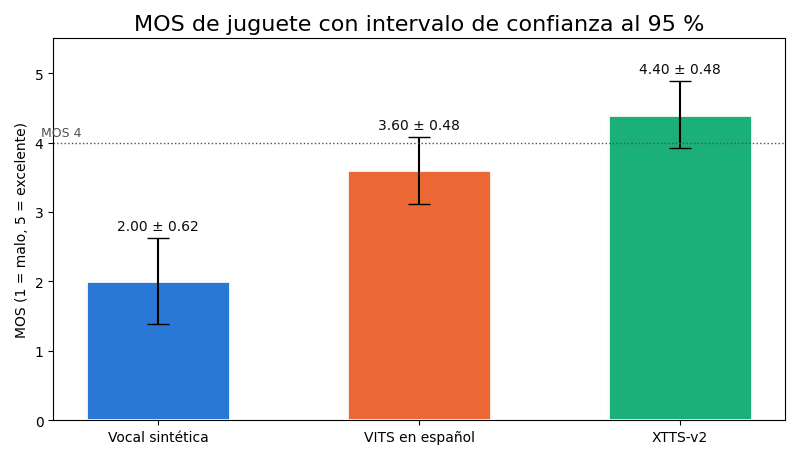
Los resultados ordenan los sistemas como se esperaba: la vocal sintética obtiene un MOS de $2.00 \pm 0.62$, VITS en español $3.60 \pm 0.48$ y XTTS-v2 $4.40 \pm 0.48$. Pero la parte más interesante está en los intervalos. El de VITS va de $3.12$ a $4.08$ y el de XTTS-v2 de $3.92$ a $4.88$: se solapan entre $3.92$ y $4.08$. Con cinco oyentes, Sofía puede afirmar con confianza que la vocal sintética es peor que los dos modelos neuronales, pero no que XTTS-v2 sea mejor que VITS. La diferencia de $0.8$ puntos podría deberse a quiénes escucharon.
El factor $1.96$ supone una muestra grande. Con solo cinco oyentes, lo correcto es usar el valor de la distribución t de Student con cuatro grados de libertad, $2.776$, y el margen crece: de $0.48$ a $0.68$ para VITS y XTTS-v2, y de $0.62$ a $0.88$ para la vocal sintética. Las evaluaciones publicadas usan decenas de oyentes y muchas frases por sistema; con cinco amigos, el MOS es una orientación, no una prueba.
El MOS tiene además límites de diseño que ninguna cuenta corrige. Los oyentes califican en relación con lo que acaban de oír, de modo que la misma voz recibe más puntos si suena después de la vocal sintética que si suena después de una grabación humana; por eso las pruebas serias mezclan el orden y añaden grabaciones reales como referencia. Tampoco distingue entre “suena natural” y “dice lo correcto”: una voz preciosa que se salta una palabra puede sacar un $5$.
Calcular el WER
Para la segunda dimensión, la de “decir bien”, se usa la tasa de error de palabras (o WER, por sus siglas en inglés: “Word Error Rate”). Se toma el texto que se pidió sintetizar (la referencia), se transcribe el audio generado (la hipótesis, escrita por una persona o por un reconocedor automático de voz) y se cuenta el mínimo número de ediciones de palabras que convierten una en otra:
$$ WER=\frac{S+B+I}{N} $$
La lógica de la fórmula es la siguiente:
- $S$ son las sustituciones: palabras de la referencia que se oyen como otras (“treinta” por “trenta”).
- $B$ son los borrados: palabras de la referencia que desaparecen. En la literatura en inglés se escribe $D$, de deletions.
- $I$ son las inserciones: palabras que aparecen en la hipótesis sin estar en la referencia.
- $N$ es el número de palabras de la referencia. El WER es, por tanto, una proporción de errores por palabra pedida. No tiene techo en $1$: una hipótesis con muchas inserciones puede superar el $100%$.
Contar el mínimo de ediciones es el problema clásico de la distancia de edición (o distancia de Levenshtein), aplicado a palabras en lugar de letras, y se resuelve con programación dinámica: una tabla $D$ en la que cada celda guarda el mínimo de ediciones para convertir las primeras $i$ palabras de la referencia en las primeras $j$ de la hipótesis. El bloque siguiente la implementa a mano, recorre la tabla hacia atrás para separar los tres tipos de error y la aplica a dos transcripciones de la frase de Sofía:
# Tasa de error de palabras (WER) con programación dinámica en Python:
def preparar(texto):
    # Minúsculas, sin tildes ni signos, separado en palabras:
    return re.findall(r'\w+', texto.lower().translate(SIN_TILDES))

def wer(referencia, hipotesis):
    r, h = preparar(referencia), preparar(hipotesis)
    # D[i][j] = mínimo de ediciones para convertir r[:i] en h[:j]:
    D = np.zeros((len(r) + 1, len(h) + 1), dtype = int)
    D[:, 0], D[0, :] = np.arange(len(r) + 1), np.arange(len(h) + 1)
    for i in range(1, len(r) + 1):
        for j in range(1, len(h) + 1):
            costo = 0 if r[i - 1] == h[j - 1] else 1
            D[i, j] = min(D[i - 1, j] + 1, D[i, j - 1] + 1, D[i - 1, j - 1] + costo)
    # Recorrido hacia atrás para contar sustituciones, borrados e inserciones:
    i, j, S, B, I = len(r), len(h), 0, 0, 0
    while i > 0 or j > 0:
        if i > 0 and j > 0 and D[i, j] == D[i - 1, j - 1] + (r[i - 1] != h[j - 1]):
            S += r[i - 1] != h[j - 1]; i, j = i - 1, j - 1
        elif i > 0 and D[i, j] == D[i - 1, j] + 1:
            B += 1; i -= 1
        else:
            I += 1; j -= 1
    return D[len(r), len(h)] / len(r), int(S), B, I, len(r)

referencia = normalizar('Sofía gastó 3.84 USD en 30 días.')
transcripciones = {'VITS en español': 'Sofía gastó tres dólares con ochenta y cuatro centavos en trenta días',
                   'XTTS-v2': 'Sofía gastó tres dólares ochenta y cuatro centavos en treinta y días'}
print('Referencia:', referencia)
for sistema, hipotesis in transcripciones.items():
    tasa, S, B, I, N = wer(referencia, hipotesis)
    print(f'{sistema:16s} WER = ({S} + {B} + {I}) / {N} = {tasa:.3f}')
Referencia: Sofía gastó tres dólares con ochenta y cuatro centavos en treinta días.
VITS en español  WER = (1 + 0 + 0) / 12 = 0.083
XTTS-v2          WER = (0 + 1 + 1) / 12 = 0.167
La referencia, normalizada por el bloque 2, tiene $12$ palabras. La transcripción de VITS tiene una sola sustitución, “trenta” en lugar de “treinta”, y su WER es $1/12 = 0.083$. La de XTTS-v2 no cambia ninguna palabra, pero pierde “con” y añade una “y” de más: un borrado y una inserción, y un WER de $2/12 = 0.167$, el doble.
El resultado parece contradecir al MOS, que prefería XTTS-v2, y en realidad lo complementa. Las dos métricas miden cosas distintas: el MOS, cuán agradable y natural suena la voz; el WER, cuán fiel es al texto. Un modelo que clona voces con mucha naturalidad puede, a la vez, “comerse” palabras cortas como “con”, un fallo conocido de los modelos autorregresivos. Para el Cuaderno Vivo, que narra cifras de estudio y de gasto, un error de contenido es más grave que una voz algo menos natural. Con frases de $12$ palabras, cada error vale $8.3$ puntos porcentuales; en una evaluación real, el WER se calcula sobre cientos de frases y la transcripción la hace un reconocedor automático, como Whisper, cuya propia tasa de error hay que medir antes con grabaciones humanas.
Observe por último la función preparar: pasa todo a minúsculas y quita tildes y signos antes de comparar. Sin ese paso, “Sofía” y “sofia” contarían como una sustitución y el WER mediría la ortografía del transcriptor, no la voz.
Consideraciones finales
Hoy el Cuaderno Vivo aprendió a leer en voz alta con una voz genérica, la de un modelo VITS entrenado con audiolibros en español. Es una voz que no pertenece a nadie que Sofía conozca, sin riesgo de suplantación y con una licencia permisiva. Mañana el problema cambia: Sofía quiere que el resumen suene con su propia voz, y eso exige grabarse, documentar su consentimiento y aceptar las reglas de un modelo de clonación.
Lo que ha visto hoy sirve para entender lo que pasará dentro de ese modelo. La clonación no cambia la cadena: sigue habiendo normalización, fonemas, un modelo acústico y un vocoder. Lo único que se añade es un vector que describe el timbre del hablante y condiciona al modelo acústico, lo mismo que el filtro del modelo fuente-filtro decide la vocal sin tocar la fuente.
Antes de dar la voz por buena, conviene hacerse algunas preguntas:
- ¿El normalizador cubre los números, fechas y siglas que aparecen de verdad en las notas de Sofía? Una lista de $50$ frases reales con sus lecturas correctas es la mejor prueba.
- ¿La entonación de las preguntas del resumen sube al final? Puede comprobarlo con el YIN del bloque 5 sobre el WAV de VITS, después de remuestrearlo a $16,000$ Hz.
- ¿Cuántos oyentes harían falta para separar dos voces cuyo MOS difiere en $0.3$ puntos? Con una desviación de $0.55$, el margen debería bajar de $0.15$, y eso exige unos $52$ oyentes.
- ¿Qué pasa con el WER cuando el resumen incluye palabras en inglés como “Python”? Si el reconocedor tampoco las entiende, el error no será de la voz.
Las cifras de hoy tienen límites claros. Las vocales y las frases son señales sintéticas, sin consonantes ni ruido; el MOS y las transcripciones son datos de juguete que ilustran el cálculo; y las salidas de los bloques de coqui-tts y de Claude son ejemplos que variarán en su equipo. Ninguno de esos límites invalida los métodos, que son los mismos que se usan para evaluar los sistemas comerciales.
Un gran libro que habla de esto es Text-to-Speech Synthesis (sin traducción al español), en el que Paul Taylor recorre la cadena completa, desde la normalización del texto y la prosodia hasta la síntesis concatenativa y estadística, con una claridad que no ha perdido vigencia. Aunque es anterior a las redes neuronales, sus capítulos sobre el análisis del texto y la entonación explican problemas que los modelos de hoy siguen teniendo, como el del “600” de este día.
Una voz sintética no se juzga por lo bien que suena una vez, sino por lo que dice bien cada vez y por cuántas personas lo confirman. La cadena del Cuaderno Vivo ya tiene un normalizador que se puede ampliar, un modelo que se puede cambiar y dos métricas que permiten decidir con números cuándo una voz es suficientemente buena para escucharla cada mañana.
Conclusiones clave
La cadena del TTS
- Un sistema de texto a voz encadena normalización, conversión a fonemas, un modelo acústico que predice un espectrograma de mel y un vocoder que lo convierte en onda.
- La mayoría de los errores que se atribuyen “a la IA” son de normalización: el diccionario de $0$ a $99$ lee “600” como “seis cero cero”.
- Pedir a Claude un resumen escrito para el oído, con números en letra y sin siglas, evita gran parte de esos errores por menos de un centavo al año.
Fuente-filtro y prosodia
- La voz es una fuente (armónicos de $F_0$) multiplicada por un filtro (formantes): con $F_0 = 120$ Hz y dos resonadores, los picos salen en $801$ y $1188$ Hz para /a/, $297$ y $2297$ Hz para /i/ y $301$ y $785$ Hz para /u/.
- El armónico más fuerte no coincide con el formante ($840$ Hz frente a $800$ en /a/), porque la fuente solo tiene energía en los múltiplos de $F_0$.
- YIN recupera la entonación con un error medio de $0.12$ a $0.19$ Hz, pero deja marcos sin respuesta cuando $F_0$ sube muy rápido, como en el final de una pregunta.
- Una envolvente ADSR lleva la última muestra a cero y elimina el chasquido final, a cambio de conservar solo el $34%$ de la energía.
Evaluación
- El MOS de juguete ordena los sistemas ($2.00$, $3.60$ y $4.40$), pero con cinco oyentes los intervalos de VITS y XTTS-v2 se solapan y no permiten declarar un ganador.
- El WER mide la fidelidad al texto: una sustitución en $12$ palabras da $0.083$, y un borrado más una inserción, $0.167$.
- MOS y WER son complementarios: una voz más natural puede ser menos fiel, y en un cuaderno que narra cifras pesa más la fidelidad.
Mañana, en el Día 15: Clonación vocal con consentimiento: su propia voz. El Cuaderno Vivo dejará la voz genérica de hoy para narrar con la de Sofía: verá cómo un modelo como XTTS-v2 extrae el timbre de unos segundos de grabación, cómo comparar una herramienta local con un servicio en la nube y por qué el primer archivo del proyecto no es un audio, sino un consentimiento firmado.
Referencias
- Shen, J., Pang, R., Weiss, R. J. et al. (2018). Natural TTS Synthesis by Conditioning WaveNet on Mel Spectrogram Predictions. IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP 2018), 4779-4783.
- Kim, J., Kong, J. y Son, J. (2021). Conditional Variational Autoencoder with Adversarial Learning for End-to-End Text-to-Speech. Proceedings of the 38th International Conference on Machine Learning (ICML 2021).
- Taylor, P. (2009). Text-to-Speech Synthesis. Cambridge University Press.
- Fant, G. (1960). Acoustic Theory of Speech Production. Mouton.
- Klatt, D. H. (1980). Software for a Cascade/Parallel Formant Synthesizer. Journal of the Acoustical Society of America, 67(3), 971-995.
- de Cheveigné, A. y Kawahara, H. (2002). YIN, a Fundamental Frequency Estimator for Speech and Music. Journal of the Acoustical Society of America, 111(4), 1917-1930.
- Mauch, M. y Dixon, S. (2014). pYIN: A Fundamental Frequency Estimator Using Probabilistic Threshold Distributions. ICASSP 2014, 659-663.
- van den Oord, A., Dieleman, S., Zen, H. et al. (2016). WaveNet: A Generative Model for Raw Audio. arXiv:1609.03499.
- Park, K. y Mulc, T. (2019). CSS10: A Collection of Single Speaker Speech Datasets for 10 Languages. Interspeech 2019.
- Casanova, E., Davis, K., Gölge, E. et al. (2024). XTTS: a Massively Multilingual Zero-Shot Text-to-Speech Model. Interspeech 2024.
- Unión Internacional de Telecomunicaciones (1996). Recomendación UIT-T P.800: Métodos de determinación subjetiva de la calidad de transmisión.
- Idiap Research Institute (2026). coqui-ai-TTS, bifurcación mantenida de Coqui TTS (paquete
coqui-tts). https://github.com/idiap/coqui-ai-TTS