IA generativa en proyectos personales: Día 2
 Jeshua Romero Guadarrama
- 43 Min para leer
- 02 Jan, 2026
Índice de contenido
Resumen:
Un modelo de lenguaje no lee palabras: lee tokens, que son trozos de texto elegidos por un tokenizador, y los convierte en vectores para poder compararlos. En esta entrada se programa desde cero un BPE (Byte Pair Encoding) de juguete, se mide cuántos tokens cuesta la misma nota en español y en inglés, se representan las 12 notas de Sofía como vectores TF-IDF y LSA con su similitud coseno, y se cuenta el contenido de la ventana de contexto con la API de Claude. Al terminar, sabrá estimar cuánto texto cabe en una petición y por qué ese conteo depende del modelo.
¿Cómo citar el presente artículo?
Romero, J. (2 de enero de 2026). IA generativa en proyectos personales: Día 2. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_2/.
IA generativa en proyectos personales: Día 2 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_2/.
Día 2. Tokens, embeddings y la ventana de contexto
Modelos, precios y regulación revisados en octubre de 2026.
Introducción
Ayer, en el Día 1, se vio qué distingue a un modelo generativo de uno discriminativo y el Cuaderno Vivo ganó su primer generador de frases de juguete, un modelo de bigramas entrenado con las 12 notas de estudio de Sofía. Ese modelo tenía un defecto que Diego señaló enseguida: trabajaba con palabras completas, de modo que una palabra que no había visto nunca, como “bayesiana” o “metrónomos”, simplemente no existía para él. Su probabilidad era cero y la perplejidad se disparaba en cuanto aparecía.
Los modelos de lenguaje actuales resuelven ese problema con una idea sencilla y muy eficaz: no parten el texto en palabras ni en letras, sino en trozos intermedios llamados tokens. Un token puede ser una palabra corta y frecuente (“la”), un fragmento común (“ción”, “est”) o una sola letra cuando no hay nada mejor. Con unas pocas decenas de miles de trozos se puede escribir cualquier texto, y las palabras frecuentes ocupan un único token.
Pero partir el texto es solo la mitad del trabajo. Para que una máquina diga que dos notas “se parecen”, cada nota tiene que convertirse en un vector de números, y el parecido tiene que medirse con una fórmula. Y como cada token se paga y ocupa espacio, hay un límite a lo que cabe en una petición: la ventana de contexto.
En la presente entrada, descubrirá cómo funciona el algoritmo BPE (por sus siglas en inglés: “Byte Pair Encoding”) programándolo en unas treinta líneas de Python, verá crecer su vocabulario fusión a fusión y medirá la disyuntiva entre tamaño de vocabulario y longitud de secuencia. Comprobará con datos que el mismo contenido cuesta más tokens en un idioma que en otro. Después convertirá las notas de Sofía en vectores TF-IDF, las comparará con la similitud coseno, dibujará un mapa de dos dimensiones con LSA y construirá una pequeña función de vecinos que el Día 7 convertirá en memoria. Por último, contará tokens con la API de Claude. La pieza que el Cuaderno Vivo gana hoy es su tokenizador propio y un primer buscador de notas parecidas.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Explicar por qué los modelos trabajan con tokens de subpalabra y no con palabras ni con caracteres.
- Implementar un BPE (Byte Pair Encoding) de juguete y ver crecer el vocabulario fusión a fusión.
- Representar notas como vectores (TF-IDF y LSA) y medir su parecido con la similitud coseno.
- Entender la ventana de contexto como un presupuesto de tokens y contarlos con
count_tokens.
Tres maneras de partir un texto
Antes de escribir código conviene fijar la pregunta: ¿en qué unidades debe leer un modelo el texto? Hay tres respuestas naturales, y cada una tiene un coste distinto.
La primera es partir por caracteres. El vocabulario es diminuto (las letras, los dígitos, los signos de puntuación y unas pocas tildes), y no existe ninguna palabra desconocida: cualquier texto se puede escribir letra a letra. El precio es la longitud. Una nota de veinte palabras se convierte en más de cien unidades, y el modelo tiene que aprender a juntar letras para formar significado antes de poder hacer nada útil con él. Además, como verá en la sección de la ventana de contexto, cada unidad ocupa espacio y se paga.
La segunda es partir por palabras, que es lo que hizo el modelo de bigramas del Día 1. Las secuencias son cortas y cada unidad ya tiene significado propio. El precio ahora es el vocabulario: el español tiene conjugaciones, plurales, género y derivaciones, de modo que “nota”, “notas”, “notable” y “anotar” serían cuatro entradas sin relación aparente. Un vocabulario de palabras para un idioma real necesitaría cientos de miles de entradas y, aun así, fallaría con nombres propios, erratas o términos técnicos nuevos.
La tercera es partir por subpalabras. Las palabras frecuentes se quedan enteras y las raras se descomponen en fragmentos conocidos. “bayesiana” se puede escribir como “ba” + “y” + “e” + “si” + “a” + “na” si el tokenizador no ha visto la palabra completa suficientes veces. Es un compromiso: el vocabulario es fijo y manejable, ninguna palabra es imposible y las secuencias son bastante más cortas que con letras.
Veamos las tres particiones con dos textos: el fragmento “estadística bayesiana”, un término que Sofía todavía no ha anotado (ninguna de sus 12 notas contiene “bayesiana”), y la nota 1 completa, la de la media. La Tabla 1 resume cuántas unidades produce cada método. Las cifras de la columna de subpalabras salen del BPE que se entrena más adelante (Bloque 5, con $150$ fusiones aprendidas de las propias notas).
Tabla 1. La nota 1 partida por caracteres, palabras y subpalabras (número de unidades).
| Texto | Caracteres | Palabras | Subpalabras (BPE, 150 fusiones) |
|---|---|---|---|
| “estadística bayesiana” | 21 | 2 | 13 |
| Nota 1 completa | 110 | 21 | 28 |
Como puede ver, las subpalabras quedan en medio, y su comportamiento depende de si el texto se parece a lo que el tokenizador vio al entrenarse. La nota 1, que sí formó parte del entrenamiento, necesita solo $28$ subpalabras para $21$ palabras. El fragmento nuevo, en cambio, necesita $13$ subpalabras para $2$ palabras: “bayesiana” nunca apareció y se reconstruye a trozos. En un tokenizador real, con decenas de miles de entradas aprendidas de miles de millones de palabras, la proporción de subpalabras por palabra es mucho más cercana a uno, porque casi todas las palabras frecuentes tienen un token propio. El BPE de esta entrada aprende solo de $238$ palabras, así que sus cifras son de juguete y sirven para entender el mecanismo, no para estimar costes reales.
Una medida útil para comparar tokenizadores es la fertilidad, es decir, cuántos tokens produce en promedio cada palabra:
$$ \text{fertilidad}=\frac{\text{número de tokens}}{\text{número de palabras}} $$
La lógica detrás de esta medida es directa:
- El numerador cuenta lo que el modelo procesa y lo que el proveedor cobra: los tokens.
- El denominador cuenta lo que el lector percibe como “tamaño” del texto: las palabras.
- En conclusión, una fertilidad alta significa que el tokenizador conoce mal ese tipo de texto y lo trocea en exceso. Para la nota 1 y el BPE de juguete, la fertilidad es $28 / 21 \approx 1.33$; para el fragmento "estadística bayesiana" sube a $13 / 2 = 6.5$.
Comencemos por preparar el entorno. El primer bloque de cada día de la serie fija las importaciones y la semilla global $2026$, para que todas las cifras de la entrada se puedan reproducir:
# Importaciones base y semilla global de la serie en Python:
import warnings
warnings.filterwarnings('ignore')
import re
from collections import Counter
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

np.random.seed(2026)
rng = np.random.default_rng(2026)
Con el entorno listo, el siguiente bloque carga las 12 notas de Sofía (las mismas del Día 1) en un DataFrame y parte la nota 1 por caracteres y por palabras:
# Las 12 notas de Sofía (Tabla 1 del Día 1) y su partición por caracteres y por palabras en Python:
notas = pd.DataFrame({
    'id': range(1, 13),
    'tema': ['estadística'] * 3 + ['python'] * 3 + ['historia del arte'] * 3 + ['música'] * 3,
    'texto': [
        'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.',
        'La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos.',
        'Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra.',
        'En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos.',
        'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.',
        'Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código.',
        'El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura.',
        'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.',
        'El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro.',
        'Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra.',
        'Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones.',
        'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'
    ]
})

def palabras_de(texto):
    # Minúsculas y solo letras (con tildes y eñes):
    return re.findall(r'[a-záéíóúüñ]+', texto.lower())

notas['palabras'] = notas['texto'].apply(lambda t: len(palabras_de(t)))
print('Total de palabras del corpus:', notas['palabras'].sum())

# Partición de la nota 1 por caracteres y por palabras:
nota_1 = notas.loc[0, 'texto']
caracteres = list(nota_1)
print('Caracteres:', len(caracteres), caracteres[:12])
print('Palabras:', len(nota_1.split()), nota_1.split()[:6])
Total de palabras del corpus: 238
Caracteres: 110 ['L', 'a', ' ', 'm', 'e', 'd', 'i', 'a', ' ', 'r', 'e', 's']
Palabras: 21 ['La', 'media', 'resume', 'un', 'conjunto', 'de']
El corpus completo tiene $238$ palabras, la misma cifra que se obtuvo en el Día 1. La nota 1 ocupa $110$ caracteres (contando espacios y signos de puntuación) y $21$ palabras. Observe dos detalles de la salida. El primero: la partición por caracteres trata el espacio como una unidad más, y una letra con tilde, como la “ú” de “número”, es un carácter distinto de la “u”. El segundo: la partición por palabras con split() deja “La” con mayúscula y pega la coma a “número,”; por eso la función palabras_de pasa todo a minúsculas y se queda solo con letras. Esa limpieza ya es una decisión de tokenización: dos textos que solo difieren en una mayúscula producen los mismos tokens.
BPE paso a paso
El algoritmo BPE nació en 1994 como un método de compresión de datos y fue adaptado al procesamiento del lenguaje por Sennrich, Haddow y Birch en 2016 para traducir palabras raras. La idea es tan simple que cabe en una frase: empiece con letras sueltas y fusione, una y otra vez, el par de símbolos contiguos más frecuente. Cada fusión crea un símbolo nuevo y lo añade al vocabulario. Tras miles de fusiones, las palabras frecuentes quedan como un solo símbolo y las raras como unos pocos.
Para verlo con calma usaremos un corpus mínimo con cinco palabras de la familia de “nota” y “cuaderno”, repetidas con distinta frecuencia (el cual se puede consultar en la Tabla 2). Son $17$ apariciones de $5$ palabras distintas.
Tabla 2. Corpus BPE de juguete con frecuencias.
| Palabra | Frecuencia | Símbolos iniciales |
|---|---|---|
| nota | 6 | n o t a</w> |
| notas | 4 | n o t a s</w> |
| notable | 2 | n o t a b l e</w> |
| cuaderno | 3 | c u a d e r n o</w> |
| cuadernos | 2 | c u a d e r n o s</w> |
La marca </w> (fin de palabra) va pegada a la última letra. Sirve para que el tokenizador distinga una “a” que termina palabra (“nota”) de una “a” que va en medio (“notable”). Sin ella, al volver a unir los tokens no sabríamos dónde poner los espacios.
En cada paso, BPE elige el par que más veces aparece, ponderando cada palabra por su frecuencia:
$$ (a^{},b^{})=\underset{(a,b)}{\arg\max}\sum_{w}f(w),c_{w}(a,b) $$
La lógica detrás de esta regla es múltiple:
- $c_{w}(a,b)$ cuenta cuántas veces aparece el par de símbolos $a$ seguido de $b$ dentro de la palabra $w$, tal como está partida en ese momento.
- $f(w)$ es la frecuencia de la palabra en el corpus. Multiplicar por ella hace que un par presente en una palabra muy común pese más que uno presente en una palabra rara.
- El $\arg\max$ se queda con el par ganador. Ese par se sustituye por un símbolo nuevo en todas las palabras y el proceso se repite.
- En conclusión, BPE es un algoritmo voraz: decide la mejor fusión de este paso sin mirar las siguientes. No garantiza la partición óptima, pero es rápido y determinista.
Haciendo la cuenta a mano con la Tabla 2: el par “n o” aparece en “nota” ($6$), “notas” ($4$), “notable” ($2$) y “cuadernos” ($2$), lo que da $14$. En “cuaderno” la “o” final lleva la marca de fin y forma el par distinto “n o</w>”. El par “o t” suma $6 + 4 + 2 = 12$. Así que la primera fusión debería ser “n” + “o”. Comprobémoslo con código.
Las fusiones
El siguiente bloque implementa BPE con tres funciones: a_simbolos prepara cada palabra, contar_pares aplica la suma de la fórmula anterior y fusionar sustituye el par ganador. La función entrenar_bpe las encadena el número de veces que se le pida:
# Implementación de BPE (Byte Pair Encoding) de juguete en Python:
def a_simbolos(frecuencias):
    # Cada palabra se parte en caracteres y el último lleva la marca de fin </w>:
    return {tuple(p[:-1]) + (p[-1] + '</w>',): f for p, f in frecuencias.items()}

def contar_pares(vocabulario):
    # Cuenta cada par de símbolos contiguos, ponderado por la frecuencia de la palabra:
    pares = Counter()
    for simbolos, f in vocabulario.items():
        for a, b in zip(simbolos, simbolos[1:]):
            pares[(a, b)] += f
    return pares

def fusionar(par, vocabulario):
    # Sustituye cada aparición del par por un símbolo nuevo:
    nuevo = {}
    for simbolos, f in vocabulario.items():
        salida, i = [], 0
        while i < len(simbolos):
            if i < len(simbolos) - 1 and (simbolos[i], simbolos[i + 1]) == par:
                salida.append(simbolos[i] + simbolos[i + 1])
                i += 2
            else:
                salida.append(simbolos[i])
                i += 1
        nuevo[tuple(salida)] = nuevo.get(tuple(salida), 0) + f
    return nuevo

def entrenar_bpe(frecuencias, n_fusiones):
    # Repite la fusión del par más frecuente n_fusiones veces:
    vocabulario = a_simbolos(frecuencias)
    fusiones = []
    for _ in range(n_fusiones):
        pares = contar_pares(vocabulario)
        if not pares:
            break
        mejor = max(pares, key = pares.get)
        fusiones.append((mejor, pares[mejor]))
        vocabulario = fusionar(mejor, vocabulario)
    return fusiones, vocabulario

# Corpus de juguete de la Tabla 2:
corpus_juguete = {'nota': 6, 'notas': 4, 'notable': 2, 'cuaderno': 3, 'cuadernos': 2}
fusiones, vocabulario = entrenar_bpe(corpus_juguete, 10)
for paso, ((a, b), f) in enumerate(fusiones, start = 1):
    print(f'{paso:>2}. {a} + {b} -> {a + b}  (frecuencia {f})')
print(vocabulario)
 1. n + o -> no  (frecuencia 14)
 2. no + t -> not  (frecuencia 12)
 3. not + a</w> -> nota</w>  (frecuencia 6)
 4. not + a -> nota  (frecuencia 6)
 5. c + u -> cu  (frecuencia 5)
 6. cu + a -> cua  (frecuencia 5)
 7. cua + d -> cuad  (frecuencia 5)
 8. cuad + e -> cuade  (frecuencia 5)
 9. cuade + r -> cuader  (frecuencia 5)
10. nota + s</w> -> notas</w>  (frecuencia 4)
{('nota</w>',): 6, ('notas</w>',): 4, ('nota', 'b', 'l', 'e</w>'): 2, ('cuader', 'n', 'o</w>'): 3, ('cuader', 'no', 's</w>'): 2}
La primera fusión es “n” + “o” con frecuencia $14$, tal como predijo la cuenta a mano. La segunda une “no” + “t” ($12$) y la tercera y cuarta crean “nota</w>” y “nota” ($6$ cada una). Aquí aparece un detalle fino: los pares “not + a</w>” y “not + a” empatan a $6$, y max se queda con el primero que encuentra. Los tokenizadores reales también necesitan una regla de desempate fija, porque de lo contrario dos entrenamientos con los mismos datos darían vocabularios distintos.
Las fusiones 5 a 9 construyen pacientemente “cuader” letra a letra ($5$ apariciones cada vez, la suma de “cuaderno” y “cuadernos”), y la décima crea “notas</w>”. El diccionario final muestra el estado del corpus tras las diez fusiones:
- “nota” y “notas” ya son un solo token cada una.
- “notable” queda como “nota” + “b” + “l” + “e</w>”: reutiliza el token “nota”, que es justo lo que se busca.
- “cuaderno” y “cuadernos” comparten el prefijo “cuader”. Si el lector escribiera “cuadernito”, el tokenizador lo partiría como “cuader” + letras, y el modelo recibiría al menos una pista sobre su significado.
Esta es la ventaja central de las subpalabras frente al modelo de bigramas del Día 1: ninguna palabra es desconocida, porque en el peor caso se puede escribir letra a letra, y las palabras emparentadas comparten piezas.
Vocabulario frente a longitud de secuencia
Cada fusión añade un símbolo al vocabulario y, a cambio, acorta los textos. Esa es la disyuntiva central de cualquier tokenizador. Un vocabulario pequeño produce secuencias largas, y un modelo con secuencias largas necesita más cálculo y llena antes su ventana de contexto. Un vocabulario enorme produce secuencias cortas, pero cada token aparece pocas veces en el entrenamiento y la tabla de embeddings (una fila de números por token) crece sin control.
Para ver la disyuntiva con datos, el siguiente bloque entrena BPE sobre las 238 palabras de las notas de Sofía y mide, para $0$ a $30$ fusiones, el tamaño del vocabulario y el número medio de tokens por nota. La función tokenizar aplica las fusiones aprendidas, en el mismo orden, a cualquier palabra, vista o no:
# Vocabulario frente a longitud de secuencia con 0 a 30 fusiones en Python:
frecuencias_notas = Counter(p for t in notas['texto'] for p in palabras_de(t))

def tokenizar(palabra, fusiones):
    # Aplica las fusiones aprendidas, en el mismo orden, a una palabra nueva:
    simbolos = list(palabra[:-1]) + [palabra[-1] + '</w>']
    for (a, b), _ in fusiones:
        i, salida = 0, []
        while i < len(simbolos):
            if i < len(simbolos) - 1 and simbolos[i] == a and simbolos[i + 1] == b:
                salida.append(a + b)
                i += 2
            else:
                salida.append(simbolos[i])
                i += 1
        simbolos = salida
    return simbolos

def contar_tokens(texto, fusiones):
    # Número de tokens de un texto completo:
    return sum(len(tokenizar(p, fusiones)) for p in palabras_de(texto))

alfabeto = set(s for simbolos in a_simbolos(frecuencias_notas) for s in simbolos)
fusiones_notas, _ = entrenar_bpe(frecuencias_notas, 30)
registros = []
for k in range(0, 31):
    longitud = np.mean([contar_tokens(t, fusiones_notas[:k]) for t in notas['texto']])
    registros.append({'fusiones': k, 'vocabulario': len(alfabeto) + k, 'tokens_por_nota': longitud})
barrido = pd.DataFrame(registros)
print(barrido.iloc[[0, 10, 20, 30]].round(1).to_string(index = False))
print('Primeras 8 fusiones:', [a + b for (a, b), _ in fusiones_notas[:8]])

fig, (ax1, ax2) = plt.subplots(2, 1, figsize = (6.4, 5.6), sharex = True)
ax1.plot(barrido['fusiones'], barrido['vocabulario'], color = '#2a78d6', linewidth = 2)
ax1.set_ylabel('Tamaño del vocabulario')
ax1.set_title('BPE: vocabulario frente a longitud', fontsize = 16)
ax2.plot(barrido['fusiones'], barrido['tokens_por_nota'], color = '#eb6834', linewidth = 2)
ax2.set_ylabel('Tokens por nota (media)')
ax2.set_xlabel('Número de fusiones')
for eje in (ax1, ax2):
    eje.grid(alpha = 0.3)
    eje.spines[['top', 'right']].set_visible(False)
plt.tight_layout()

# Cada fusión agranda el vocabulario y acorta las secuencias:
plt.show()
 fusiones  vocabulario  tokens_por_nota
        0           40             88.1
       10           50             76.8
       20           60             70.0
       30           70             64.6
Primeras 8 fusiones: ['la</w>', 'de</w>', 're', 'to', 'ar', 'co', 'un</w>', 'ar</w>']
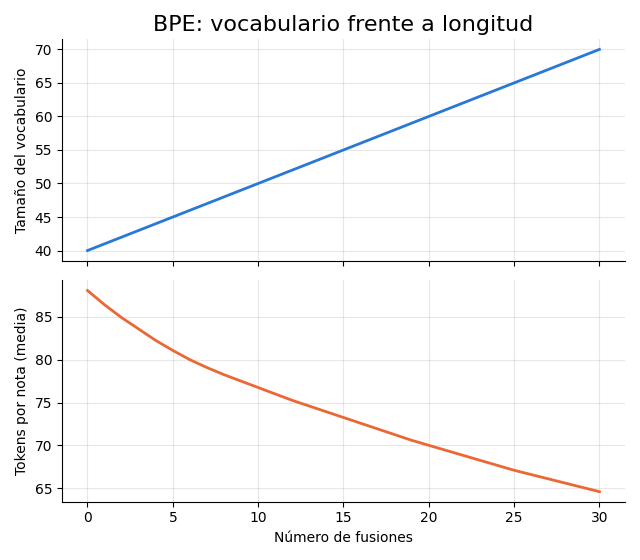
Sin fusiones, el vocabulario tiene $40$ símbolos (las letras y sus variantes con la marca de fin de palabra) y cada nota mide en promedio $88.1$ tokens, que es simplemente su número de letras. Con $30$ fusiones el vocabulario sube a $70$ y la longitud media baja a $64.6$ tokens, una reducción del $26.7%$.
El gráfico anterior muestra la disyuntiva en dos paneles con el mismo eje horizontal. El panel superior es una recta: cada fusión añade exactamente un símbolo. El panel inferior baja deprisa al principio y cada vez más despacio. Las primeras fusiones (“la</w>”, “de</w>”, “re”, “to”, “ar”, “co”, “un</w>”) capturan pares que aparecen en muchísimas palabras del español, así que cada una ahorra muchos tokens. Las fusiones posteriores capturan pares cada vez menos comunes y ahorran menos. Es la misma ley de rendimientos decrecientes que vio con la ley de Zipf en el Día 1: unas pocas piezas cubren gran parte del texto.
Más fusiones acortan el texto, pero cada fusión adicional ahorra menos que la anterior. Por eso los tokenizadores de los modelos grandes se detienen en un vocabulario de decenas de miles de entradas y no de millones: más allá, el ahorro en longitud no compensa el coste de una tabla de embeddings gigantesca y de tokens que casi nunca se ven en el entrenamiento.
Tokens en español y en inglés
Diego, que lleva días haciendo cuentas, lanza la pregunta incómoda: “Si la API cobra por token, ¿me saldría más barato escribirle al Cuaderno Vivo en inglés?”. La respuesta depende del tokenizador, y en particular de con qué textos se entrenó. Un tokenizador aprende fusiones del idioma que más ve; los textos en otros idiomas se trocean más y, por tanto, cuestan más.
Podemos comprobarlo con el BPE propio. El siguiente bloque entrena $150$ fusiones solo con las notas en español y cuenta los tokens de cinco notas y de su traducción al inglés:
# Tokens en español frente a inglés con el BPE entrenado solo en español en Python:
fusiones_es, _ = entrenar_bpe(frecuencias_notas, 150)
traducciones = {
    1: 'The mean summarizes a data set in a single number, but it is sensitive to the extreme values of the sample.',
    4: 'In Python a list stores elements in order and can be traversed with a for loop to add up the data.',
    7: 'The Renaissance recovered the perspective and proportion of classical art to give depth to painting.',
    8: 'Impressionism painted light outdoors with loose brushstrokes and pure colors unmixed on the palette.',
    10: 'A major scale follows the pattern tone, tone, semitone, tone, tone, tone, semitone and sounds cheerful on the guitar.'
}
comparacion = pd.DataFrame([{
    'id': i,
    'tokens_es': contar_tokens(notas.loc[notas['id'] == i, 'texto'].item(), fusiones_es),
    'tokens_en': contar_tokens(texto_en, fusiones_es)
} for i, texto_en in traducciones.items()])
comparacion['razon_en_es'] = (comparacion['tokens_en'] / comparacion['tokens_es']).round(2)
print(comparacion.to_string(index = False))
print('Razón media inglés/español:', round(comparacion['razon_en_es'].mean(), 2))
print('Fragmento en subpalabras:', [s for p in palabras_de('estadística bayesiana') for s in tokenizar(p, fusiones_es)])
print('Subpalabras de la nota 1:', contar_tokens(nota_1, fusiones_es))

posiciones = np.arange(len(comparacion))
fig, ax = plt.subplots(figsize = (6.4, 4.8))
ax.bar(posiciones - 0.2, comparacion['tokens_es'], width = 0.38, label = 'Español', color = '#2a78d6')
ax.bar(posiciones + 0.2, comparacion['tokens_en'], width = 0.38, label = 'Inglés', color = '#eb6834')
ax.set_xticks(posiciones)
ax.set_xticklabels([f'Nota {i}' for i in comparacion['id']])
ax.set_ylabel('Número de tokens')
ax.set_title('Mismo contenido, distinto número de tokens', fontsize = 16)
ax.legend(frameon = False)
ax.grid(axis = 'y', alpha = 0.3)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()

# El BPE entrenado en español castiga al texto en inglés:
plt.show()
 id  tokens_es  tokens_en  razon_en_es
  1         28         68         2.43
  4         35         55         1.57
  7         42         59         1.40
  8         51         67         1.31
 10         30         70         2.33
Razón media inglés/español: 1.81
Fragmento en subpalabras: ['est', 'ad', 'í', 'st', 'i', 'c', 'a</w>', 'b', 'ay', 'e', 'si', 'an', 'a</w>']
Subpalabras de la nota 1: 28
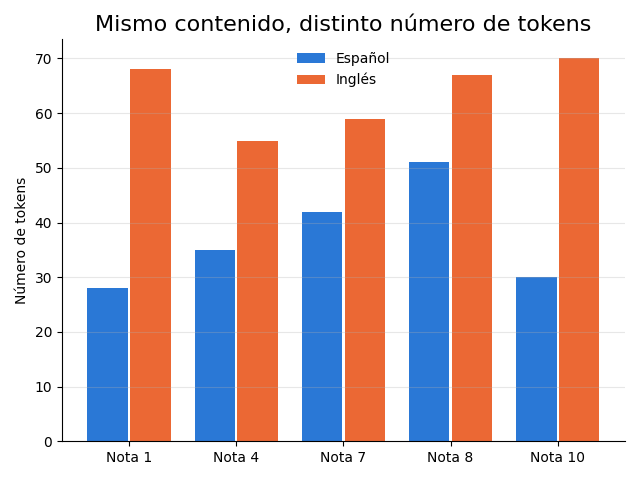
Con un tokenizador entrenado solo en español, la misma información en inglés cuesta en promedio $1.81$ veces más tokens. La peor nota es la 1 (la de la media), con una razón de $2.43$: $28$ tokens en español frente a $68$ en inglés. Le sigue la 10 (la escala mayor), con $2.33$: la repetición de “tono” y “semitono” llevó al BPE a aprender esas palabras completas, mientras que “tone” y “semitone” se trocean casi letra a letra. La más equilibrada es la 8 (impresionismo), con $1.31$. Ninguna traducción sale más barata, aunque el texto en inglés suele tener menos letras que el español.
Hay que reconocer que la comparación tiene trampa, y la trampa es instructiva. Las notas en español no solo están en el idioma del tokenizador: son literalmente el texto con el que se entrenó. Con $150$ fusiones y solo $238$ palabras, el BPE llega a memorizar palabras enteras de las notas. Un tokenizador real no memoriza sus textos de prueba, pero el efecto de fondo es el mismo: lo que se parece a los datos de entrenamiento del tokenizador se codifica con menos tokens.
La salida muestra además cómo queda el fragmento “estadística bayesiana” partido en subpalabras: “estadística” se descompone en siete piezas (“est”, “ad”, “í”, “st”, “i”, “c”, “a</w>”) y “bayesiana” en seis (“b”, “ay”, “e”, “si”, “an”, “a</w>”), porque ninguna de las dos palabras aparece en las notas. Esas son las $13$ subpalabras de la Tabla 1; la nota 1 completa, que sí está en el corpus, se queda en $28$.
El gráfico anterior muestra las barras agrupadas por nota: en todas, la barra del inglés supera a la del español. Ahora bien, el resultado no significa que el inglés sea “más caro” en general. Significa que el idioma con el que se entrena el tokenizador sale beneficiado. En los tokenizadores comerciales ocurre lo contrario que en este ejemplo, porque se entrenan con corpus dominados por el inglés: el español, y mucho más los idiomas con poca presencia en la web, se trocea más.
El efecto sobre la factura es proporcional. Suponga el volumen de uso que se fijará en el Día 4 para el Cuaderno Vivo: $20$ consultas al día, $30$ días al mes y $1,200$ tokens de entrada por consulta, es decir, $720,000$ tokens de entrada al mes. Con el precio de entrada de Claude Sonnet 5.5 ($2.00$ USD por millón), eso son $1.44$ USD. Si el mismo contenido necesitara $1.81$ veces más tokens, como en el ejemplo de juguete, la cifra subiría a unos $2.61$ USD. El cálculo es ilustrativo, pero la proporción es real: pagar por token es pagar por la forma en que el tokenizador ve su idioma.
Atención aquí: Esta desigualdad no es un detalle técnico, es un sesgo estructural. Petrov y colaboradores (2023) midieron que, con los tokenizadores de modelos comerciales, el mismo texto traducido puede necesitar varias veces más tokens en unos idiomas que en otros. Eso significa más coste, menos texto dentro de la misma ventana de contexto y, a menudo, peor calidad para quien escribe en un idioma poco representado. El Día 17 lo incluye en el mapa de riesgos del Cuaderno Vivo.
Embeddings: palabras y notas como vectores
Partir el texto en tokens resuelve la pregunta de “en qué unidades leer”. Queda otra: ¿cómo decide una máquina que dos textos hablan de lo mismo? Los modelos no comparan cadenas de letras; comparan vectores. Un embedding (vector de representación, término que se usa sin traducir en la literatura) es una lista de números que coloca un token, una palabra o un documento completo en un espacio geométrico, de modo que los textos parecidos queden cerca.
La intuición geométrica es la de un mapa. Si cada nota fuera un punto en un plano, las notas de música deberían quedar en una zona, las de estadística en otra y las de historia del arte en una tercera. Medir el parecido sería medir la cercanía entre puntos. Con dos dimensiones el mapa se dibuja en papel; los modelos reales usan cientos o miles de dimensiones, pero la idea es la misma.
La forma más sencilla de construir esos vectores es contar. TF-IDF (por sus siglas en inglés: “Term Frequency, Inverse Document Frequency”) asigna a cada palabra de cada nota un peso que crece con las veces que la palabra aparece en esa nota y decrece con el número de notas que la contienen. La versión que usa scikit-learn por defecto es:
$$ \text{tfidf}(t,d)=\text{tf}(t,d)\cdot\left(\ln\frac{1+n}{1+\text{df}(t)}+1\right) $$
La lógica detrás de esta fórmula es múltiple:
- $\text{tf}(t,d)$ es el número de veces que el término $t$ aparece en la nota $d$. Una palabra repetida en una nota probablemente dice algo de su tema.
- $\text{df}(t)$ es el número de notas que contienen $t$, y $n$ es el total de notas ($12$). El cociente $\frac{1+n}{1+\text{df}(t)}$ es grande para palabras raras y cercano a $1$ para palabras que están en todas partes.
- El logaritmo suaviza ese cociente y el $+1$ final evita que una palabra presente en todas las notas tenga peso cero. Los “unos” del numerador y del denominador evitan divisiones entre cero.
- En conclusión, TF-IDF premia las palabras que son frecuentes en una nota y raras en el resto: justo las que distinguen un tema de otro. Al final, scikit-learn divide cada vector entre su longitud para que todas las notas tengan norma $1$.
Las palabras como “la”, “de” o “que” aparecen en casi todas las notas y no aportan nada al tema. El siguiente bloque las elimina con una lista corta de palabras vacías escrita a mano, construye la matriz TF-IDF y calcula la similitud coseno entre cada par de notas:
# Vectores TF-IDF de las notas y similitud coseno en Python:
from sklearn.feature_extraction.text import TfidfVectorizer
from sklearn.metrics.pairwise import cosine_similarity

palabras_vacias = ['a', 'al', 'antes', 'cada', 'con', 'cómo', 'cuando', 'de', 'del', 'dos',
                   'el', 'en', 'es', 'esa', 'la', 'las', 'lo', 'los', 'más', 'no', 'para',
                   'por', 'que', 'se', 'sobre', 'sus', 'un', 'una', 'y', 'luego',
                   'puede', 'mismo', 'pero', 'sin']
vectorizador = TfidfVectorizer(stop_words = palabras_vacias, token_pattern = r'[a-záéíóúüñ]+')
matriz_tfidf = vectorizador.fit_transform(notas['texto'])
similitud = cosine_similarity(matriz_tfidf)
print('Dimensiones TF-IDF:', matriz_tfidf.shape)

pares = pd.DataFrame([{'nota_a': i + 1, 'nota_b': j + 1,
                       'tema_a': notas.loc[i, 'tema'], 'tema_b': notas.loc[j, 'tema'],
                       'coseno': round(similitud[i, j], 3)}
                      for i in range(12) for j in range(i + 1, 12)])
pares = pares.sort_values('coseno', ascending = False, kind = 'stable')
print(pd.concat([pares.head(4), pares.tail(4)]).to_string(index = False))
print('Pares con coseno exactamente 0:', (pares['coseno'] == 0).sum(), 'de', len(pares))
Dimensiones TF-IDF: (12, 106)
 nota_a  nota_b            tema_a      tema_b  coseno
      1       3       estadística estadística   0.234
     11      12            música      música   0.132
      1       2       estadística estadística   0.115
      4       6            python      python   0.084
      8      12 historia del arte      música   0.000
      9      10 historia del arte      música   0.000
      9      11 historia del arte      música   0.000
      9      12 historia del arte      música   0.000
Pares con coseno exactamente 0: 50 de 66
La matriz TF-IDF tiene $12$ filas (las notas) y $106$ columnas (las palabras distintas que quedan tras quitar las palabras vacías). Cada nota es, por tanto, un vector de $106$ números, casi todos cero. La Tabla 4 recoge los cuatro pares más parecidos y cuatro de los menos parecidos, tal como los imprime el código.
Tabla 4. Similitud coseno entre las cuatro notas más parecidas y cuatro de las más distintas.
| Nota A | Nota B | Tema A | Tema B | Coseno |
|---|---|---|---|---|
| 1 | 3 | estadística | estadística | 0.234 |
| 11 | 12 | música | música | 0.132 |
| 1 | 2 | estadística | estadística | 0.115 |
| 4 | 6 | python | python | 0.084 |
| 8 | 12 | historia del arte | música | 0.000 |
| 9 | 10 | historia del arte | música | 0.000 |
| 9 | 11 | historia del arte | música | 0.000 |
| 9 | 12 | historia del arte | música | 0.000 |
Los cuatro pares más parecidos son del mismo tema, lo cual es una buena señal. Las notas 1 y 3 comparten “media”, “muestra” y “valores”; las notas 11 y 12, “guitarra” y “tocar”; las notas 1 y 2, “datos” y “media”; y las notas 4 y 6, solo “python”. El resultado más llamativo, sin embargo, está en la última línea de la salida: $50$ de los $66$ pares tienen similitud exactamente cero. No comparten ni una sola palabra con contenido. Por eso el orden de las cuatro últimas filas de la tabla es arbitrario: hay $50$ empates.
Similitud coseno
La medida que se usó en el bloque anterior es la similitud coseno, el coseno del ángulo entre dos vectores:
$$ \cos(\mathbf{a},\mathbf{b})=\frac{\mathbf{a}\cdot\mathbf{b}}{\lVert\mathbf{a}\rVert,\lVert\mathbf{b}\rVert} $$
La lógica detrás de esta métrica es múltiple:
- El numerador $\mathbf{a}\cdot\mathbf{b}$ es el producto punto: multiplica los pesos de cada palabra en las dos notas y suma. Solo las palabras que aparecen en ambas notas contribuyen; si no comparten ninguna, el producto es cero.
- El denominador divide entre las longitudes de los dos vectores. Gracias a eso, una nota larga no parece “más parecida” a todo solo por tener más palabras: lo que importa es la dirección del vector, no su tamaño.
- Como los pesos de TF-IDF nunca son negativos, el coseno queda entre $0$ (nada en común) y $1$ (misma proporción de palabras). Con embeddings neuronales, que sí tienen componentes negativas, puede llegar a $-1$.
- En conclusión, la similitud coseno mide cuánto apuntan dos textos en la misma dirección del espacio de palabras. Como scikit-learn ya normalizó los vectores TF-IDF, aquí el coseno coincide con el producto punto.
El problema de los $50$ ceros se ve mejor en una imagen. El siguiente bloque dibuja la matriz de similitud completa como un mapa de calor, con las notas ordenadas por tema y líneas blancas que separan los cuatro bloques:
# Mapa de calor de la similitud coseno entre las 12 notas en Python:
etiquetas = [f"{i} {t}" for i, t in zip(notas['id'], notas['tema'])]
fig, ax = plt.subplots(figsize = (6.4, 5.4))
imagen = ax.imshow(similitud, cmap = 'Blues', vmin = 0, vmax = 0.2)
ax.set_xticks(range(12))
ax.set_yticks(range(12))
ax.set_xticklabels(etiquetas, rotation = 60, ha = 'right', fontsize = 8)
ax.set_yticklabels(etiquetas, fontsize = 8)
for borde in [2.5, 5.5, 8.5]:
    ax.axhline(borde, color = 'white', linewidth = 2)
    ax.axvline(borde, color = 'white', linewidth = 2)
fig.colorbar(imagen, ax = ax, label = 'Similitud coseno (escala recortada en 0.2)')
ax.set_title('¿Qué notas se parecen?', fontsize = 16)
plt.tight_layout()

# Los bloques de la diagonal agrupan notas del mismo tema:
plt.show()
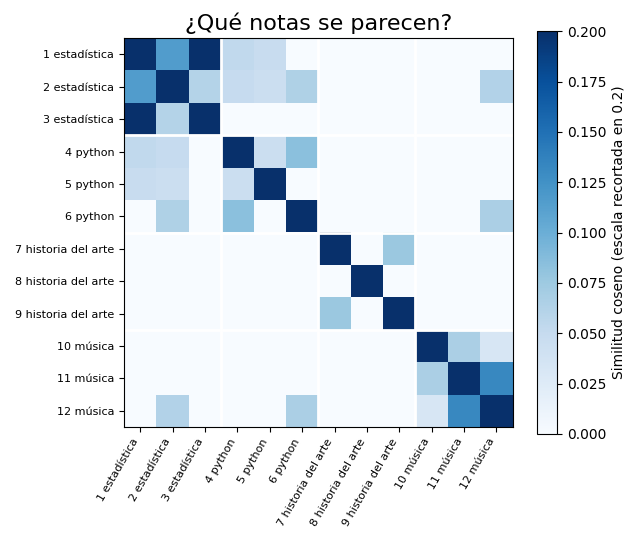
El gráfico anterior muestra cuatro bloques más oscuros sobre la diagonal: las notas de un mismo tema se parecen entre sí más que a las demás. La escala de color se recortó en $0.2$ para que se vean los parecidos débiles; de lo contrario, la diagonal (cada nota consigo misma, con coseno $1$) dominaría la imagen y el resto quedaría en blanco. Fuera de los bloques casi todo es blanco, y hay pocas excepciones: las notas 4 y 5 de Python tocan levemente a las de estadística porque comparten la palabra “datos”, y la nota 12 (metrónomo) toca a la 2 y a la 6 solo porque las tres usan el verbo “ayuda”. Dentro del bloque de historia del arte, la fila de la nota 8 (impresionismo) es blanca salvo la diagonal: no comparte ninguna palabra con contenido con ninguna otra nota.
Esta es la limitación de fondo de TF-IDF: solo ve coincidencias exactas de palabras. Para TF-IDF, “acorde” y “escala” son tan distintas como “acorde” y “media”, porque ocupan columnas distintas de la matriz y nada en el método relaciona una columna con otra. Las notas 10 y 11, que hablan de la escala mayor y de los acordes que se forman con ella, tienen un coseno de apenas $0.066$ aunque cualquier persona diría que tratan del mismo tema.
Un mapa de las notas de Sofía
Un vector de $140$ dimensiones no se puede dibujar. Para obtener un mapa en el plano se usa LSA (por sus siglas en inglés: “Latent Semantic Analysis”), que aplica una descomposición en valores singulares truncada a la matriz TF-IDF y se queda con las direcciones que más varianza explican. En scikit-learn se hace con TruncatedSVD, que trabaja directamente con matrices dispersas:
# Proyección LSA en dos dimensiones con TruncatedSVD en Python:
from sklearn.decomposition import TruncatedSVD

lsa = TruncatedSVD(n_components = 2, random_state = 2026)
coordenadas = lsa.fit_transform(matriz_tfidf)
print('Varianza explicada por componente:', lsa.explained_variance_ratio_.round(3))
print('Varianza explicada total:', round(lsa.explained_variance_ratio_.sum(), 3))

estilos = {'estadística': ('#2a78d6', 'o'), 'python': ('#eb6834', 's'),
           'historia del arte': ('#1baf7a', '^'), 'música': ('#6250d6', 'D')}
fig, ax = plt.subplots(figsize = (6.4, 4.8))
for tema, (color, marcador) in estilos.items():
    filtro = (notas['tema'] == tema).values
    ax.scatter(coordenadas[filtro, 0], coordenadas[filtro, 1], s = 70, color = color,
               marker = marcador, label = tema.capitalize(), edgecolor = 'white', linewidth = 1.5)
# Las notas 7, 8 y 9 caen en el mismo punto; sus etiquetas se separan a mano:
desplazamientos = {7: (6, 6), 8: (6, -12), 9: (-14, 6)}
for i, (x, y) in enumerate(coordenadas):
    ax.annotate(str(i + 1), (x, y), textcoords = 'offset points',
                xytext = desplazamientos.get(i + 1, (6, 4)), fontsize = 9)
ax.set_xlabel('Componente 1')
ax.set_ylabel('Componente 2')
ax.set_title('Mapa de las notas de Sofía (LSA)', fontsize = 16)
ax.legend(frameon = False, fontsize = 9)
ax.grid(alpha = 0.3)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()

# Cada punto es una nota; la cercanía aproxima el parecido de vocabulario:
plt.show()
Varianza explicada por componente: [0.061 0.089]
Varianza explicada total: 0.151
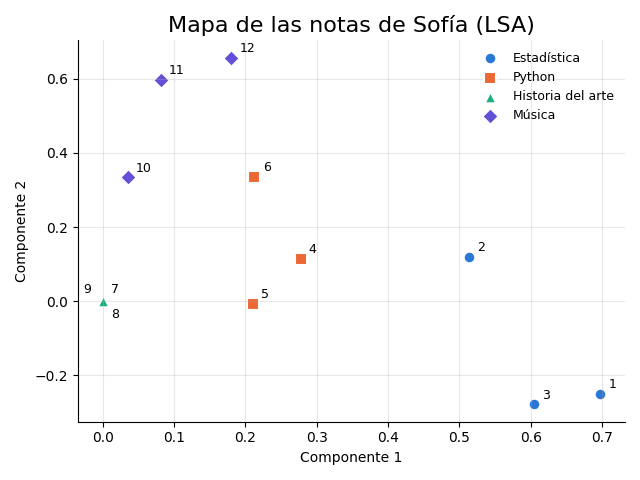
Los dos componentes explican solo el $15.1%$ de la varianza total ($6.1%$ el primero y $8.9%$ el segundo). Que el segundo explique más que el primero puede sorprender: ocurre porque TruncatedSVD no centra los datos, así que su primer componente capta sobre todo la dirección media de todas las notas y no la que más las separa. Es un comportamiento documentado de LSA, no un error.
Aun con tan poca varianza explicada, el gráfico anterior muestra una geografía razonable. Las notas de estadística (círculos) quedan a la derecha, las de Python (cuadrados) en el centro y las de música (rombos) arriba a la izquierda. El caso raro es el de historia del arte (triángulos): las tres notas caen exactamente en el mismo punto, el origen. Comparten tan poco vocabulario con el resto (la nota 8 no comparte nada) que los dos primeros componentes no tienen nada que decir de ellas; necesitarían un eje propio. Es una buena lección sobre las proyecciones: dos puntos juntos en el mapa no siempre son textos parecidos, a veces son textos que el mapa no sabe dónde poner.
Cada tema se dibuja con un color y una forma distintos, de modo que el gráfico se puede leer también en blanco y negro o con daltonismo. El número junto a cada punto es el id de la nota, igual que en la Tabla 4.
Vecinos más cercanos: un anticipo de la memoria
Con la matriz de similitud ya calculada, encontrar las notas más parecidas a una dada es ordenar una fila. El siguiente bloque define vecinos(id_nota, k = 3) y la prueba con tres notas. Después proyecta una pregunta nueva de Sofía con el mismo vectorizador para ver qué nota la responde mejor:
# Búsqueda de las notas más parecidas a una nota dada en Python:
def vecinos(id_nota, k = 3):
    # Ordena las demás notas por similitud coseno descendente:
    fila = similitud[id_nota - 1].copy()
    fila[id_nota - 1] = -1
    orden = np.argsort(-fila, kind = 'stable')[:k]
    return [(int(j + 1), notas.loc[j, 'tema'], round(float(fila[j]), 3)) for j in orden]

for id_nota in [1, 5, 10]:
    print(id_nota, '->', vecinos(id_nota))

# Dos consultas nuevas se proyectan con el mismo vectorizador:
for pregunta in ['¿cómo comparo la dispersión de dos grupos de datos?',
                 '¿qué tan alejados del promedio están mis valores?']:
    puntajes = cosine_similarity(vectorizador.transform([pregunta]), matriz_tfidf).ravel()
    mejores = np.argsort(-puntajes, kind = 'stable')[:3]
    print(pregunta, '->', [(int(j + 1), round(float(puntajes[j]), 3)) for j in mejores])
1 -> [(3, 'estadística', 0.234), (2, 'estadística', 0.115), (4, 'python', 0.052)]
5 -> [(1, 'estadística', 0.047), (4, 'python', 0.045), (2, 'estadística', 0.044)]
10 -> [(11, 'música', 0.066), (12, 'música', 0.032), (1, 'estadística', 0.0)]
¿cómo comparo la dispersión de dos grupos de datos? -> [(2, 0.506), (1, 0.101), (4, 0.097)]
¿qué tan alejados del promedio están mis valores? -> [(1, 0.294), (3, 0.285), (2, 0.0)]
Los vecinos de la nota 1 son las otras dos notas de estadística ($0.234$ y $0.115$) y, en tercer lugar, la nota 4 de Python ($0.052$), conectada por la palabra “datos”. El caso de la nota 5 (pandas) es revelador: su vecino más cercano no es una nota de Python, sino la nota 1 de estadística ($0.047$), apenas por delante de la nota 4 ($0.045$). TF-IDF no sabe que pandas es una biblioteca de Python; solo ve que la nota 5 habla de “datos”, igual que las de estadística. Para la nota 10, solo hay dos vecinos con algo en común (las otras notas de música, con cosenos de $0.066$ y $0.032$); el tercer “vecino” tiene similitud cero y aparece solo porque argsort necesita devolver tres posiciones.
Las dos consultas muestran la fuerza y el límite del método. La pregunta “¿cómo comparo la dispersión de dos grupos de datos?” encuentra la nota 2 con una similitud de $0.506$, la más alta de toda la entrada: comparte “dispersión”, “grupos” y “datos”, y las dos primeras son palabras raras que TF-IDF premia. Observe que “comparo” no coincide con “comparar”: para TF-IDF son palabras distintas. La segunda pregunta, “¿qué tan alejados del promedio están mis valores?”, es casi una paráfrasis de la nota 2 (“cuánto se alejan los datos de la media”), pero no comparte con ella ni una palabra: la nota 2 obtiene $0$ y el primer lugar se lo lleva la nota 1 ($0.294$) solo porque contiene “valores”.
Esta pequeña función es la semilla del sistema de recuperación del Día 7: cuando Sofía haga una pregunta, el Cuaderno Vivo buscará primero las notas más parecidas y solo enviará esas a Claude, en lugar de mandar todo el cuaderno en cada consulta.
Embeddings aprendidos frente a contados
TF-IDF y LSA son embeddings contados: salen de contar palabras y, en el caso de LSA, de una descomposición algebraica de esos conteos. Los modelos de lenguaje modernos usan embeddings aprendidos: cada token del vocabulario tiene asociada una fila de números (por ejemplo, de varios miles de dimensiones) que se ajusta durante el entrenamiento para que el modelo prediga bien el siguiente token.
El trabajo de Mikolov y colaboradores (2013) con word2vec popularizó la idea de que esos vectores aprendidos capturan relaciones de significado: palabras que aparecen en contextos parecidos acaban con vectores parecidos, aunque no compartan letras. En un espacio así, “acorde” y “escala” quedarían cerca porque ambas aparecen rodeadas de “guitarra”, “tocar” y “practicar”. Es precisamente lo que TF-IDF no pudo hacer con las notas 10 y 11, ni con la pregunta sobre los valores alejados del promedio.
Dentro de un transformador hay un paso más. La primera capa convierte cada token en su vector fijo, pero las capas siguientes lo modifican según el contexto: el vector de “banco” no es el mismo en “me senté en el banco del parque” que en “abrí una cuenta en el banco”. Esos son embeddings contextuales, y son la razón por la que un modelo grande entiende matices que ningún conteo de palabras captura.
La Tabla 3 resume las diferencias prácticas entre los tres enfoques.
Tabla 3. Comparativa entre TF-IDF, LSA y embeddings neuronales.
| Enfoque | Qué captura | Coste | Cuándo usarlo |
|---|---|---|---|
| TF-IDF | Coincidencias exactas de palabras, ponderadas por rareza | Casi nulo; corre en milisegundos en una computadora portátil | Búsqueda por palabras clave, corpus pequeños, línea base |
| LSA (TruncatedSVD) | Combinaciones de palabras que aparecen juntas (temas latentes) | Bajo; una descomposición de matriz | Mapas y agrupaciones exploratorias, reducción de dimensión |
| Embeddings neuronales | Significado: sinónimos, paráfrasis y contexto | Requiere un modelo entrenado, local o por API | Búsqueda semántica, recuperación para un asistente, textos variados |
Para el Cuaderno Vivo, con doce notas y un presupuesto de $10$ USD al mes, TF-IDF es un punto de partida excelente: es gratis, transparente (se puede ver qué palabras causan cada parecido) y suficiente para encontrar la nota de la desviación estándar cuando se pregunta por la dispersión. Su debilidad son las paráfrasis, como acaba de ver: la pregunta sobre los valores alejados del promedio no encontró la nota 2 porque no repetía ninguna de sus palabras. El Día 7 se topará de nuevo con esta limitación al construir la recuperación.
TF-IDF es la regla de medir del texto: imprecisa, pero siempre a mano y fácil de leer. Antes de pagar por algo más sofisticado, conviene saber qué tan lejos llega lo gratuito.
La ventana de contexto
Todo lo que un modelo de lenguaje “ve” en una petición (las instrucciones del sistema, el historial de la conversación, los documentos pegados y la propia pregunta) tiene que caber en su ventana de contexto, un límite medido en tokens. La respuesta que genera también se cuenta en tokens y tiene su propio tope. Pensar la ventana como un presupuesto ayuda: cada token ocupa espacio y cada token se paga.
La Tabla 5 recoge los datos de los tres modelos de Claude que usa la serie, según la documentación de octubre de 2026.
Tabla 5. Ventana de contexto y precios de los modelos de Claude de la serie (octubre de 2026).
| Modelo | ID | Ventana de contexto | Salida máxima | Entrada USD por millón | Salida USD por millón |
|---|---|---|---|---|---|
| Claude Fable 5.1 | claude-fable-5-1 | 1M tokens | 128K tokens | 10.00 | 50.00 |
| Claude Sonnet 5.5 | claude-sonnet-5-5 | 1M tokens | 128K tokens | 2.00 | 10.00 |
| Claude Haiku 5.5 | claude-haiku-5-5 | 1M tokens | 128K tokens | 0.10 | 0.50 |
Un millón de tokens es muchísimo: las $238$ palabras de las notas de Sofía ocupan una fracción mínima. Pero el tamaño de la ventana no es lo único que importa, por tres razones.
La primera es el coste. El precio de una petición crece linealmente con los tokens:
$$ C=\frac{T_{\text{entrada}}\cdot p_{\text{entrada}}+T_{\text{salida}}\cdot p_{\text{salida}}}{10^{6}} $$
La lógica detrás de esta fórmula es sencilla:
- $T_{\text{entrada}}$ y $T_{\text{salida}}$ son los tokens de entrada y de salida que informa la API en
usage. - $p_{\text{entrada}}$ y $p_{\text{salida}}$ son los precios por millón de la Tabla 5; se divide entre $10^{6}$ para pasar a dólares por token.
- La salida cuesta cinco veces más que la entrada en los tres modelos, así que pedir respuestas breves ahorra más que recortar el contexto.
- En conclusión, llenar la ventana “porque cabe” multiplica la factura. Mandar el cuaderno completo en cada una de las $600$ consultas mensuales del Cuaderno Vivo sería pagar una y otra vez por texto que la pregunta no necesita.
La segunda razón es la calidad. Liu y colaboradores (2024) mostraron el efecto conocido como “lost in the middle” (perdido en el medio): en sus experimentos, los modelos usaban mejor la información situada al principio o al final de un contexto largo que la situada en el centro. Los modelos han mejorado mucho desde entonces, pero la lección práctica se mantiene: más contexto no siempre es mejor, y poner lo relevante en un lugar visible ayuda. El Día 7 vuelve sobre esto al decidir dónde colocar las notas recuperadas.
La tercera razón es la latencia: procesar más tokens lleva más tiempo, y un asistente personal que tarda en responder se usa menos.
Por eso la función vecinos de la sección anterior importa tanto. En lugar de enviar $12$ notas (o, dentro de unos meses, $500$), el Cuaderno Vivo enviará solo las dos o tres más parecidas a la pregunta. Eso ahorra dinero y, al mismo tiempo, deja el contexto limpio para que el modelo se concentre en lo que importa.
Contar tokens con Claude
El BPE de juguete sirve para entender el mecanismo, pero sus cifras no valen para Claude. El tokenizador forma parte del modelo: cada familia de modelos tiene el suyo, y la única forma fiable de saber cuántos tokens ocupa un texto es preguntárselo al propio proveedor. La API de Claude ofrece para ello client.messages.count_tokens, que devuelve el conteo de entrada de una petición sin generar ninguna respuesta.
El siguiente bloque cuenta los tokens de las 12 notas, delimitadas con etiquetas <nota> (la técnica de delimitación que se estudia en el Día 5), junto con una instrucción de sistema breve. Este bloque llama a la API, así que necesita la variable de entorno ANTHROPIC_API_KEY y no se ejecutó al preparar la entrada; su salida es un ejemplo:
# Conteo de tokens de las 12 notas con la API de Claude en Python:
import anthropic

# El cliente lee la clave ANTHROPIC_API_KEY del entorno:
client = anthropic.Anthropic()

texto_notas = '\n'.join(f'<nota id="{i}">{t}</nota>' for i, t in zip(notas['id'], notas['texto']))
conteo = client.messages.count_tokens(
    model = 'claude-sonnet-5-5',
    system = 'Eres el tutor del Cuaderno Vivo. Responde en español y cita el id de cada nota.',
    messages = [{'role': 'user',
                 'content': f'Estas son mis notas:\n{texto_notas}\n\nHazme tres preguntas de repaso.'}]
)
print('input_tokens =', conteo.input_tokens)

# Coste de enviar ese contexto como entrada (2.00 USD por millón en Sonnet 5.5):
coste = conteo.input_tokens * 2.00 / 1_000_000
print(f'Coste de entrada: {coste:.6f} USD')
print(f'Fracción de la ventana de 1M tokens: {conteo.input_tokens / 1_000_000:.4%}')

# Salida de ejemplo (puede variar):
# input_tokens = 640
# Coste de entrada: 0.001280 USD
# Fracción de la ventana de 1M tokens: 0.0640%
Con la cifra de ejemplo de $640$ tokens (que es ilustrativa: la cifra real depende del tokenizador de Sonnet 5.5 y puede ser otra), enviar todo el cuaderno como entrada costaría unos $0.0013$ USD y ocuparía menos de una milésima parte de la ventana. Lo importante no es el número concreto, sino el método: cuente con el modelo que va a usar. La documentación de Claude advierte que los conteos dependen del modelo; por ejemplo, Claude Haiku 5.5 usa un tokenizador más reciente que cuenta el mismo texto con alrededor de un $30%$ más de tokens que su predecesor Haiku 4.5. Un conteo hecho con el tokenizador de otro proveedor, o con el de una versión anterior, puede equivocarse en la misma proporción.
Observe también que el bloque no envía temperature ni ningún otro parámetro de muestreo: count_tokens solo necesita el modelo, el sistema y los mensajes. Y que la clave nunca aparece en el código: el cliente la lee del entorno. Ambas costumbres se mantienen durante toda la serie.
Diego, por supuesto, encuentra la siguiente pregunta: “Si cuento tokens antes de cada envío, ¿no estoy haciendo dos llamadas en lugar de una?”. Es cierto, y por eso el conteo previo tiene más sentido para textos grandes o de tamaño desconocido (un PDF que Sofía importe, un historial largo) que para una pregunta de dos líneas. Para el uso diario, basta con leer usage.input_tokens en la respuesta, como se hizo en el Día 1, y guardar el dato en el registro de uso del Cuaderno Vivo.
Consideraciones finales
Esta entrada recorrió dos traducciones que ocurren antes de que un modelo “piense” nada: del texto a tokens y de los tokens a vectores. Ambas parecen detalles de implementación, pero deciden mucho de lo que el usuario experimenta. El tokenizador fija cuánto cuesta cada idioma y cuánto texto cabe en la ventana; la representación vectorial fija qué textos se consideran parecidos y, por tanto, qué recuerda un asistente cuando se le pregunta algo.
Antes de construir encima de estas piezas, conviene hacerse algunas preguntas de control:
- ¿Con qué textos se entrenó el tokenizador del modelo que usa, y cómo trata su idioma?
- ¿Sus conteos de tokens salen del propio proveedor o de una herramienta de otro modelo?
- ¿Su búsqueda de notas parecidas depende de que el usuario repita las mismas palabras?
- ¿Está enviando al modelo solo el contexto que la pregunta necesita?
Los números de esta entrada son de juguete y conviene leerlos como tales. El BPE aprendió de $238$ palabras, cuando un tokenizador real aprende de miles de millones; la razón de $1.81$ entre inglés y español es una propiedad de este corpus, no una medida de ningún producto. Lo que sí se traslada a los sistemas reales es la forma de los resultados: la recta del vocabulario frente a la curva decreciente de la longitud, el castigo al idioma que el tokenizador no conoce y la ceguera de TF-IDF ante las paráfrasis.
Un gran libro que habla de esto es Speech and Language Processing (sin traducción al español), en el que Daniel Jurafsky y James H. Martin dedican capítulos completos a la tokenización, a los vectores TF-IDF y a los embeddings aprendidos. Su tercera edición se publica como borrador gratuito en línea y es la mejor referencia para pasar de la intuición de esta entrada a las fórmulas completas.
El tokenizador no es una herramienta externa al modelo: es la puerta por la que entra todo lo que el modelo puede ver. Por eso los conteos no se trasladan entre proveedores, por eso un mismo texto cuesta distinto en distintos idiomas y por eso conviene contar con el modelo que se va a usar, no con el que se tiene a mano.
Conclusiones clave
Tokens
- Los modelos trabajan con subpalabras porque combinan un vocabulario fijo con la capacidad de escribir cualquier palabra, incluidas las que nunca vieron.
- BPE construye ese vocabulario fusionando, paso a paso, el par de símbolos más frecuente; en el corpus de juguete, la primera fusión fue “n” + “o” con frecuencia $14$.
- Cada fusión agranda el vocabulario en uno y acorta las secuencias cada vez menos: de $88.1$ a $64.6$ tokens por nota con $30$ fusiones.
- Un tokenizador favorece al idioma con el que se entrenó; con el BPE en español, el inglés costó $1.81$ veces más tokens.
Embeddings
- TF-IDF convierte cada nota en un vector que premia las palabras frecuentes en la nota y raras en el resto.
- La similitud coseno mide la dirección común de dos vectores; en las notas de Sofía, $50$ de $66$ pares dieron cero porque no compartían palabras.
- LSA proyecta las notas en un mapa de dos dimensiones que separa razonablemente los temas, aunque explique solo el $15.1%$ de la varianza.
- Los embeddings aprendidos capturan sinónimos y contexto, que es justo lo que los conteos no ven.
Contexto
- La ventana de contexto es un presupuesto de tokens: cabe mucho, pero cada token se paga y el exceso de contexto puede empeorar la respuesta.
- Los conteos de tokens dependen del modelo; la fuente de verdad para Claude es
client.messages.count_tokens. - Recuperar solo las notas relevantes, como hace la función
vecinos, ahorra dinero y deja el contexto limpio.
Mañana, en el Día 3: Cómo elige la siguiente palabra un modelo: softmax, temperatura y muestreo. Verá cómo un modelo convierte sus puntuaciones en probabilidades y por qué la misma pregunta puede dar respuestas distintas.
Referencias
- Sennrich, R., Haddow, B. y Birch, A. (2016). Neural Machine Translation of Rare Words with Subword Units. Proceedings of the 54th Annual Meeting of the Association for Computational Linguistics (ACL 2016). https://arxiv.org/abs/1508.07909
- Mikolov, T., Chen, K., Corrado, G. y Dean, J. (2013). Efficient Estimation of Word Representations in Vector Space. arXiv:1301.3781. https://arxiv.org/abs/1301.3781
- Petrov, A., La Malfa, E., Torr, P. H. S. y Bibi, A. (2023). Language Model Tokenizers Introduce Unfairness Between Languages. Advances in Neural Information Processing Systems 36 (NeurIPS 2023). https://arxiv.org/abs/2305.15425
- Liu, N. F., Lin, K., Hewitt, J., Paranjape, A., Bevilacqua, M., Petroni, F. y Liang, P. (2024). Lost in the Middle: How Language Models Use Long Contexts. Transactions of the Association for Computational Linguistics, 12. https://arxiv.org/abs/2307.03172
- Jurafsky, D. y Martin, J. H. (2025). Speech and Language Processing (3.ª ed., borrador en línea). https://web.stanford.edu/~jurafsky/slp3/