IA generativa en proyectos personales: Día 3
 Jeshua Romero Guadarrama
- 38 Min para leer
- 03 Jan, 2026
Índice de contenido
Resumen:
Un modelo de lenguaje no escribe frases completas: en cada paso calcula una puntuación para cada token posible, la convierte en probabilidades y elige uno. En esta entrada verá, con un vocabulario de juguete de cinco palabras, cómo la función softmax y la temperatura dan forma a esas probabilidades, cómo las estrategias voraz, top-k y top-p deciden qué token sale, y cómo se mide la diversidad con la entropía. Al terminar sabrá reproducir todo el proceso en numpy y qué controles ofrece hoy la API de Claude para regularlo.
¿Cómo citar el presente artículo?
Romero, J. (3 de enero de 2026). IA generativa en proyectos personales: Día 3. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_3/.
IA generativa en proyectos personales: Día 3 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_3/.
Modelos, precios y regulación revisados en octubre de 2026.
Día 3. Cómo elige la siguiente palabra un modelo: softmax, temperatura y muestreo
Introducción
Ayer, en el Día 2, vio cómo un texto se parte en tokens de subpalabra con BPE y cómo esos tokens y las notas se convierten en vectores, y el Cuaderno Vivo ganó un tokenizador propio. Ya sabe, por tanto, qué piezas maneja un modelo de lenguaje. Falta la pregunta central de este módulo: una vez que el modelo ha leído el contexto, ¿cómo decide cuál es el siguiente token?
La respuesta tiene dos mitades. La primera es determinista: la red neuronal produce un número real, llamado logit, para cada token del vocabulario. La segunda mitad es la que da a la IA generativa su carácter: esos logits se transforman en una distribución de probabilidad y de ella se elige un token, a veces el más probable y a veces uno sorteado. Ese momento de elección explica por qué la misma pregunta puede producir respuestas distintas, por qué un asistente puede sonar repetitivo o disperso y por qué existen controles como la temperatura.
En la presente entrada, descubrirá cómo pasar de logits a probabilidades con la función softmax, qué efecto tiene la temperatura sobre esas probabilidades y cómo medirlo con la entropía. Verá las cuatro estrategias de decodificación más usadas (voraz, top-k, top-p y muestreo puro), las comparará con una simulación de $1000$ muestras y echará un vistazo dentro del transformador para descubrir que la atención es, en el fondo, otro softmax. Por último, verá qué controles expone hoy la API de Claude y por qué la temperatura ya no es uno de ellos.
La pieza del Cuaderno Vivo que Sofía construye hoy es un muestreador: un pequeño módulo en numpy que recibe logits y devuelve un token según la estrategia elegida. Diego, como siempre, llega con una pregunta incómoda: “Si el modelo sortea las palabras, ¿cómo puede uno fiarse de un resumen de sus apuntes?”. Al final del día tendrá una respuesta con números.
Objetivos de aprendizaje
Al terminar esta entrada, usted será capaz de:
- Convertir logits en probabilidades con softmax y explicar el efecto de la temperatura.
- Comparar las estrategias de decodificación: voraz, top-k, top-p (núcleo) y muestreo puro.
- Medir la diversidad de una salida con la entropía.
- Entender, a grandes rasgos, la atención del transformador como un promedio ponderado.
- Saber qué controles expone hoy la API de Claude (esfuerzo) y cuáles no (temperatura).
De logits a probabilidades
Veamos un ejemplo puramente hipotético. Suponga que el Cuaderno Vivo acaba de leer el texto “Hoy abrí mi” y que su modelo, muy simplificado, solo conoce cinco palabras. Para cada una produce un logit: un número sin escala fija que indica cuánto “le gusta” esa palabra como continuación. Los valores son los de la Tabla 1, que se reutilizarán durante todo el día.
Tabla 1. Vocabulario de juguete del Cuaderno Vivo y sus logits.
| Posición | Token | Logit $z_i$ |
|---|---|---|
| 1 | cuaderno | 2.0 |
| 2 | vivo | 1.0 |
| 3 | idea | 0.5 |
| 4 | nota | 0.1 |
| 5 | dibujo | -1.0 |
Los logits tienen dos problemas si se quieren usar directamente para elegir. En primer lugar, pueden ser negativos (“dibujo” vale $-1.0$), y una probabilidad negativa no tiene sentido. En segundo lugar, no suman uno: la suma de la Tabla 1 es $2.6$, y si el modelo añadiera una constante a todos los logits la suma cambiaría sin que cambiara nada de lo que el modelo “piensa”. Hace falta una función que convierta cualquier vector de números reales en una distribución de probabilidad válida y que respete el orden: el token con más logit debe seguir siendo el más probable.
La función softmax
La función softmax cumple exactamente ese papel. Toma el vector de logits $z$, divide cada logit entre una temperatura $T$, aplica la exponencial y normaliza dividiendo entre la suma de todas las exponenciales:
$$ p_i = \frac{e^{z_i/T}}{\sum_{j} e^{z_j/T}} $$
La lógica detrás de esta fórmula es múltiple:
- La exponencial $e^{x}$ es siempre positiva, de modo que el problema de los logits negativos desaparece: $e^{-1} \approx 0.368$ es un número pequeño, pero positivo.
- La exponencial es creciente, así que el orden de los logits se conserva: si $z_i > z_j$, entonces $p_i > p_j$.
- Dividir entre la suma de todas las exponenciales obliga a que las probabilidades sumen uno, que es la condición para poder sortear con ellas.
- Solo importan las diferencias entre logits: el cociente entre dos probabilidades es $\frac{p_i}{p_j} = e^{(z_i - z_j)/T}$, por lo que sumar la misma constante a todos los logits no cambia el resultado.
- En conclusión, softmax es una forma suave de “elegir el máximo”: da más peso al logit mayor, pero deja algo de probabilidad a los demás.
La cuarta viñeta tiene una consecuencia práctica muy útil. Como restar una constante no cambia nada, se puede restar el logit máximo antes de calcular la exponencial. Así la exponencial más grande es $e^{0} = 1$ y nunca se produce un desbordamiento numérico, algo que sí ocurriría con logits de valor $1000$ (la exponencial de $1000$ no cabe en un número de coma flotante de 64 bits). A esta versión se la llama softmax numéricamente estable, y es la que usan todas las bibliotecas serias.
Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie, $2026$:
# Importaciones base y semilla global de la serie en Python:
import warnings
warnings.filterwarnings('ignore')
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

np.random.seed(2026)
rng = np.random.default_rng(2026)
print('numpy', np.__version__, '| pandas', pd.__version__)
numpy 2.4.6 | pandas 3.0.3
El bloque solo informa de las versiones con las que se ejecutó la entrada; si su versión de numpy es distinta, los números de los sorteos podrían variar ligeramente, pero las probabilidades calculadas serán idénticas. Ahora puede escribir la función softmax estable y calcular las probabilidades de la Tabla 1 con cuatro temperaturas distintas, usando el siguiente código:
# Softmax numéricamente estable con temperatura en Python:
def softmax(z, T = 1.0):
    z = np.asarray(z, dtype = float) / T
    z = z - z.max()
    e = np.exp(z)
    return e / e.sum()

tokens = ['cuaderno', 'vivo', 'idea', 'nota', 'dibujo']
logits = np.array([2.0, 1.0, 0.5, 0.1, -1.0])
temperaturas = [0.2, 0.5, 1, 2]

# Tabla de probabilidades por temperatura:
tabla_t = pd.DataFrame({f'T = {T}': softmax(logits, T) for T in temperaturas}, index = tokens)
print(tabla_t.round(3))
print('Suma de cada columna:', tabla_t.sum().round(6).tolist())
          T = 0.2  T = 0.5  T = 1  T = 2
cuaderno    0.993    0.826  0.559  0.372
vivo        0.007    0.112  0.205  0.226
idea        0.001    0.041  0.125  0.176
nota        0.000    0.018  0.084  0.144
dibujo      0.000    0.002  0.028  0.083
Suma de cada columna: [1.0, 1.0, 1.0, 1.0]
Con la temperatura neutra $T = 1$, “cuaderno” recibe una probabilidad de $0.559$, algo más de la mitad, y “dibujo” apenas $0.028$. Puede comprobar la propiedad del cociente con estas cifras: la diferencia de logits entre “cuaderno” y “dibujo” es $3$, y $\frac{0.559}{0.028} \approx 20$, que coincide con $e^{3} \approx 20.09$. La última línea confirma que cada columna suma exactamente uno, como debe ocurrir con cualquier distribución de probabilidad.
Softmax no inventa información: solo reescala los logits. Toda la “opinión” del modelo está en los logits; softmax los traduce a un lenguaje (el de la probabilidad) con el que se puede sortear. Por eso, cuando alguien dice que “el modelo eligió” una palabra, conviene separar dos momentos: el cálculo de los logits, que es determinista, y la elección, que puede no serlo.
La temperatura
La tabla anterior ya muestra el efecto de la temperatura, pero merece una sección propia porque es el control más conocido de la IA generativa. La temperatura $T$ divide los logits antes de la exponencial. Si $T < 1$, las diferencias entre logits se agrandan; si $T > 1$, se encogen. Como softmax solo depende de las diferencias, la temperatura decide cuán “picuda” o cuán “plana” es la distribución, como se resume en la Tabla 2.
Tabla 2. Probabilidades de los cinco tokens para cuatro temperaturas (salida del bloque anterior, redondeada a tres decimales).
| Token | T = 0.2 | T = 0.5 | T = 1 | T = 2 |
|---|---|---|---|---|
| cuaderno | 0.993 | 0.826 | 0.559 | 0.372 |
| vivo | 0.007 | 0.112 | 0.205 | 0.226 |
| idea | 0.001 | 0.041 | 0.125 | 0.176 |
| nota | 0.000 | 0.018 | 0.084 | 0.144 |
| dibujo | 0.000 | 0.002 | 0.028 | 0.083 |
A $T = 0.2$ el modelo es casi determinista: “cuaderno” se lleva el $99.3%$ de la probabilidad y los demás tokens quedan prácticamente fuera. A $T = 2$ la distribución se aplana: “cuaderno” baja al $37.2%$ y “dibujo”, que antes era casi imposible, sube al $8.3%$. Dicho con la fórmula del cociente, a $T = 2$ la ventaja de “cuaderno” sobre “dibujo” es $e^{3/2} \approx 4.48$ veces, frente a las $20$ veces de $T = 1$ y las $e^{15}$ (más de tres millones) de $T = 0.2$.
Los dos extremos ayudan a fijar la intuición:
- Cuando $T \to 0$, el logit mayor domina por completo y softmax se convierte en “elegir el máximo”. Es la estrategia voraz que verá más adelante.
- Cuando $T \to \infty$, todos los logits divididos entre $T$ se acercan a cero y la distribución tiende a la uniforme: cada token tendría probabilidad $\frac{1}{5} = 0.2$.
- Entre ambos extremos, la temperatura es un dial continuo entre previsibilidad y variedad.
Una gráfica de barras agrupadas permite ver las cuatro distribuciones a la vez. Puede generarla con el siguiente código:
# Barras agrupadas de la distribución softmax por temperatura en Python:
colores = ['#9ec5f4', '#5a9ee8', '#2a78d6', '#164c8c']
fig, ax = plt.subplots(figsize = (6.4, 4.8))
ancho = 0.2
posiciones = np.arange(len(tokens))
for i, T in enumerate(temperaturas):
    ax.bar(posiciones + (i - 1.5) * ancho, tabla_t[f'T = {T}'], width = ancho * 0.9,
           color = colores[i], label = f'T = {T}')
ax.set_xticks(posiciones)
ax.set_xticklabels(tokens)
ax.set_ylabel('Probabilidad')
ax.set_title('Softmax a distintas temperaturas', fontsize = 16)
ax.legend(title = 'Temperatura', frameon = False)
ax.spines[['top', 'right']].set_visible(False)
ax.grid(axis = 'y', alpha = 0.3)
plt.tight_layout()

# Cuanto menor es T, más se concentra la probabilidad en "cuaderno":
plt.show()
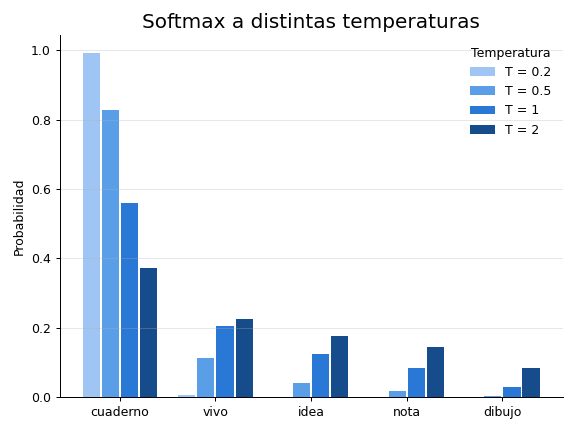
El gráfico anterior muestra la misma historia que la Tabla 2, pero de un vistazo. En “cuaderno” las barras bajan de izquierda a derecha (de la temperatura más fría a la más caliente), mientras que en los otros cuatro tokens suben. Observe que el orden de los tokens nunca cambia: la temperatura no puede convertir a “dibujo” en el favorito, solo puede acercarlo o alejarlo de “cuaderno”. La temperatura cambia cuánto confía el modelo en su favorito, no cuál es su favorito.
Sofía hace aquí su primera decisión de diseño. Para resumir apuntes de estadística, quiere que el Cuaderno Vivo diga casi siempre lo mismo ante la misma nota, así que le conviene una distribución picuda. Para su diario creativo, donde busca títulos sugerentes para sus dibujos, prefiere una distribución más plana. Diego le pregunta: “¿Y cómo se sabe si una distribución es picuda o plana sin mirar la gráfica?”. La respuesta es la entropía.
Entropía como medida de diversidad
La entropía de Shannon mide, en bits, cuánta incertidumbre hay en una distribución. Se calcula sumando, para cada token, su probabilidad por el logaritmo en base dos de esa probabilidad, y cambiando el signo:
$$ H = -\sum_{i} p_i \log_2 p_i $$
La lógica detrás de esta medida es múltiple:
- El término $-\log_2 p_i$ es la “sorpresa” de ver el token $i$: un token seguro ($p_i = 1$) no sorprende nada ($-\log_2 1 = 0$) y uno raro sorprende mucho.
- Multiplicar por $p_i$ y sumar es tomar el promedio de esa sorpresa, ponderado por la frecuencia con que cada token aparecería.
- El signo menos compensa que los logaritmos de números entre cero y uno son negativos, de modo que $H \geq 0$.
- La entropía es máxima cuando todos los tokens son igual de probables, y vale entonces $\log_2 n$; con cinco tokens, $\log_2 5 \approx 2.322$ bits.
- En conclusión, la entropía resume en un solo número cuántos tokens “compiten de verdad”: una entropía de $H$ bits equivale, a grandes rasgos, a elegir con igual probabilidad entre $2^{H}$ opciones.
Este último punto es la lectura más práctica. Una entropía de $1$ bit equivale a lanzar una moneda entre dos tokens; una de $2$ bits, a elegir entre cuatro. Recuerde además la perplejidad que vio en el Día 1: es exactamente $2^{H}$, el número efectivo de opciones, aplicado a un texto completo.
Puede calcular la entropía de cada temperatura y dibujar su curva sobre un rango amplio con el siguiente código:
# Entropía en bits y su curva frente a la temperatura en Python:
def entropia(p):
    p = np.asarray(p, dtype = float)
    p = p[p > 0]
    return float(-(p * np.log2(p)).sum()) + 0.0

for T in temperaturas:
    print(f'T = {T}: H = {entropia(softmax(logits, T)):.3f} bits')
print(f'Máximo con 5 tokens: {np.log2(len(tokens)):.3f} bits')

rejilla_t = np.linspace(0.05, 5, 200)
curva_h = [entropia(softmax(logits, T)) for T in rejilla_t]
fig, ax = plt.subplots(figsize = (6.4, 4.8))
ax.plot(rejilla_t, curva_h, color = '#2a78d6', linewidth = 2, label = 'Entropía de la distribución')
ax.axhline(np.log2(len(tokens)), color = '#52514e', linestyle = '--', linewidth = 1.5,
           label = 'Máximo: $\\log_2 5$')
ax.axvline(1, color = '#9ec5f4', linewidth = 1)
ax.set_xlabel('Temperatura T')
ax.set_ylabel('Entropía (bits)')
ax.set_title('Entropía frente a temperatura', fontsize = 16)
ax.legend(frameon = False, loc = 'lower right')
ax.spines[['top', 'right']].set_visible(False)
ax.grid(alpha = 0.3)
plt.tight_layout()

# La entropía crece con T y se acerca al máximo sin alcanzarlo:
plt.show()
T = 0.2: H = 0.066 bits
T = 0.5: H = 0.895 bits
T = 1: H = 1.756 bits
T = 2: H = 2.156 bits
Máximo con 5 tokens: 2.322 bits
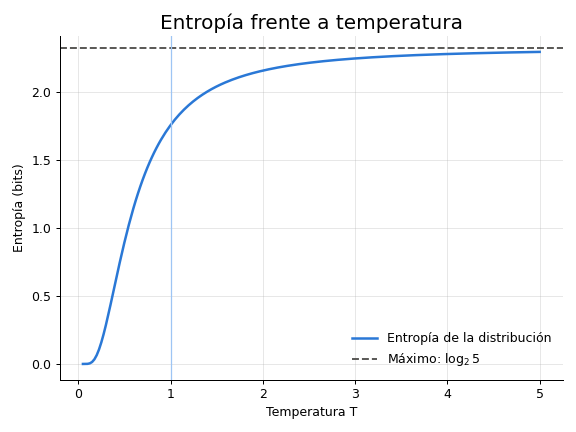
A la temperatura neutra la entropía es de $1.756$ bits, lo que equivale a elegir entre unas $2^{1.756} \approx 3.4$ opciones igual de probables. A $T = 0.2$ cae a $0.066$ bits, prácticamente cero: no hay elección real. A $T = 2$ sube a $2.156$ bits, ya muy cerca del techo de $2.322$ bits que marca la línea discontinua.
La curva tiene forma de “S” tumbada y enseña tres cosas. Primero, por debajo de $T \approx 0.2$ la entropía es casi nula, de modo que bajar más la temperatura no cambia nada. Segundo, la zona donde la temperatura más influye está entre $0.3$ y $1.5$, donde la curva es más empinada. Tercero, por encima de $T = 3$ la curva se aplana pegada al máximo, sin alcanzarlo nunca: el modelo se acerca al azar puro, pero conserva una mínima preferencia por “cuaderno”.
La entropía es el termómetro de la temperatura. Dos modelos con vocabularios y logits distintos no se pueden comparar por su valor de $T$, porque el mismo $T$ produce efectos distintos según lo separados que estén los logits; en cambio, la entropía de la distribución resultante sí es comparable. Por eso el Cuaderno Vivo registrará la entropía, y no solo la temperatura, cuando Sofía pruebe configuraciones.
Estrategias de decodificación
Hasta aquí tiene una distribución de probabilidad. Falta el segundo momento: elegir un token a partir de ella. A la regla que hace esa elección se le llama estrategia de decodificación, y la elección importa tanto como la temperatura. El trabajo de Holtzman y colaboradores de $2020$, que da nombre a una de las estrategias de esta sección, mostró que decodificar siempre lo más probable produce textos repetitivos y aburridos, mientras que sortear sin restricciones produce textos incoherentes, porque la “cola” de tokens poco probables acaba colándose.
Las cuatro estrategias que verá responden a la misma pregunta: ¿Cuánta de la distribución hay que tener en cuenta para elegir?
Voraz
La decodificación voraz (en inglés, greedy) elige siempre el token con mayor probabilidad: $\hat{w} = \arg\max_i p_i$. Es lo mismo que usar softmax con $T \to 0$. Con la Tabla 1 la respuesta es siempre “cuaderno”.
Tiene dos virtudes claras: es determinista (la misma entrada da siempre la misma salida) y es barata (no hay que sortear nada). Su defecto es igual de claro: como solo mira el mejor token de cada paso, tiende a caer en bucles. Si “el cuaderno” lleva a “de” y “de” lleva a “el cuaderno”, un modelo voraz puede escribir “el cuaderno de el cuaderno de el cuaderno…” sin salir nunca. Además, lo mejor en cada paso no garantiza la mejor frase completa: un primer token algo menos probable puede abrir una continuación mucho mejor. Verá un caso real de este bucle en la sección de generación autorregresiva.
Top-k
El muestreo top-k se queda con los $k$ tokens más probables, pone a cero la probabilidad del resto y vuelve a normalizar para que la suma sea uno. Si $V_k$ es el conjunto de los $k$ mejores tokens, la distribución truncada es:
$$ p_i^{(k)} = \begin{cases} \dfrac{p_i}{\sum_{j \in V_k} p_j} & \text{si } i \in V_k \\ 0 & \text{en otro caso} \end{cases} $$
La lógica detrás de esta regla es múltiple:
- Cortar la cola elimina los tokens muy improbables, que son los que con más frecuencia producen incoherencias.
- Renormalizar reparte la probabilidad eliminada entre los supervivientes en proporción a lo que ya tenían, así que el orden y los cocientes entre ellos se conservan.
- Con $k = 1$ se obtiene la estrategia voraz; con $k$ igual al tamaño del vocabulario, el muestreo puro.
- En conclusión, $k$ es un límite fijo al número de candidatos, sin importar cuánta probabilidad tengan.
Esa última frase es también su debilidad. Si el modelo está muy seguro (un token con $0.95$), un $k = 50$ deja entrar a $49$ tokens que no deberían estar; si el modelo duda entre muchos tokens parecidos, un $k = 2$ corta opciones perfectamente razonables. El número fijo no se adapta a la forma de la distribución.
Top-p o núcleo
El muestreo top-p, también llamado muestreo de núcleo (en inglés, nucleus sampling), corrige ese problema. En lugar de fijar cuántos tokens entran, fija cuánta probabilidad deben reunir. Se ordenan los tokens de mayor a menor probabilidad y se toma el menor conjunto cuya probabilidad acumulada alcance el umbral $p$:
$$ V_p = \text{el menor conjunto } V \text{ tal que } \sum_{i \in V} p_i \geq p $$
La lógica detrás de esta regla es múltiple:
- Cuando el modelo está seguro, el núcleo es pequeño: si un token ya reúne el $95%$, con $p = 0.9$ el núcleo es ese único token.
- Cuando el modelo duda, el núcleo crece solo y admite más candidatos.
- Igual que en top-k, la probabilidad de los tokens que quedan fuera se reparte entre los del núcleo al renormalizar.
- En conclusión, top-p adapta el número de candidatos a la confianza del modelo, que es justo lo que le faltaba a top-k.
Puede implementar las dos funciones de truncamiento y aplicarlas a la distribución de $T = 1$ con el siguiente código:
# Funciones de truncamiento top-k y top-p en Python:
def top_k(p, k):
    p = np.asarray(p, dtype = float)
    orden = np.argsort(p)[::-1]
    q = np.zeros_like(p)
    q[orden[:k]] = p[orden[:k]]
    return q / q.sum()

def top_p(p, umbral):
    p = np.asarray(p, dtype = float)
    orden = np.argsort(p)[::-1]
    acumulada = np.cumsum(p[orden])
    n = int(np.searchsorted(acumulada, umbral) + 1)
    q = np.zeros_like(p)
    q[orden[:n]] = p[orden[:n]]
    return q / q.sum()

p = softmax(logits, 1)
truncadas = pd.DataFrame({
    'original': p,
    'top-k (k = 2)': top_k(p, 2),
    'top-p (p = 0.9)': top_p(p, 0.9)
}, index = tokens)
print(truncadas.round(3))
print('Acumulada ordenada:', np.cumsum(np.sort(p)[::-1]).round(3).tolist())
          original  top-k (k = 2)  top-p (p = 0.9)
cuaderno     0.559          0.731            0.575
vivo         0.205          0.269            0.211
idea         0.125          0.000            0.128
nota         0.084          0.000            0.086
dibujo       0.028          0.000            0.000
Acumulada ordenada: [0.559, 0.764, 0.889, 0.972, 1.0]
Con $k = 2$ sobreviven “cuaderno” y “vivo”, que juntos sumaban $0.764$; al dividir entre esa suma, “cuaderno” sube a $0.731$ y “vivo” a $0.269$. Con $p = 0.9$ la lista acumulada explica el resultado: tras tres tokens la suma es $0.889$, todavía por debajo de $0.9$, así que hace falta un cuarto token (“nota”) y la acumulada llega a $0.972$. Solo “dibujo” queda fuera, y los cuatro supervivientes se dividen entre $0.972$: “cuaderno” pasa de $0.559$ a $0.575$.
Observe la diferencia de filosofía. Top-k con $k = 2$ ha sido muy agresivo y ha eliminado el $23.6%$ de la probabilidad original; top-p con $p = 0.9$ ha eliminado solo el $2.8%$. Ninguna de las dos es “la correcta”: dependen de cuánto riesgo de incoherencia esté dispuesto a asumir a cambio de variedad.
Una figura con la probabilidad acumulada ordenada hace visibles los dos cortes. Puede generarla con el siguiente código:
# Probabilidad acumulada con los cortes de top-k y top-p en Python:
orden = np.argsort(p)[::-1]
acumulada = np.cumsum(p[orden])
etiquetas = [tokens[i] for i in orden]
fig, ax = plt.subplots(figsize = (6.4, 4.8))
ax.axvspan(-0.5, 1.5, color = '#eb6834', alpha = 0.15, label = 'Conjunto top-k (k = 2)')
ax.axvspan(1.5, 3.5, color = '#2a78d6', alpha = 0.10, label = 'Resto del núcleo top-p (p = 0.9)')
ax.bar(range(len(p)), p[orden], color = '#2a78d6', width = 0.6, label = 'Probabilidad del token')
ax.plot(range(len(p)), acumulada, color = '#164c8c', marker = 'o', markersize = 8,
        linewidth = 2, label = 'Probabilidad acumulada')
ax.axhline(0.9, color = '#52514e', linestyle = '--', linewidth = 1.5)
ax.text(4.4, 0.92, 'p = 0.9', ha = 'right', color = '#52514e')
ax.set_xticks(range(len(p)))
ax.set_xticklabels(etiquetas)
ax.set_ylim(0, 1.25)
ax.set_ylabel('Probabilidad')
ax.set_title('Cortes de top-k y top-p a T = 1', fontsize = 16)
ax.legend(frameon = False, loc = 'upper left', fontsize = 9, ncol = 2)
ax.spines[['top', 'right']].set_visible(False)
plt.tight_layout()

# El núcleo deja fuera solo a "dibujo"; top-k se queda con dos tokens:
plt.show()
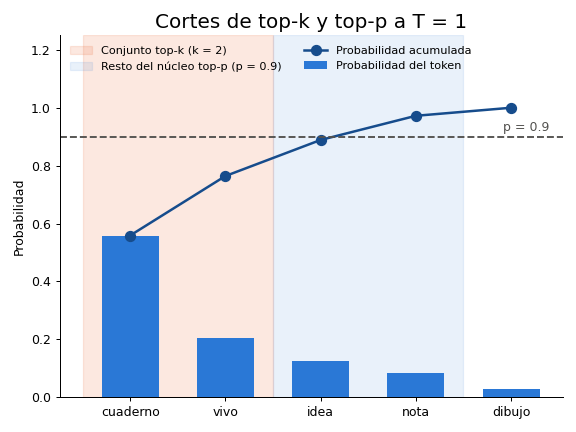
En el gráfico, las barras son las probabilidades ordenadas y la línea con marcadores, su suma acumulada. La franja naranja marca los dos tokens de top-k y la franja azul, los dos que top-p añade. La línea discontinua en $0.9$ muestra el criterio del núcleo: la curva acumulada la cruza entre “idea” ($0.889$) y “nota” ($0.972$), y por eso “nota” entra y “dibujo” no. Es una forma rápida de leer cualquier distribución: cuanto antes cruce la curva el umbral, más seguro está el modelo y más pequeño será el núcleo.
Atención aquí: Top-k y top-p se aplican después de la temperatura, y ambos interactúan. Con una temperatura alta la distribución se aplana, la curva acumulada sube más despacio y el núcleo top-p crece; con una temperatura baja ocurre lo contrario. Si cambia la temperatura y deja fijo $p$, cambia también el número de candidatos. Al comparar configuraciones, mueva un solo control cada vez y registre la entropía resultante; de lo contrario no sabrá cuál de los dos produjo el efecto.
Comparativa empírica
Las fórmulas dicen qué debería pasar; una simulación muestra qué pasa de verdad. Sofía sortea $1000$ tokens con cada estrategia a partir de la distribución de $T = 1$ y cuenta cuántas veces sale cada uno. También calcula la entropía teórica de cada distribución y la entropía empírica de las frecuencias observadas. Puede hacerlo con el siguiente código:
# Simulación de 1 000 muestras por estrategia de decodificación en Python:
n_muestras = 1000
estrategias = {
    'voraz': np.eye(len(tokens))[np.argmax(p)],
    'top-k (k = 2)': top_k(p, 2),
    'top-p (p = 0.9)': top_p(p, 0.9),
    'muestreo puro': p
}
frecuencias = {}
for nombre, distribucion in estrategias.items():
    muestras = rng.choice(len(tokens), size = n_muestras, p = distribucion)
    frecuencias[nombre] = np.bincount(muestras, minlength = len(tokens))
frecuencias = pd.DataFrame(frecuencias, index = tokens)
print(frecuencias)

# Entropía teórica, entropía empírica y tokens distintos por estrategia:
for nombre in frecuencias.columns:
    f = frecuencias[nombre] / n_muestras
    print(f'{nombre}: teórica = {entropia(estrategias[nombre]):.3f} bits, '
          f'empírica = {entropia(f):.3f} bits, distintos = {(frecuencias[nombre] > 0).sum()}')
          voraz  top-k (k = 2)  top-p (p = 0.9)  muestreo puro
cuaderno   1000            744              587            571
vivo          0            256              211            204
idea          0              0              112            115
nota          0              0               90             77
dibujo        0              0                0             33
voraz: teórica = 0.000 bits, empírica = 0.000 bits, distintos = 1
top-k (k = 2): teórica = 0.840 bits, empírica = 0.821 bits, distintos = 2
top-p (p = 0.9): teórica = 1.617 bits, empírica = 1.591 bits, distintos = 4
muestreo puro: teórica = 1.756 bits, empírica = 1.736 bits, distintos = 5
Los resultados se ordenan en la Tabla 3.
Tabla 3. Frecuencias observadas en $1000$ muestras por estrategia, con la entropía teórica y la empírica.
| Token | Voraz | Top-k (k = 2) | Top-p (p = 0.9) | Muestreo puro |
|---|---|---|---|---|
| cuaderno | 1000 | 744 | 587 | 571 |
| vivo | 0 | 256 | 211 | 204 |
| idea | 0 | 0 | 112 | 115 |
| nota | 0 | 0 | 90 | 77 |
| dibujo | 0 | 0 | 0 | 33 |
| Entropía teórica (bits) | 0.000 | 0.840 | 1.617 | 1.756 |
| Entropía empírica (bits) | 0.000 | 0.821 | 1.591 | 1.736 |
| Tokens distintos | 1 | 2 | 4 | 5 |
Si sigue el ejemplo, puede contrastar cada columna con su probabilidad teórica. En top-k se esperaban unos $731$ “cuaderno” y salieron $744$; en top-p se esperaban $575$ y salieron $587$; en muestreo puro se esperaban $559$ y salieron $571$. Las diferencias, de unos doce sorteos, están dentro de lo normal: la desviación típica de un conteo binomial con $n = 1000$ y $p \approx 0.56$ es $\sqrt{1000 \cdot 0.56 \cdot 0.44} \approx 15.7$, de modo que un desvío de $12$ es menor que una desviación típica.
La comparación deja varias conclusiones:
- En primer lugar, la diversidad crece de izquierda a derecha: $1$, $2$, $4$ y $5$ tokens distintos, con entropías de $0$, $0.82$, $1.59$ y $1.74$ bits.
- En segundo lugar, top-p con $p = 0.9$ se parece mucho al muestreo puro (las columnas son casi iguales), pero elimina “dibujo”, que salió $33$ veces en el muestreo puro. En un texto de $1000$ tokens, eso son $33$ ocasiones de colar una palabra poco plausible.
- En tercer lugar, la entropía empírica es siempre un poco menor que la teórica. No es casualidad: estimar la entropía a partir de frecuencias de una muestra finita tiende a subestimarla, porque los tokens raros aparecen menos de lo que deberían.
Elegir una estrategia es elegir cuánta cola de la distribución está dispuesto a aceptar. Para el resumen de apuntes, Sofía se inclina por voraz o por un núcleo pequeño; para los títulos creativos, por top-p con $p$ alto.
Un vistazo dentro: la atención
Hasta ahora los logits eran un dato. Pero, ¿de dónde salen? En un transformador, cada token del contexto se convierte en un vector y pasa por varias capas. La operación central de cada capa es la atención, y lo interesante para este día es que la atención usa la misma función softmax que acaba de estudiar, solo que no para elegir palabras, sino para decidir a qué palabras del contexto mirar.
Cada token produce tres vectores: una consulta ($Q$, lo que busca), una clave ($K$, lo que ofrece para ser encontrado) y un valor ($V$, la información que aporta si se le elige). La atención de producto escalar escalado, propuesta por Vaswani y colaboradores en $2017$, se escribe así:
$$ \text{Atención}(Q,K,V) = \text{softmax}\left(\frac{QK^\top}{\sqrt{d_k}}\right)V $$
La lógica detrás de esta fórmula es múltiple:
- El producto $QK^\top$ compara cada consulta con cada clave mediante un producto escalar: cuanto más alineados estén los dos vectores, mayor es la puntuación.
- Dividir entre $\sqrt{d_k}$, donde $d_k$ es la dimensión de las claves, evita que las puntuaciones crezcan con la dimensión. Actúa como una temperatura fija: sin ella, en dimensiones grandes softmax se volvería casi voraz y la red aprendería mal.
- Softmax, aplicado fila a fila, convierte las puntuaciones de cada token en pesos positivos que suman uno.
- Multiplicar por $V$ calcula, para cada token, un promedio ponderado de los valores de todos los tokens, con esos pesos.
- En conclusión, cada token sale de la capa como una mezcla de la información de su contexto, en la que pesan más los tokens que mejor responden a su consulta.
Veamos un ejemplo con la frase “el cuaderno está vivo”: cuatro tokens y vectores de dimensión $d_k = 2$, con matrices $Q$, $K$ y $V$ fijadas a mano para que se puedan seguir las cuentas. En un modelo real esas matrices se obtienen multiplicando los embeddings del Día 2 por pesos aprendidos y tienen cientos o miles de dimensiones. Puede calcular la atención y dibujar sus pesos con el siguiente código:
# Atención de producto escalar con matrices de juguete en Python:
palabras = ['el', 'cuaderno', 'está', 'vivo']
Q = np.array([[0.0, 1.0], [1.0, 0.5], [0.5, 1.0], [1.5, 0.0]])
K = np.array([[0.0, 0.5], [1.0, 1.0], [0.5, 0.0], [1.5, 0.5]])
V = np.array([[0.1, 0.0], [1.0, 0.2], [0.3, 0.9], [0.8, 1.0]])
d_k = K.shape[1]
puntuaciones = Q @ K.T / np.sqrt(d_k)
pesos = np.apply_along_axis(softmax, 1, puntuaciones)
salida = pesos @ V
print(pd.DataFrame(pesos, index = palabras, columns = palabras).round(3))
print(pd.DataFrame(salida, index = palabras, columns = ['dim_1', 'dim_2']).round(3))

fig, ax = plt.subplots(figsize = (6.4, 4.8))
imagen = ax.imshow(pesos, cmap = 'Blues', vmin = 0, vmax = pesos.max())
for i in range(len(palabras)):
    for j in range(len(palabras)):
        ax.text(j, i, f'{pesos[i, j]:.2f}', ha = 'center', va = 'center',
                color = 'white' if pesos[i, j] > 0.3 else '#0b0b0b')
ax.set_xticks(range(len(palabras)))
ax.set_xticklabels(palabras)
ax.set_yticks(range(len(palabras)))
ax.set_yticklabels(palabras)
ax.set_xlabel('Clave (token al que se atiende)')
ax.set_ylabel('Consulta (token que atiende)')
ax.set_title('Pesos de atención', fontsize = 16)
fig.colorbar(imagen, ax = ax, label = 'Peso')
plt.tight_layout()

# Cada fila es una distribución softmax que suma 1:
plt.show()
             el  cuaderno   está   vivo
el        0.242     0.345  0.170  0.242
cuaderno  0.133     0.323  0.159  0.385
está      0.180     0.364  0.151  0.305
vivo      0.095     0.275  0.162  0.468
          dim_1  dim_2
el        0.614  0.465
cuaderno  0.692  0.593
está      0.672  0.514
vivo      0.707  0.668
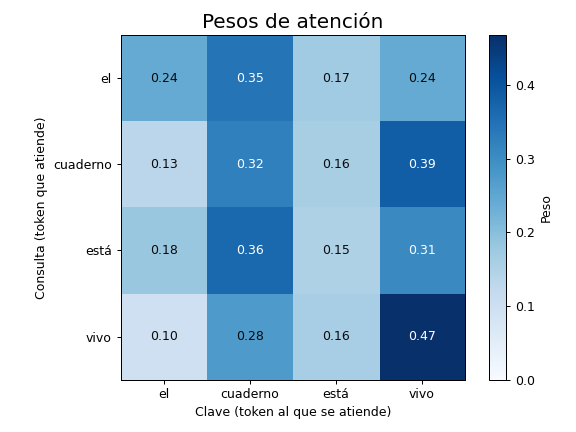
Cada fila de la primera tabla es una distribución softmax: los pesos con que ese token “mira” a los demás. La fila de “vivo” es la más concentrada, con un peso de $0.468$ sobre sí mismo. Puede reproducir la puntuación a mano: la consulta de “vivo” es $(1.5, 0)$ y su propia clave es $(1.5, 0.5)$, de modo que el producto escalar vale $1.5 \cdot 1.5 + 0 \cdot 0.5 = 2.25$ y, dividido entre $\sqrt{2}$, da $1.591$, la puntuación más alta de toda la matriz. La fila de “el”, en cambio, está mucho más repartida: su peso mayor es $0.345$, sobre “cuaderno”.
La segunda tabla es la salida de la capa: cada token se ha convertido en un promedio ponderado de los valores. Por ejemplo, la nueva representación de “cuaderno” es $(0.692, 0.593)$, que mezcla sobre todo los valores de “vivo” ($0.385$) y de sí mismo ($0.323$). En el mapa de calor, las columnas oscuras de “cuaderno” y “vivo” muestran que esos dos tokens concentran la atención de toda la frase, lo cual es razonable en este ejemplo inventado: son las dos palabras con contenido.
Conviene no sobreinterpretar este ejemplo. Un transformador real tiene decenas de capas, cada una con varias “cabezas” de atención en paralelo, y los pesos no siempre se dejan leer como “esta palabra se fija en aquella”. Lo que sí debe retener es la idea: la atención es un promedio ponderado cuyos pesos salen de un softmax, y al final de todas las capas otro softmax, el de la sección anterior, convierte la representación del último token en las probabilidades del siguiente.
Generación autorregresiva
Ya tiene todas las piezas para entender cómo se escribe un texto completo. Un modelo de lenguaje genera de forma autorregresiva: predice una distribución para el siguiente token, elige uno, lo añade al contexto y repite. La probabilidad de una frase entera se descompone, por la regla de la cadena, en el producto de las probabilidades de cada paso:
$$ P(w_1, w_2, \ldots, w_n) = \prod_{t=1}^{n} P(w_t \mid w_1, \ldots, w_{t-1}) $$
La lógica detrás de esta descomposición es múltiple:
- Cada factor es una distribución sobre el vocabulario, como la de la Tabla 1, pero condicionada a todo lo escrito hasta ese momento.
- El modelo de bigramas del Día 1 es el caso más simple: solo mira la palabra anterior, $P(w_t \mid w_{t-1})$, en lugar de todo el contexto.
- Un transformador usa la atención para condicionar en todos los tokens anteriores, hasta llenar la ventana de contexto que vio en el Día 2.
- En conclusión, generar texto es repetir el bucle “predecir, muestrear, añadir”, y cada vuelta pasa por softmax, temperatura y una estrategia de decodificación.
Para verlo funcionar, Sofía reconstruye el modelo de bigramas del Día 1 con sus 12 notas de estudio y le aplica temperatura. El truco es convertir los conteos de bigramas en logits tomando su logaritmo: así, con $T = 1$, softmax devuelve exactamente las frecuencias relativas del Día 1, y con otras temperaturas las afila o las aplana. Puede ejecutar el bucle con temperaturas $0.5$ y $1.5$ usando el siguiente código:
# Generación autorregresiva con el modelo de bigramas del Día 1 en Python:
import re
from collections import Counter, defaultdict

notas = [
    'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.',
    'La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos.',
    'Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra.',
    'En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos.',
    'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.',
    'Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código.',
    'El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura.',
    'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.',
    'El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro.',
    'Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra.',
    'Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones.',
    'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.',
]

def tokenizar(texto):
    # Minúsculas, solo palabras y marcas de inicio y fin de frase:
    return ['<s>'] + re.findall(r'\w+', texto.lower()) + ['</s>']

siguientes = defaultdict(Counter)
for nota in notas:
    frase = tokenizar(nota)
    for anterior, siguiente in zip(frase[:-1], frase[1:]):
        siguientes[anterior][siguiente] += 1

def generar(T, generador, maximo = 15):
    # Predecir, muestrear y añadir hasta "</s>" o el máximo de palabras:
    actual, generadas = '<s>', []
    while len(generadas) < maximo:
        candidatas = list(siguientes[actual])
        conteos = np.array([siguientes[actual][c] for c in candidatas], dtype = float)
        probabilidades = softmax(np.log(conteos), T)
        actual = candidatas[generador.choice(len(candidatas), p = probabilidades)]
        if actual == '</s>':
            break
        generadas.append(actual)
    return ' '.join(generadas)

print('Siguientes de "la":', siguientes['la'].most_common(4))
generador = np.random.default_rng(2026)
for T in [0.5, 1.5]:
    for i in range(2):
        print(f'T = {T}, frase {i + 1}: {generar(T, generador)}')
Siguientes de "la": [('media', 3), ('guitarra', 3), ('perspectiva', 2), ('muestra', 1)]
T = 0.5, frase 1: un objeto desde varios puntos de valores extremos de la guitarra cada día con un
T = 0.5, frase 2: el mismo cuadro
T = 1.5, frase 1: un archivo csv y ayuda a partir de confianza da un intervalo de una función
T = 1.5, frase 2: en varias posiciones
La primera línea muestra la distribución de la que se sortea después de “la”: “media” y “guitarra” aparecen $3$ veces cada una, “perspectiva” $2$ y “muestra” $1$, entre otras. Con $T = 0.5$ los logits $\log 3$ y $\log 2$ se duplican, lo que equivale a elevar los conteos al cuadrado ($9$ frente a $4$): los favoritos se refuerzan. Con $T = 1.5$ los conteos se elevan a $\frac{2}{3}$ y las opciones raras ganan terreno.
Las frases generadas hay que leerlas con cuidado, porque dos frases por temperatura son muy pocas para sacar conclusiones estadísticas. Aun así, ilustran el mecanismo:
- Con $T = 0.5$, la primera frase recorre caminos muy transitados del corpus (“puntos de”, “de la”, “la guitarra”, “con un”) y llega al tope de $15$ palabras sin cerrar la idea. Es el síntoma típico de una temperatura baja: frases fluidas a trozos que se encadenan por las transiciones más frecuentes.
- Con $T = 1.5$, la primera frase salta de las notas de Python (“un archivo csv”) a las de estadística (“intervalo de confianza”) a través de la palabra “y” y de la preposición “de”. Hay más variedad, pero también más incoherencia.
- En ambas temperaturas aparecen frases cortas (“el mismo cuadro”, “en varias posiciones”) que existen tal cual en las notas: con un corpus de 12 notas, el modelo copia mucho, una limitación que comparte, a otra escala, con los modelos grandes cuando memorizan sus datos de entrenamiento.
Ningún modelo de bigramas va a escribir un buen resumen, y no es el objetivo. Lo importante es que el bucle es el mismo que ejecuta un modelo como Claude: la diferencia está en la calidad de los logits (que dependen de miles de millones de parámetros y de todo el contexto) y no en la manera de elegir.
Diego vuelve a la carga: “Si con $T = 0.5$ ya sale una frase sin sentido, ¿para qué subirla?”. Sofía responde con la tabla de entropías: para resumir apuntes, nada de subirla; para buscar el título de un dibujo, un poco de sorpresa es justo lo que quiere.
¿Y en la API de Claude?
Todo lo anterior se ha calculado offline con numpy, y no por casualidad. Durante años, las API de modelos de lenguaje exponían la temperatura, top-k y top-p como parámetros de cada llamada. Los modelos actuales de Claude ya no funcionan así.
Los modelos actuales de Claude (Fable 5.1, Sonnet 5.5 y Haiku 5.5, entre otros) no aceptan valores no predeterminados de temperature, top_p ni top_k: la petición falla con un error 400. Lo más sencillo es no enviarlos. El control disponible es output_config={"effort": ...}, con los niveles low, medium, high, xhigh y max. Consulte la documentación oficial de Anthropic para saber qué niveles admite cada modelo y cuál es su valor por defecto.
¿Por qué desaparecen estos controles? Los modelos actuales razonan internamente antes de responder (en Fable 5.1 ese pensamiento está siempre activo) y su calidad depende de cómo se muestrean muchos tokens intermedios que el usuario no ve. Ajustar la temperatura a mano rompería ese equilibrio. En su lugar, la API ofrece el esfuerzo: una indicación de cuánto debe pensar y cuánto debe extenderse el modelo. Más esfuerzo suele significar respuestas más cuidadosas y más tokens de salida; menos esfuerzo, respuestas más rápidas y baratas. La Tabla 4 resume los niveles y el uso que Sofía les da en el Cuaderno Vivo.
Tabla 4. Niveles de esfuerzo de la API de Claude y uso sugerido en el Cuaderno Vivo.
| Nivel | Qué pide al modelo | Uso sugerido en el Cuaderno Vivo |
|---|---|---|
low | Respuesta directa, poco razonamiento | Etiquetar una nota, resumen de una línea |
medium | Equilibrio entre rapidez y cuidado | Resumen de una nota de estudio |
high | Razonamiento más largo y respuesta más elaborada | Explicar un concepto difícil de estadística |
xhigh | Más razonamiento todavía, para tareas largas | Revisar la coherencia de varias notas a la vez |
max | El máximo que permita el modelo | Casi nunca: tareas excepcionales y sin prisa |
Observe que el esfuerzo no es una temperatura. La temperatura cambia la forma de una distribución; el esfuerzo cambia cuánto trabajo hace el modelo antes de comprometerse con una respuesta. Ambos influyen en el resultado, pero por caminos distintos. Diego lo traduce a su idioma: “El esfuerzo no da más creatividad; da más tokens en la factura”.
Puede comprobarlo con dos llamadas a Claude Sonnet 5.5 que solo se diferencian en el esfuerzo. El bloque comprueba stop_reason antes de leer el texto y calcula el coste con los precios de Sonnet 5.5 ($2$ USD por millón de tokens de entrada y $10$ USD por millón de salida). Este bloque llama a la API y no se ejecutó al preparar la entrada; la salida que lo acompaña es un ejemplo:
# Comparación de dos niveles de esfuerzo con la API de Claude en Python:
import anthropic

client = anthropic.Anthropic()
pregunta = 'Explique en tres frases qué hace la temperatura en un modelo de lenguaje.'
precio_entrada, precio_salida = 2.00, 10.00

# Misma pregunta con esfuerzo bajo y alto, sin temperature ni top_p:
for esfuerzo in ['low', 'high']:
    respuesta = client.messages.create(
        model = 'claude-sonnet-5-5',
        max_tokens = 2000,
        output_config = {'effort': esfuerzo},
        system = 'Es el tutor del Cuaderno Vivo. Responda en español, con claridad.',
        messages = [{'role': 'user', 'content': pregunta}]
    )
    if respuesta.stop_reason == 'refusal':
        print(esfuerzo, 'rechazada')
        continue
    texto = ''.join(b.text for b in respuesta.content if b.type == 'text')
    uso = respuesta.usage
    coste = (uso.input_tokens * precio_entrada + uso.output_tokens * precio_salida) / 1e6
    print(f'{esfuerzo}: stop_reason = {respuesta.stop_reason}, '
          f'entrada = {uso.input_tokens}, salida = {uso.output_tokens}, coste = {coste:.5f} USD')
    print(texto[:120], '...')
# Salida de ejemplo (puede variar):
# low: stop_reason = end_turn, entrada = 48, salida = 96, coste = 0.00106 USD
# La temperatura divide los logits antes de aplicar softmax. Con valores bajos, el modelo elige casi siempre ...
# high: stop_reason = end_turn, entrada = 48, salida = 412, coste = 0.00422 USD
# La temperatura es un parámetro que controla cuán concentrada está la distribución de probabilidad sobre ...
En esta salida de ejemplo, el esfuerzo alto produce unas cuatro veces más tokens de salida ($412$ frente a $96$) y, por tanto, unas cuatro veces más coste por consulta. Las cifras exactas variarán en cada ejecución, pero la dirección del efecto es la que importa: a más esfuerzo, más tokens de salida y más gasto. El presupuesto de Sofía es de $10$ USD al mes, y en el Día 4 calculará con precisión cuántas consultas caben en él.
Dos detalles del código merecen atención. El primero es max_tokens = 2000: con esfuerzo alto, el modelo puede dedicar tokens a razonar antes de responder, y esos tokens también cuentan en el límite de salida; un límite muy corto, como $100$ o incluso $400$, podría cortar la respuesta y devolver stop_reason = 'max_tokens'. El segundo es la comprobación de stop_reason antes de leer el contenido: una petición rechazada no trae el texto esperado, y el Cuaderno Vivo debe saberlo antes de mostrar nada.
Si la API ya no deja tocar la temperatura, ¿para qué ha servido todo lo anterior? Para tres cosas. Primero, para entender por qué el mismo prompt puede dar respuestas distintas: el modelo sigue muestreando, aunque usted no controle el dial. Segundo, para aplicar estas técnicas en modelos abiertos que se ejecutan en su propio equipo, donde la temperatura, top-k y top-p siguen disponibles. Tercero, para diseñar sus propios muestreadores, como el de los bigramas, cuando construya componentes generativos pequeños dentro de un proyecto.
Consideraciones finales
Ha recorrido el camino completo desde un vector de logits hasta una frase. Ahora conviene dar un paso atrás y preguntarse qué significa todo esto para un proyecto personal. La tensión de fondo es entre creatividad y fiabilidad: una distribución plana produce sorpresa y variedad, una distribución picuda produce estabilidad y repetición. No hay un punto óptimo universal; hay un punto adecuado para cada tarea.
Un asistente de estudio como el Cuaderno Vivo prefiere, casi siempre, salidas estables. Si Sofía pide el resumen de su nota sobre la desviación estándar dos veces seguidas y recibe dos resúmenes con matices contradictorios, perderá la confianza en la herramienta. En cambio, si pide diez títulos para un dibujo y recibe diez variaciones de la misma frase, la herramienta no le sirve. Antes de elegir una configuración, hágase estas preguntas:
- ¿Hay una respuesta correcta o varias respuestas aceptables?
- ¿Qué cuesta más, una respuesta aburrida o una respuesta equivocada?
- ¿Va a leer una sola salida o va a elegir entre varias?
Hay además una consecuencia ética que no debe pasar por alto. Como el modelo muestrea, puede producir cosas distintas ante la misma pregunta, y alguna de ellas puede ser falsa aunque suene igual de segura que las demás. No tome una salida aislada como verdad. Si una afirmación importa, pida la respuesta más de una vez, compare y contraste con una fuente. Esta idea es el anticipo de las alucinaciones, que estudiará a fondo en el Día 18: un modelo que “inventa” no está mintiendo, está muestreando de una distribución que asigna probabilidad a continuaciones plausibles pero incorrectas.
Un gran libro que habla de esto es Construya un gran modelo de lenguaje desde cero (o Build a Large Language Model (From Scratch)), en el que Sebastian Raschka implementa en Python, paso a paso, un modelo de la familia GPT: la atención, el entrenamiento y las estrategias de decodificación con temperatura y top-k. Es la continuación natural de esta entrada si quiere ver estas mismas funciones dentro de una red completa. Si prefiere ir a la fuente, el artículo de Holtzman y colaboradores sobre la degeneración del texto, disponible en arXiv, explica con ejemplos por qué la decodificación voraz se repite y por qué el núcleo funciona mejor.
Un modelo de lenguaje no escribe: elige, token a token, de una distribución que usted puede leer, medir y acotar. Entender esa elección le permite pasar de “a veces responde raro” a “esta configuración tiene una entropía demasiado alta para esta tarea”. Esa precisión es la que convierte una herramienta de IA generativa en una pieza fiable de su proyecto.
Conclusiones clave
Softmax y temperatura
- Softmax convierte cualquier vector de logits en una distribución de probabilidad que respeta su orden, y solo depende de las diferencias entre logits.
- La temperatura divide los logits: con $T < 1$ la distribución se afila (a $T = 0.2$, “cuaderno” tiene $0.993$) y con $T > 1$ se aplana (a $T = 2$, $0.372$).
- La entropía mide la diversidad en bits; con el vocabulario de juguete pasa de $0.066$ bits a $T = 0.2$ a $2.156$ bits a $T = 2$, por debajo del máximo de $2.322$.
Decodificación
- La decodificación voraz es determinista y barata, pero tiende a repetirse y no garantiza la mejor frase.
- Top-k fija el número de candidatos; top-p fija la probabilidad acumulada y adapta el número de candidatos a la confianza del modelo.
- En $1000$ muestras, top-p con $p = 0.9$ conservó casi toda la diversidad del muestreo puro ($1.59$ frente a $1.74$ bits) y eliminó las $33$ apariciones de “dibujo”.
Dentro del modelo
- La atención es un promedio ponderado de valores cuyos pesos salen de un softmax sobre $QK^\top / \sqrt{d_k}$.
- La generación autorregresiva repite “predecir, muestrear, añadir”; el bucle es el mismo en un modelo de bigramas y en un modelo grande.
En la práctica
- Los modelos actuales de Claude no aceptan
temperature,top_pnitop_kno predeterminados; el control disponible esoutput_config.effort. - Más esfuerzo significa más tokens de salida y más coste, de modo que el nivel debe elegirse por tarea.
- Un asistente de estudio prefiere salidas estables, y ninguna salida aislada debe tomarse como verdad.
Mañana, en el Día 4: Mapa de herramientas y primer prototipo del Cuaderno Vivo. Cerrará el módulo 1/6 con un mapa de herramientas de IA generativa, una estimación del coste mensual de Sofía y el prototipo v0 que resume una nota desde la línea de comandos, y dejará todo listo para el módulo 2/6, Prompt Engineering y Sistemas Persistentes.
Referencias
- Holtzman, A., Buys, J., Du, L., Forbes, M. y Choi, Y. (2020). The Curious Case of Neural Text Degeneration. International Conference on Learning Representations (ICLR 2020). https://arxiv.org/abs/1904.09751
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł. y Polosukhin, I. (2017). Attention Is All You Need. Advances in Neural Information Processing Systems 30. https://arxiv.org/abs/1706.03762
- Raschka, S. (2024). Build a Large Language Model (From Scratch). Manning.