IA generativa en proyectos personales: Día 6
 Jeshua Romero Guadarrama
- 47 Min para leer
- 06 Jan, 2026
Índice de contenido
Resumen:
Un prompt bien construido todavía puede equivocarse si el modelo no sabe dónde están las fronteras entre categorías, si su respuesta llega en un formato que el programa no entiende o si una sola instrucción intenta hacer demasiadas cosas a la vez. En esta entrada se mide cuánto aporta cada ejemplo en un prompt (zero-shot frente a few-shot) con exactitud y matriz de confusión, se explica cómo se regula hoy el razonamiento con effort, se obtiene JSON validado con client.messages.parse y un modelo Pydantic, y se encadenan tres prompts con el coste de cada eslabón. Al terminar, usted sabrá elegir la técnica adecuada para cada tarea y justificarla con números.
¿Cómo citar el presente artículo?
Romero, J. (6 de enero de 2026). IA generativa en proyectos personales: Día 6. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_6/.
IA generativa en proyectos personales: Día 6 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_6/.
Modelos, precios y regulación revisados en octubre de 2026.
Día 6. Ejemplos, cadenas de prompts y salidas estructuradas
Introducción
Ayer, en el Día 5 (Anatomía de un prompt: rol, contexto, tarea y formato), aprendió a descomponer un prompt en piezas y a comparar versiones con una rúbrica en lugar de con impresiones, y el Cuaderno Vivo ganó plantillas de prompt que se versionan y se evalúan como cualquier otro código. Esa rúbrica dejó una lección incómoda: aun con rol, contexto, tarea y formato bien escritos, hay tareas en las que el modelo duda, y la duda casi siempre aparece en los mismos sitios, las fronteras entre categorías.
Hoy el Cuaderno Vivo aprende a etiquetar notas. Sofía quiere que cada nota nueva quede clasificada en uno de sus cuatro temas de estudio (estadística, Python, historia del arte y música) para poder filtrar, repasar por tema y, más adelante, recuperar las notas relevantes cuando haga una pregunta (Día 7). Parece una tarea trivial para un modelo de frontera, y en la mayoría de las notas lo es. Pero basta una nota sobre “medir el tiempo con un metrónomo” o sobre “sumar los datos de una lista” para que la palabra equivocada arrastre la etiqueta equivocada.
En la presente entrada, descubrirá cómo enseñar a un modelo con ejemplos dentro del prompt (zero-shot y few-shot) y cómo medir cuánto aporta cada ejemplo en exactitud y en tokens. Verá cómo leer una matriz de confusión para saber dónde se equivoca el clasificador, qué significa hoy pedir a un modelo que razone antes de responder, por qué el truco del prefill ya no sirve y cómo obtener JSON validado con un modelo Pydantic. Al final construirá una cadena de tres prompts (extraer, clasificar y redactar una pregunta de repaso) y comparará su coste con el de una sola llamada a un modelo más caro.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Aplicar zero-shot y few-shot y medir cuánto aporta cada ejemplo.
- Pedir razonamiento paso a paso cuando conviene y entender que en los modelos actuales el pensamiento se regula con
effort. - Obtener JSON válido con
client.messages.parsey un modelo Pydantic, en lugar de prefill. - Encadenar prompts (extraer, clasificar, redactar) y medir el coste de cada eslabón.
La tarea: clasificar notas en cuatro temas
Toda técnica de prompts se entiende mejor con una tarea concreta y un conjunto de prueba fijo. La tarea de hoy es de clasificación: dada una nota, devolver exactamente una de cuatro etiquetas. El conjunto de prueba son las 12 notas de Sofía que se publicaron completas en la Tabla 1 del Día 1 y que la serie reutiliza como corpus canónico: tres de estadística, tres de Python, tres de historia del arte y tres de música. Como cada nota ya trae su tema verdadero, se puede comparar cualquier predicción con la respuesta correcta y calcular métricas, exactamente igual que en un problema clásico de aprendizaje automático.
Hay una diferencia importante con ese mundo clásico. Aquí no se entrena ningún modelo: el modelo de lenguaje ya está entrenado, y lo único que cambia entre una configuración y otra es el texto del prompt. Por eso a esta forma de “enseñar” se la llama aprendizaje en contexto (in-context learning): los ejemplos viven dentro de la petición, no en los pesos del modelo, y desaparecen en cuanto termina la llamada.
Hay dos decisiones de diseño que conviene tomar antes de escribir una sola línea de código:
- Los ejemplos del prompt no pueden ser notas del conjunto de prueba. Si la nota 12 aparece como ejemplo y después se pide clasificar la nota 12, el modelo solo tiene que copiar la respuesta. Por eso Sofía escribe un banco de cinco ejemplos aparte, con notas nuevas que no se evaluarán.
- Las etiquetas se escriben siempre igual. El tema es
pythonen minúsculas, no “Python” ni “programación”; si el prompt usa una grafía y el código compara con otra, la exactitud cae por un problema de formato y no de comprensión.
Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie, $2026$, como en los días anteriores:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
pd.set_option('display.max_columns', 10)
print('numpy', np.__version__, '| pandas', pd.__version__)
numpy 2.4.6 | pandas 3.0.3
La salida confirma las versiones con las que se ejecutaron todas las cifras de esta entrada. El siguiente bloque carga las 12 notas tal como están en el Día 1, define el banco de cinco ejemplos y escribe el constructor prompt_few_shot(k, nota), que coloca los k primeros ejemplos del banco delante de la nota que se quiere clasificar. Cada ejemplo va delimitado con etiquetas XML (<ejemplo>, <nota>, <tema>), la técnica de delimitación que vio ayer. Como todavía no se llama a la API, los tokens se estiman con una regla gruesa de unos $3.5$ caracteres por token en español; la cifra exacta solo la da client.messages.count_tokens, como se vio en el Día 2:
# Las 12 notas de Sofía (Tabla 1 del Día 1) como conjunto de prueba en Python:
notas = [
    ('estadística', 'La media resume un conjunto de datos en un solo número, pero es sensible a los valores extremos de la muestra.'),
    ('estadística', 'La desviación estándar mide cuánto se alejan los datos de la media y ayuda a comparar la dispersión de dos grupos.'),
    ('estadística', 'Un intervalo de confianza da un rango de valores plausibles para la media de la población a partir de una muestra.'),
    ('python', 'En Python una lista guarda elementos en orden y se puede recorrer con un ciclo for para sumar los datos.'),
    ('python', 'Pandas lee un archivo CSV y crea una tabla de datos que se puede filtrar, agrupar y resumir con pocas líneas.'),
    ('python', 'Una función en Python recibe argumentos y devuelve un resultado, lo que ayuda a no repetir el mismo código.'),
    ('historia del arte', 'El Renacimiento recuperó la perspectiva y la proporción del arte clásico para dar profundidad a la pintura.'),
    ('historia del arte', 'El impresionismo pintó la luz al aire libre con pinceladas sueltas y colores puros sin mezclar en la paleta.'),
    ('historia del arte', 'El cubismo rompió la perspectiva única y mostró un objeto desde varios puntos de vista en el mismo cuadro.'),
    ('música', 'Una escala mayor sigue el patrón tono, tono, semitono, tono, tono, tono, semitono y suena alegre en la guitarra.'),
    ('música', 'Un acorde se forma con tres notas de la escala y la guitarra puede tocar el mismo acorde en varias posiciones.'),
    ('música', 'Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.'),
]
datos = pd.DataFrame(notas, columns = ['tema', 'texto'])
datos.insert(0, 'id', range(1, len(datos) + 1))
temas = ['estadística', 'python', 'historia del arte', 'música']

# Banco de ejemplos etiquetados, distintos de las 12 notas de prueba:
ejemplos = [
    ('estadística', 'La mediana es el valor central de los datos ordenados y casi no cambia si aparece un valor extremo.'),
    ('python', 'Un diccionario de Python guarda pares de clave y valor y permite buscar un dato por su nombre.'),
    ('historia del arte', 'El barroco usó contrastes fuertes de luz y sombra para dar dramatismo a la escena.'),
    ('música', 'El compás de cuatro tiempos marca cuatro pulsos y es el más común en la música popular.'),
    ('python', 'Con numpy se calcula la media de una lista de números con una sola función.'),
]

# Instrucción de sistema común a todas las configuraciones:
INSTRUCCION = ('Clasifique la nota de estudio de Sofía en uno de estos temas: '
               'estadística, python, historia del arte, música. '
               'Responda solo con el nombre del tema, en minúsculas.')

def prompt_few_shot(k, nota):
    # Los k primeros ejemplos del banco, delimitados, y después la nota a clasificar:
    partes = []
    for tema, texto in ejemplos[:k]:
        partes.append(f'<ejemplo>\n<nota>{texto}</nota>\n<tema>{tema}</tema>\n</ejemplo>')
    partes.append(f'<nota>{nota}</nota>')
    return '\n\n'.join(partes)

# Aproximación offline: unos 3.5 caracteres por token en español:
def estimar_tokens(texto):
    return round(len(texto) / 3.5)

prompt_3 = prompt_few_shot(3, datos.loc[11, 'texto'])
print(prompt_3)
print('Tokens estimados (sistema + usuario):', estimar_tokens(INSTRUCCION) + estimar_tokens(prompt_3))
<ejemplo>
<nota>La mediana es el valor central de los datos ordenados y casi no cambia si aparece un valor extremo.</nota>
<tema>estadística</tema>
</ejemplo>

<ejemplo>
<nota>Un diccionario de Python guarda pares de clave y valor y permite buscar un dato por su nombre.</nota>
<tema>python</tema>
</ejemplo>

<ejemplo>
<nota>El barroco usó contrastes fuertes de luz y sombra para dar dramatismo a la escena.</nota>
<tema>historia del arte</tema>
</ejemplo>

<nota>Practicar la guitarra cada día con un metrónomo ayuda a medir el tiempo y a tocar con un ritmo estable.</nota>
Tokens estimados (sistema + usuario): 210
La salida muestra el prompt de usuario con tres ejemplos para la nota 12, la del metrónomo. Observe tres detalles. Primero, la instrucción no está en este texto: va en el parámetro system, separada de los datos, como recomendó el Día 5. Segundo, cada ejemplo tiene exactamente la misma forma que la respuesta que se espera (<tema> con la etiqueta en minúsculas), de modo que el ejemplo enseña a la vez el criterio y el formato. Tercero, el prompt completo ocupa unos $210$ tokens estimados, de los cuales la nota que interesa clasificar es apenas una séptima parte (unos $30$ tokens): en few-shot, la mayor parte de lo que se paga son los ejemplos.
Note también que los tres primeros ejemplos del banco cubren estadística, Python e historia del arte, pero no música. Es un descuido deliberado del orden del banco, y enseguida verá qué consecuencia tiene.
Zero-shot y few-shot
Se llama zero-shot (cero ejemplos) a pedir la tarea solo con la instrucción, confiando en lo que el modelo ya sabe. Se llama few-shot (pocos ejemplos) a añadir unos cuantos pares de entrada y salida resueltos antes de la entrada real. El término se popularizó con el artículo de GPT-3 de Brown y colaboradores (2020), que mostró que un modelo grande podía resolver tareas nuevas con solo ver algunos ejemplos en el prompt, sin ajustar un solo parámetro. Con un ejemplo se habla de one-shot.
El primer paso siempre es zero-shot, por dos razones: es la línea base contra la que se mide todo lo demás y es la opción más barata. El siguiente bloque muestra cómo se haría la llamada de clasificación con Claude Haiku 5.5, el modelo rápido y barato que la serie reserva para clasificar. Este bloque llama a la API, así que necesita el paquete anthropic y la variable de entorno ANTHROPIC_API_KEY, y no se ejecutó para escribir la entrada; su salida es un ejemplo:
# Clasificación zero-shot de una nota con Claude Haiku 5.5 en Python:
import anthropic

# El cliente lee la clave ANTHROPIC_API_KEY del entorno:
cliente = anthropic.Anthropic()

def clasificar_texto(nota, k = 0, modelo = 'claude-haiku-5-5'):
    respuesta = cliente.messages.create(
        model = modelo,
        max_tokens = 1024,
        system = INSTRUCCION,
        output_config = {'effort': 'low'},
        messages = [{'role': 'user', 'content': prompt_few_shot(k, nota)}]
    )
    # Motivo de parada antes de leer el texto:
    if respuesta.stop_reason == 'refusal':
        return None, respuesta.usage
    texto = ''.join(b.text for b in respuesta.content if b.type == 'text')
    return texto.strip().lower(), respuesta.usage

tema, uso = clasificar_texto(datos.loc[11, 'texto'], k = 0)
print('Tema:', tema, '| tokens:', uso.input_tokens, 'de entrada,', uso.output_tokens, 'de salida')

# Salida de ejemplo (puede variar):
# Tema: estadística | tokens: 104 de entrada, 6 de salida
La función clasificar_texto es la misma para cualquier número de ejemplos: basta con cambiar k. Fíjese en lo que no aparece. No hay temperature: los modelos actuales de Claude rechazan valores de muestreo distintos de los predeterminados (lo vio en el Día 3), y la profundidad se controla con output_config={"effort": "low"}. Tampoco hay un turno de asistente al final de messages para forzar la respuesta; ese truco ya no existe, como verá en la sección de salidas estructuradas. Y antes de leer el texto se comprueba stop_reason, la costumbre que el prototipo v0 introdujo en el Día 4.
En la salida de ejemplo, la nota del metrónomo sale clasificada como estadística. No es un capricho: la nota dice “medir el tiempo” y “ritmo estable”, y sin más contexto “medir” y “estable” pesan hacia la estadística. Un modelo sin ejemplos no conoce las fronteras de Sofía; conoce las fronteras promedio de todo lo que leyó.
Cuánto aporta cada ejemplo
Para decidir cuántos ejemplos poner, Sofía clasifica las 12 notas con 0, 1, 3 y 5 ejemplos y compara. La métrica más directa es la exactitud (accuracy): la proporción de notas cuya etiqueta predicha coincide con la verdadera.
$$ \text{Exactitud}=\frac{1}{n}\sum_{i=1}^{n}\mathbf{1}\left[\hat{y}_i=y_i\right] $$
La lógica detrás de esta métrica es sencilla:
- $y_i$ es el tema verdadero de la nota $i$ y $\hat{y}_i$ el tema que devolvió el modelo; la función indicadora $\mathbf{1}[\cdot]$ vale $1$ si coinciden y $0$ si no.
- La suma cuenta los aciertos y la división entre $n$ los convierte en proporción, de modo que la cifra no depende del tamaño del conjunto.
- Todas las notas pesan lo mismo, y todos los errores también: confundir música con estadística cuesta lo mismo que confundir Python con arte.
- En conclusión, la exactitud responde a ¿cuántas acierta?, pero no a ¿dónde falla?; para eso hará falta la matriz de confusión de la sección siguiente.
Pero la exactitud sola no basta para decidir, porque cada ejemplo cuesta tokens en cada consulta. Para poner las dos cosas en la misma escala se puede calcular la ganancia marginal de exactitud por cada 100 tokens añadidos:
$$ g_k=\frac{\text{Exactitud}k-\text{Exactitud}{k’}}{T_k-T_{k’}}\cdot 100 $$
donde $k$ es una configuración, $k’$ la configuración anterior con menos ejemplos y $T$ los tokens de entrada medios por consulta.
- El numerador es lo que se gana en aciertos al pasar de $k’$ a $k$ ejemplos.
- El denominador es lo que se paga en tokens por ese paso.
- Multiplicar por $100$ solo hace legible la cifra: “puntos de exactitud por cada 100 tokens”.
- En conclusión, cuando $g_k$ llega a cero, el ejemplo adicional es un gasto sin retorno, por bueno que parezca.
Las predicciones de la serie son de juguete: no salen de llamar a la API, sino que están escritas a mano en el código para que todos los números de la entrada sean reproducibles sin clave ni coste. Representan un comportamiento verosímil (las notas con vocabulario ambiguo son las que fallan), pero no son una medición real de Claude Haiku 5.5. Lo que sí es real es el método: con predicciones verdaderas, el mismo código daría la tabla verdadera.
# Predicciones de juguete por número de ejemplos y exactitud en Python:
from sklearn.metrics import accuracy_score

reales = datos['tema'].tolist()
E, P, A, M = temas
predicciones = {
    0: [E, E, E, E, E, P, A, A, A, E, M, E],
    1: [E, E, E, P, E, P, A, A, A, E, M, E],
    3: [E, E, E, P, P, P, A, A, A, M, M, E],
    5: [P, E, E, P, P, P, A, A, A, M, M, M],
}

# Exactitud, aciertos y tokens de entrada medios de cada configuración:
filas = []
for k, pred in predicciones.items():
    tokens = [estimar_tokens(INSTRUCCION) + estimar_tokens(prompt_few_shot(k, t)) for t in datos['texto']]
    filas.append({'ejemplos': k, 'aciertos': sum(p == r for p, r in zip(pred, reales)),
                  'exactitud': accuracy_score(reales, pred), 'tokens_entrada': np.mean(tokens)})
resultados = pd.DataFrame(filas).set_index('ejemplos')

# Ganancia de exactitud por cada 100 tokens añadidos respecto a la fila anterior:
resultados['ganancia_100_tokens'] = (resultados['exactitud'].diff()
                                     / resultados['tokens_entrada'].diff() * 100)
print(resultados.round(3))
print('Notas falladas por configuración:')
for k, pred in predicciones.items():
    print(f'  {k} ejemplos:', [i + 1 for i, (p, r) in enumerate(zip(pred, reales)) if p != r])
          aciertos  exactitud  tokens_entrada  ganancia_100_tokens
ejemplos
0                8      0.667          80.667                  NaN
1                9      0.750         126.500                0.182
3               11      0.917         211.750                0.196
5               11      0.917         290.333                0.000
Notas falladas por configuración:
  0 ejemplos: [4, 5, 10, 12]
  1 ejemplos: [5, 10, 12]
  3 ejemplos: [12]
  5 ejemplos: [1]
La Tabla 1 traslada la salida. La exactitud se calcula con accuracy_score de scikit-learn sobre las listas fijas; no se escribe a mano en ningún sitio.
Tabla 1. Exactitud de juguete y tokens de entrada estimados según el número de ejemplos (12 notas de prueba).
| Ejemplos | Aciertos | Exactitud | Tokens de entrada medios | Ganancia por 100 tokens | Notas falladas |
|---|---|---|---|---|---|
| 0 | 8 | 0.667 | 80.7 | No aplica | 4, 5, 10, 12 |
| 1 | 9 | 0.750 | 126.5 | 0.182 | 5, 10, 12 |
| 3 | 11 | 0.917 | 211.8 | 0.196 | 12 |
| 5 | 11 | 0.917 | 290.3 | 0.000 | 1 |
Lea la tabla de izquierda a derecha. Sin ejemplos, el clasificador acierta $8$ de $12$ notas, una exactitud de $0.667$. Las cuatro que falla tienen algo en común: la nota 4 habla de “sumar los datos”, la 5 de “una tabla de datos” que se puede “resumir”, la 10 de una “escala” con un “patrón” y la 12 de “medir el tiempo”. Todas contienen vocabulario que, fuera de contexto, suena a estadística, y todas se fueron a estadística.
Con un ejemplo (el de la mediana), la exactitud sube a $0.750$: la nota 4 se corrige, probablemente porque el ejemplo fija el formato y el estilo de las notas. Con tres ejemplos, que ya incluyen uno de Python y otro de arte, llega a $0.917$: solo falla la nota 12. Y aquí está el dato que justifica medir: con cinco ejemplos la exactitud no sube, se queda en $0.917$, pero cambia cuál falla. La nota 12 se corrige gracias al ejemplo de música (el del compás), y a cambio la nota 1, “la media resume un conjunto de datos”, pasa a clasificarse como Python. El culpable es el quinto ejemplo del banco, “con numpy se calcula la media de una lista”: una nota de Python con vocabulario de estadística que desplazó la frontera.
La columna de ganancia lo resume. Los pasos de $0$ a $1$ y de $1$ a $3$ ejemplos aportan unos $0.18$ y $0.20$ puntos de exactitud por cada 100 tokens; el paso de $3$ a $5$ aporta cero y cuesta $78.6$ tokens más por consulta ($290.3 - 211.8$). Con cinco ejemplos, cada consulta lleva $3.6$ veces los tokens de la versión zero-shot ($290.3/80.7$) para la misma exactitud que con tres.
En dinero, con los precios de Haiku 5.5 ($0.10$ USD por millón de tokens de entrada), clasificar las $600$ notas de un mes con tres ejemplos costaría $600 \cdot 211.75 \cdot 0.10/10^6 \approx 0.0127$ USD. La cifra es diminuta, y eso es precisamente una trampa: cuando el coste por consulta parece despreciable se deja de medir, y el mismo patrón de “un ejemplo más, por si acaso” aplicado a un prompt de Sonnet 5.5 con diez ejemplos largos y miles de consultas sí se nota en la factura.
La forma más rápida de ver el compromiso es una sola gráfica con dos ejes, la exactitud en uno y los tokens en otro:
# Exactitud y tokens de entrada frente al número de ejemplos en Python:
fig, ax1 = plt.subplots(figsize = (7.2, 4.8))
x = resultados.index.to_numpy()
ax1.plot(x, resultados['exactitud'], 'o-', color = '#2a78d6', linewidth = 2, markersize = 8, label = 'Exactitud')
for k, valor in resultados['exactitud'].items():
    ax1.annotate(f'{valor:.2f}', (k, valor), textcoords = 'offset points', xytext = (0, 9),
                 ha = 'center', color = '#2a78d6', fontsize = 10)
ax1.set_ylim(0.5, 1.02)
ax1.set_xlabel('Número de ejemplos en el prompt')
ax1.set_ylabel('Exactitud en las 12 notas', color = '#2a78d6')
ax1.set_xticks(x)

# Segundo eje para el coste en tokens:
ax2 = ax1.twinx()
ax2.bar(x, resultados['tokens_entrada'], width = 0.6, color = '#eb6834', alpha = 0.35, label = 'Tokens de entrada')
ax2.set_ylim(0, resultados['tokens_entrada'].max() * 1.6)
ax2.set_ylabel('Tokens de entrada medios (estimados)', color = '#eb6834')
ax1.set_zorder(ax2.get_zorder() + 1)
ax1.patch.set_visible(False)
ax1.grid(True, color = '#e6e5e1', linewidth = 0.8)
lineas = ax1.get_legend_handles_labels()
barras = ax2.get_legend_handles_labels()
ax1.legend(lineas[0] + barras[0], lineas[1] + barras[1], loc = 'lower right', frameon = False)
ax1.set_title('Cuánto aporta cada ejemplo', fontsize = 16)
plt.tight_layout()
plt.show()
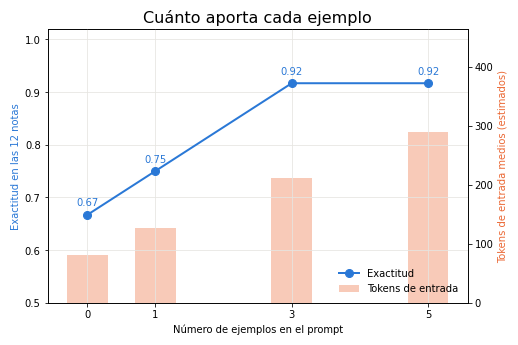
La línea azul (exactitud) sube con fuerza hasta los tres ejemplos y después se aplana; las barras naranjas (tokens) siguen creciendo casi en línea recta, porque cada ejemplo añade más o menos los mismos caracteres. Ese dibujo, una curva que se satura frente a un coste que no se satura, es el patrón típico del few-shot, y la razón por la que el número correcto de ejemplos es el menor que alcanza la meseta, no el mayor que cabe en la ventana.
Elegir buenos ejemplos
La Tabla 1 muestra que no todos los ejemplos valen lo mismo: el de música corrigió una nota y el de numpy estropeó otra. Elegir ejemplos es elegir qué fronteras ve el modelo, y hay cuatro criterios que se pueden comprobar:
- Variedad: al menos un ejemplo por clase. Con tres ejemplos, Sofía no tenía ninguno de música, y la única nota fallada fue de música. Una clase sin ejemplos se trata como si fuera zero-shot.
- Casos frontera, con cuidado. Un ejemplo ambiguo bien etiquetado enseña dónde está la línea; el de numpy enseña que “calcular la media con código” es Python. Pero desplaza la frontera para todas las notas parecidas, y la nota 1 pagó el precio. Si incluye un caso frontera, incluya también su pareja del otro lado (por ejemplo, “la media de una muestra estima la media de la población”, etiquetada como estadística).
- Orden. Los modelos pueden dar más peso a los últimos ejemplos o a la etiqueta más repetida. Zhao y colaboradores (2021) documentaron ese sesgo de recencia y de mayoría, y Lu y colaboradores (2022) mostraron que solo cambiar el orden de los mismos ejemplos podía mover mucho la exactitud en los modelos de entonces. Los modelos actuales son más robustos, pero la medida es barata: baraje los ejemplos y repita la evaluación.
- Formato idéntico al de la respuesta. Si los ejemplos responden
<tema>python</tema>y la instrucción pide “solo el nombre del tema”, el modelo recibe dos formatos. Que coincidan ahorra errores de análisis después.
Atención aquí: nunca use como ejemplo del prompt una nota del conjunto de prueba. Si la nota 12 aparece entre los ejemplos, el modelo la “acierta” copiando, la exactitud sube y la cifra deja de decir nada sobre las notas nuevas que Sofía escribirá mañana. Es la versión en prompts de la fuga de datos entre entrenamiento y prueba que se evita en cualquier proyecto de aprendizaje automático.
Los ejemplos también transmiten sesgos. Fíjese en el banco y en las notas de prueba de historia del arte: barroco, Renacimiento, impresionismo, cubismo. Todos son movimientos europeos. Si Sofía escribe mañana una nota sobre el muralismo mexicano o sobre la pintura de tinta china, nada en los ejemplos le dice al modelo que eso también es “historia del arte” en su cuaderno, y una frontera estrecha puede empujar esas notas hacia otra etiqueta o hacia la duda. El sesgo no está en el modelo solo, está también en lo que usted le enseña en el prompt. La recomendación es sencilla de aplicar: revise que los ejemplos de cada clase cubran la variedad real de lo que espera clasificar, no solo lo primero que le vino a la mente.
Medir la clasificación
La exactitud de $0.917$ con tres ejemplos dice que falla una nota de doce, pero no cuál ni hacia dónde. Para eso existe la matriz de confusión: una tabla en la que cada fila es un tema real, cada columna un tema predicho y cada celda cuenta cuántas notas de esa fila acabaron en esa columna. Los aciertos quedan en la diagonal; todo lo que está fuera de ella es un error con nombre y apellido.
De la matriz salen métricas por clase. La más útil para Sofía es la sensibilidad (recall) de cada tema: de todas las notas que realmente son de ese tema, qué proporción encontró el clasificador.
$$ \text{Sensibilidad}_c=\frac{VP_c}{VP_c+FN_c} $$
La lógica de esta métrica es la siguiente:
- $VP_c$ (verdaderos positivos) son las notas del tema $c$ que se clasificaron como $c$: la celda de la diagonal en la fila de $c$.
- $FN_c$ (falsos negativos) son las notas del tema $c$ que se clasificaron como otra cosa: el resto de la fila.
- El denominador es, por tanto, el total de la fila: todas las notas que de verdad son de ese tema.
- En conclusión, una sensibilidad baja en música significa que las notas de música “se pierden” en otros temas, y cuando Sofía filtre por música no las verá.
La métrica hermana es la precisión, que mira por columnas: de todas las notas que el clasificador llamó $c$, cuántas lo eran. El siguiente código construye la matriz de la configuración con tres ejemplos, calcula la sensibilidad por tema con cero y con tres ejemplos, y dibuja la matriz con ConfusionMatrixDisplay:
# Matriz de confusión de la configuración con 3 ejemplos en Python:
from sklearn.metrics import confusion_matrix, ConfusionMatrixDisplay, recall_score

matriz = confusion_matrix(reales, predicciones[3], labels = temas)
cortos = ['estadística', 'python', 'arte', 'música']
print(pd.DataFrame(matriz, index = cortos, columns = cortos))

# Sensibilidad (recall) por tema, con 0 y con 3 ejemplos:
sensibilidad = pd.DataFrame({
    '0 ejemplos': recall_score(reales, predicciones[0], labels = temas, average = None),
    '3 ejemplos': recall_score(reales, predicciones[3], labels = temas, average = None)
}, index = cortos)
print(sensibilidad.round(2))

fig, ax = plt.subplots(figsize = (6.4, 5.4))
ConfusionMatrixDisplay(matriz, display_labels = cortos).plot(ax = ax, cmap = 'Blues', colorbar = False)
ax.set_xlabel('Tema predicho')
ax.set_ylabel('Tema real')
ax.set_title('Matriz de confusión con 3 ejemplos', fontsize = 16)
plt.tight_layout()
plt.show()
             estadística  python  arte  música
estadística            3       0     0       0
python                 0       3     0       0
arte                   0       0     3       0
música                 1       0     0       2
             0 ejemplos  3 ejemplos
estadística        1.00        1.00
python             0.33        1.00
arte               1.00        1.00
música             0.33        0.67
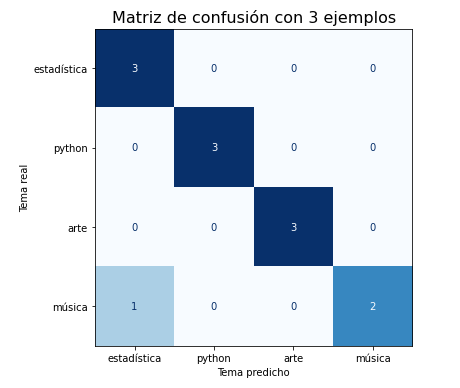
La Tabla 2 reproduce la matriz con los nombres completos de los temas.
Tabla 2. Matriz de confusión de juguete de la configuración con 3 ejemplos (filas: tema real; columnas: tema predicho).
| Tema real | Estadística | Python | Historia del arte | Música | Sensibilidad |
|---|---|---|---|---|---|
| Estadística | 3 | 0 | 0 | 0 | 1.00 |
| Python | 0 | 3 | 0 | 0 | 1.00 |
| Historia del arte | 0 | 0 | 3 | 0 | 1.00 |
| Música | 1 | 0 | 0 | 2 | 0.67 |
La matriz localiza el único error: una nota de música (la 12) en la columna de estadística. Por filas, la sensibilidad de música es $0.67$ ($2$ de $3$); las demás son $1.00$. Por columnas, la precisión de estadística es $3/4 = 0.75$: de las cuatro notas que el clasificador llamó estadística, una no lo era. Es la misma historia contada desde los dos lados: estadística es el tema “imán”, el que atrae las notas con vocabulario de medición.
La comparación con zero-shot es todavía más elocuente. Sin ejemplos, la sensibilidad de Python era $0.33$ y la de música también $0.33$: dos de cada tres notas de esos temas desaparecían en estadística. Con tres ejemplos, Python sube a $1.00$ y música a $0.67$. La exactitud global pasó de $0.667$ a $0.917$, pero la matriz explica dónde está la mejora: casi toda consiste en que estadística deja de robar notas. Si Sofía solo mirara la exactitud, no sabría que el problema pendiente es exclusivamente de música, y que la solución (un ejemplo de música) es obvia una vez que se ve.
En la figura, la diagonal oscura son los aciertos y la celda clara de la esquina inferior izquierda es el error. Con doce notas la matriz cabe en una mirada; con cuatrocientas notas y diez temas sigue siendo la primera gráfica que conviene dibujar.
Diego mira la tabla y hace la pregunta que tocaba: "¿Doce notas bastan para decir que tres ejemplos son mejores que uno?". La respuesta honesta es que no del todo. Con $n = 12$, una sola nota cambia la exactitud en $1/12 \approx 0.083$, y el error estándar de una proporción de $0.917$ es $\sqrt{0.917 \cdot 0.083/12} \approx 0.08$. Es decir, la diferencia entre $0.75$ y $0.917$ son dos notas, apenas el doble de esa incertidumbre. Las cifras de hoy sirven para aprender el método y detectar patrones gruesos (el imán de estadística es claro), pero para decidir entre configuraciones parecidas hace falta un conjunto de prueba más grande y, mejor aún, repetir la evaluación. El Día 18 formaliza esto con intervalos de confianza, y el Día 23 lo convierte en una evaluación automática.
Razonar antes de responder
Hay tareas en las que dar la respuesta de inmediato funciona peor que pensarla. Wei y colaboradores (2022) mostraron que incluir en los ejemplos del prompt el razonamiento intermedio, y no solo la respuesta final, mejoraba mucho a los modelos grandes en problemas aritméticos y de lógica: es la técnica conocida como cadena de pensamiento (chain-of-thought, CoT). Poco después, Kojima y colaboradores (2022) encontraron que bastaba con añadir “pensemos paso a paso” al final de la pregunta, sin ejemplos, para obtener buena parte de esa mejora: el razonamiento paso a paso en zero-shot.
La idea es intuitiva. Un modelo de lenguaje genera un token detrás de otro (Día 3); si la respuesta sale en el primer token, todo el “cálculo” tiene que ocurrir en una sola pasada. Si antes escribe los pasos intermedios, cada paso queda en el contexto y el siguiente puede apoyarse en él. Escribir el razonamiento es, literalmente, darle al modelo más espacio para calcular.
En los modelos actuales de Claude ese razonamiento ya no se pide solo con palabras: el pensamiento es una capacidad del modelo que se activa y se regula desde la API.
- En Claude Fable 5.1, el pensamiento está siempre activo; el parámetro
thinkingse omite y la profundidad se regula conoutput_config={"effort": ...}. - En Claude Haiku 5.5 y Claude Sonnet 5.5, el pensamiento es adaptativo: el propio modelo decide cuánto pensar según la dificultad, y
effort(low,medium,high,xhigh,max) fija cuánto está dispuesto a gastar. - El parámetro antiguo
budget_tokens, que fijaba un número de tokens de pensamiento, ya no es la forma de hacerlo: en Fable 5.1 y en Haiku 5.5 enviarlo devuelve un error 400. Lo mismo que contemperature, el código que lo usaba debe migrarse aeffort.
¿Y la frase “piense paso a paso”? Sigue siendo una instrucción válida, pero con un matiz práctico: si pide el razonamiento en el texto de la respuesta, el razonamiento se mezcla con la etiqueta, y el programa ya no puede leer tema directamente. Cuando necesite a la vez razonamiento y un formato estricto, deje el razonamiento al pensamiento del modelo (que viaja en bloques de tipo thinking, separados de los de tipo text) y pida la respuesta con salidas estructuradas, como en la sección siguiente. Por eso el código de la serie nunca supone que el primer bloque de respuesta.content es el texto: recorre la lista y se queda con los de tipo "text".
El pensamiento tiene un coste que conviene ver en una fórmula, porque los tokens de pensamiento se facturan como tokens de salida:
$$ C=\frac{t_{\text{ent}}\cdot p_{\text{ent}}+\left(t_{\text{pens}}+t_{\text{sal}}\right)\cdot p_{\text{sal}}}{10^{6}} $$
La lógica es la de la fórmula de coste del Día 4, con un término más:
- $t_{\text{ent}}$ y $p_{\text{ent}}$ son los tokens y el precio de entrada; no cambian por pensar.
- $t_{\text{pens}}$ son los tokens de pensamiento, que se suman a los de la respuesta visible $t_{\text{sal}}$ y se cobran al precio de salida, el caro.
- Como en clasificación la respuesta visible es diminuta (una palabra o un JSON corto), cualquier pensamiento puede multiplicar el coste de salida.
- En conclusión, el pensamiento se paga por cada consulta, y solo compensa cuando la tarea lo necesita.
Un cálculo hipotético con Haiku 5.5 lo ilustra. Con la configuración de tres ejemplos ($t_{\text{ent}} \approx 212$) y una respuesta de $5$ tokens, el coste es $(212 \cdot 0.10 + 5 \cdot 0.50)/10^6 = 0.0000237$ USD. Si el modelo pensara $300$ tokens antes de responder (una cifra supuesta, no medida), el coste pasaría a $(212 \cdot 0.10 + 305 \cdot 0.50)/10^6 = 0.0001737$ USD: unas $7.3$ veces más por la misma etiqueta. Por eso la regla práctica es: effort bajo para clasificar, extraer y formatear; effort medio o alto para redactar, planificar o resolver problemas con varios pasos. Clasificar la nota del metrónomo no es un problema de lógica, es un problema de fronteras, y las fronteras se enseñan con ejemplos, no con más pensamiento.
Salidas estructuradas
Hasta ahora el clasificador devuelve texto libre: “estadística”, “Estadística.”, “El tema es estadística” o, en el peor caso, un párrafo. El programa tiene que limpiar y adivinar. Para el Cuaderno Vivo, que guardará cada etiqueta en notas.json y la usará para filtrar, eso no es aceptable: necesita un objeto con campos conocidos, siempre con la misma forma.
Durante años, el truco habitual para conseguirlo era el prefill: terminar messages con un turno de asistente que ya empezaba la respuesta, por ejemplo con {, para que el modelo continuara un JSON. En los modelos actuales de Claude ese truco no existe: una petición cuyo último mensaje es del asistente devuelve un error 400. La alternativa no es un parche, es una capacidad de la API: las salidas estructuradas. Usted describe la forma de la respuesta con un esquema, y la API restringe la generación para que el texto producido cumpla ese esquema.
En Python, la forma más cómoda de describir el esquema es un modelo de Pydantic, una biblioteca que define clases con tipos y valida datos contra ellas. El contrato del Cuaderno Vivo tiene tres campos: el tema (solo uno de los cuatro valores permitidos, gracias a Literal), la confianza del modelo entre $0$ y $1$ y una lista de conceptos clave. Antes de llamar a la API conviene ver qué hace el contrato por sí mismo. El siguiente código, que no necesita red, define el modelo Etiqueta y lo pone a prueba con cuatro respuestas posibles, desde una correcta hasta una cortada a mitad de camino:
# Contrato de salida con Pydantic y validación local de respuestas en Python:
from typing import Literal
from pydantic import BaseModel, Field, ValidationError

class Etiqueta(BaseModel):
    tema: Literal['estadística', 'python', 'historia del arte', 'música']
    confianza: float = Field(ge = 0, le = 1)
    conceptos: list[str]

# Instrucción de sistema para la versión estructurada:
SISTEMA_ETIQUETA = ('Clasifique la nota de estudio de Sofía en uno de estos temas: '
                    'estadística, python, historia del arte, música. Indique su confianza '
                    'entre 0 y 1 y hasta tres conceptos clave que aparezcan en la nota.')

# Cuatro respuestas posibles, de la correcta a la cortada por max_tokens:
candidatas = {
    'válida': '{"tema": "música", "confianza": 0.86, "conceptos": ["guitarra", "metrónomo", "ritmo"]}',
    'tema fuera de la lista': '{"tema": "arte", "confianza": 0.9, "conceptos": ["cubismo"]}',
    'confianza fuera de rango': '{"tema": "python", "confianza": 1.4, "conceptos": ["función"]}',
    'cortada': '{"tema": "estadística", "confianza": 0.7, "concep',
}
for nombre, texto in candidatas.items():
    try:
        etiqueta = Etiqueta.model_validate_json(texto)
        print(f'{nombre:<25} OK    {etiqueta}')
    except ValidationError as error:
        primero = error.errors()[0]
        print(f'{nombre:<25} ERROR {primero["type"]}: {primero["msg"][:60]}')
print('Campos del esquema:', list(Etiqueta.model_json_schema()['properties']))
válida                    OK    tema='música' confianza=0.86 conceptos=['guitarra', 'metrónomo', 'ritmo']
tema fuera de la lista    ERROR literal_error: Input should be 'estadística', 'python', 'historia del arte'
confianza fuera de rango  ERROR less_than_equal: Input should be less than or equal to 1
cortada                   ERROR json_invalid: Invalid JSON: EOF while parsing a string at line 1 column 50
Campos del esquema: ['tema', 'confianza', 'conceptos']
La salida es la mejor explicación de para qué sirve un contrato. De las cuatro respuestas, solo $1$ pasa, y cada una de las otras tres falla por un motivo distinto y con un tipo de error que el programa puede distinguir:
literal_error: el tema “arte” no está en la lista. Es exactamente el problema de la grafía que se mencionó al principio; sin el contrato, “arte” habría entrado ennotas.jsoncomo un quinto tema fantasma.less_than_equal: una confianza de $1.4$ no tiene sentido. El JSON es correcto como JSON, pero no como dato del Cuaderno Vivo.json_invalid: la respuesta se cortó a mitad de una clave. Es lo que ocurre cuandomax_tokenses demasiado pequeño, y ningún esquema puede impedirlo, porque el modelo dejó de escribir.
La última línea de la salida (los campos del esquema) recuerda que el mismo modelo de Pydantic sirve para dos cosas: generar el esquema JSON que se envía a la API y validar lo que vuelve. El contrato se escribe una sola vez y protege en los dos sentidos. Observe además el estilo de las restricciones: Literal se traduce en una lista cerrada de valores en el esquema, y el rango de confianza lo comprueba Pydantic al validar, de modo que un $1.4$ nunca llega a su programa como dato válido.
Validar y recuperarse
Con las salidas estructuradas, la API garantiza que una respuesta completa cumple el esquema. Las dos excepciones son justamente las que ya conoce del Día 4, los dos valores de stop_reason en los que la respuesta no termina con normalidad:
"max_tokens": la respuesta se cortó; el JSON puede quedar incompleto, como la candidata “cortada”. La recuperación razonable es repetir con más margen."refusal": el modelo declinó responder; no hay etiqueta que leer. La recuperación razonable es no reintentar a ciegas, sino marcar la nota para revisión manual.
El siguiente bloque usa client.messages.parse con output_format=Etiqueta. El método envía el esquema, recibe la respuesta y la valida con Pydantic; el objeto validado queda en respuesta.parsed_output. La función etiquetar añade la recuperación: duplica max_tokens si la respuesta se cortó, devuelve un motivo legible si hubo rechazo y captura ValidationError por si una respuesta no pasara la validación local. Al final, recorre las 12 notas y aparta para revisión las que tengan una confianza inferior a $0.6$. Este bloque llama a la API y su salida es un ejemplo:
# Clasificación estructurada con client.messages.parse y recuperación de fallos en Python:
import anthropic

# El cliente lee la clave ANTHROPIC_API_KEY del entorno:
cliente = anthropic.Anthropic()

def etiquetar(nota, k = 3, modelo = 'claude-haiku-5-5', max_tokens = 1024, intentos = 2):
    for intento in range(intentos):
        try:
            respuesta = cliente.messages.parse(
                model = modelo,
                max_tokens = max_tokens,
                system = SISTEMA_ETIQUETA,
                output_config = {'effort': 'low'},
                messages = [{'role': 'user', 'content': prompt_few_shot(k, nota)}],
                output_format = Etiqueta,
            )
        except ValidationError:
            continue  # respuesta fuera del contrato: se repite una vez más
        # Motivo de parada antes de leer el objeto:
        if respuesta.stop_reason == 'refusal':
            return None, 'rechazo'
        if respuesta.stop_reason == 'max_tokens':
            max_tokens *= 2  # respuesta cortada: se repite con más margen
            continue
        return respuesta.parsed_output, respuesta.usage
    return None, 'sin respuesta válida'

etiqueta, uso = etiquetar(datos.loc[9, 'texto'])
print(etiqueta)

# Notas con confianza baja o sin etiqueta van a revisión manual:
revision = []
for fila in datos.itertuples():
    etiqueta, info = etiquetar(fila.texto)
    if etiqueta is None or etiqueta.confianza < 0.6:
        revision.append((fila.id, info if etiqueta is None else etiqueta.confianza))
print('A revisión manual:', revision)

# Salida de ejemplo (puede variar):
# tema='música' confianza=0.83 conceptos=['escala mayor', 'tono', 'semitono']
# A revisión manual: [(12, 0.55)]
En la salida de ejemplo, la nota 10 (la escala mayor, una de las que fallaban sin ejemplos) sale como música, con sus conceptos extraídos de la propia nota. La segunda línea es la parte interesante: la nota 12, la del metrónomo, aparece con una confianza de $0.55$ y se aparta para revisión. El campo de confianza convierte un error silencioso en una duda visible. Sofía revisa a mano una nota de doce en lugar de descubrir semanas después que sus notas de guitarra estaban archivadas como estadística.
Dos advertencias sobre ese campo. La confianza la declara el propio modelo y no es una probabilidad calibrada: un $0.83$ no significa que acierte el $83%$ de las veces. Sirve para ordenar y para apartar casos dudosos, y el umbral de $0.6$ se elige mirando los resultados, no por principio. Y el bucle de las 12 notas hace 12 llamadas: para un lote grande y sin prisa, el Día 23 mostrará cómo enviarlas por lotes a mitad de precio.
Cadenas de prompts
Con el clasificador estructurado, Sofía quiere ir un paso más allá: que cada nota nueva termine convertida en una tarjeta de repaso, una pregunta con su respuesta para estudiar. La primera idea es un prompt gigante que lo haga todo: “extraiga los conceptos, clasifique la nota y redacte una pregunta”. Funciona a veces. Pero cuando falla no se sabe qué parte falló, no se puede validar cada paso y obliga a usar para todo el modelo que necesita la parte más difícil.
La alternativa es una cadena de prompts (prompt chaining): dividir la tarea en eslabones pequeños, cada uno con un prompt corto, un contrato de salida y el modelo justo para su dificultad. La salida validada de un eslabón es la entrada del siguiente. La cadena del Cuaderno Vivo tiene tres:
- Extraer (Haiku 5.5,
effortbajo): hasta tres conceptos clave de la nota, con el contratoConceptos. - Clasificar (Haiku 5.5,
effortbajo): el tema con tres ejemplos y el contratoEtiqueta, usando los conceptos como pista adicional. - Redactar (Sonnet 5.5,
effortmedio): una pregunta de repaso con su respuesta, en dos líneas, sin datos ajenos a la nota.
El reparto de modelos sigue la Tabla A de la serie: Haiku para clasificar y extraer, que son tareas cortas y mecánicas, y Sonnet para redactar, donde la calidad del texto sí se nota. El coste de una cadena es la suma del coste de sus eslabones, cada uno con sus propios tokens y sus propios precios:
$$ C_{\text{cadena}}=\sum_{j=1}^{m}\frac{t_{\text{ent},j}\cdot p_{\text{ent},j}+t_{\text{sal},j}\cdot p_{\text{sal},j}}{10^{6}} $$
La lógica de esta suma es la siguiente:
- Cada eslabón $j$ es una llamada independiente, facturada con los precios del modelo que la atiende ($p_{\text{ent},j}$ y $p_{\text{sal},j}$).
- Los tokens de entrada de cada eslabón incluyen su propio prompt de sistema; repetir contexto en varios eslabones se paga varias veces.
- La suma permite asignar a cada eslabón su parte del coste y optimizar primero el más caro.
- En conclusión, una cadena puede costar menos que una sola llamada si los eslabones baratos hacen el trabajo mecánico y el caro solo interviene donde hace falta.
El siguiente bloque escribe las funciones de la cadena, estima el coste de cada eslabón para la nota 12 y dibuja el diagrama. Las funciones extraer, clasificar y redactar_pregunta llaman a la API cuando se ejecutan, pero el bloque solo las define y no las llama, de modo que corre sin clave. Los tokens de entrada se estiman con estimar_tokens a partir de los textos reales de cada prompt; los de salida ($30$, $40$ y $120$) son supuestos razonables para una lista de tres conceptos, un JSON de etiqueta y una tarjeta de dos líneas:
# Cadena de tres eslabones: funciones, coste estimado y diagrama en Python:
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

class Conceptos(BaseModel):
    conceptos: list[str]

def revisar(respuesta):
    # Ningún eslabón pasa una respuesta incompleta al siguiente:
    if respuesta.stop_reason in ('refusal', 'max_tokens'):
        raise RuntimeError(f'Eslabón detenido: {respuesta.stop_reason}')
    return respuesta

def extraer(nota, cliente):
    # Eslabón 1 (Haiku 5.5): hasta tres conceptos clave:
    r = revisar(cliente.messages.parse(
        model = 'claude-haiku-5-5', max_tokens = 1024, output_config = {'effort': 'low'},
        system = 'Extraiga hasta tres conceptos clave de la nota que va entre etiquetas <nota>.',
        messages = [{'role': 'user', 'content': f'<nota>{nota}</nota>'}], output_format = Conceptos))
    return r.parsed_output.conceptos, r.usage

def clasificar(nota, conceptos, cliente):
    # Eslabón 2 (Haiku 5.5): tema con tres ejemplos y el contrato Etiqueta:
    contenido = prompt_few_shot(3, nota) + f'\n<conceptos>{", ".join(conceptos)}</conceptos>'
    r = revisar(cliente.messages.parse(
        model = 'claude-haiku-5-5', max_tokens = 1024, output_config = {'effort': 'low'},
        system = SISTEMA_ETIQUETA, messages = [{'role': 'user', 'content': contenido}],
        output_format = Etiqueta))
    return r.parsed_output, r.usage

def redactar_pregunta(nota, etiqueta, cliente):
    # Eslabón 3 (Sonnet 5.5): una pregunta de repaso con su respuesta:
    r = revisar(cliente.messages.create(
        model = 'claude-sonnet-5-5', max_tokens = 2048, output_config = {'effort': 'medium'},
        system = ('Usted es el tutor de estudio de Sofía. Con la nota y su tema, redacte una '
                  'pregunta de repaso y su respuesta en dos líneas, sin datos ajenos a la nota.'),
        messages = [{'role': 'user', 'content': f'<tema>{etiqueta.tema}</tema>\n<nota>{nota}</nota>'}]))
    return ''.join(b.text for b in r.content if b.type == 'text').strip(), r.usage

def cadena(nota, cliente):
    # Nota -> conceptos -> etiqueta -> tarjeta de repaso:
    conceptos, uso_1 = extraer(nota, cliente)
    etiqueta, uso_2 = clasificar(nota, conceptos, cliente)
    pregunta, uso_3 = redactar_pregunta(nota, etiqueta, cliente)
    return {'tema': etiqueta.tema, 'conceptos': conceptos, 'pregunta': pregunta, 'usos': [uso_1, uso_2, uso_3]}

# Coste estimado de cada eslabón para la nota 12 (salida supuesta por eslabón):
precios = {'claude-haiku-5-5': (0.10, 0.50), 'claude-sonnet-5-5': (2.00, 10.00), 'claude-fable-5-1': (10.00, 50.00)}
nota_12 = datos.loc[11, 'texto']
eslabones = pd.DataFrame({
    'eslabon': ['extraer', 'clasificar', 'redactar'],
    'modelo': ['claude-haiku-5-5', 'claude-haiku-5-5', 'claude-sonnet-5-5'],
    'tokens_entrada': [estimar_tokens('Extraiga hasta tres conceptos clave de la nota que va entre etiquetas <nota>.') + estimar_tokens(nota_12),
                       estimar_tokens(SISTEMA_ETIQUETA) + estimar_tokens(prompt_few_shot(3, nota_12)) + 12,
                       estimar_tokens('Usted es el tutor de estudio de Sofía. Con la nota y su tema, redacte una pregunta de repaso y su respuesta en dos líneas, sin datos ajenos a la nota.') + estimar_tokens(nota_12) + 6],
    'tokens_salida': [30, 40, 120]
}).set_index('eslabon')
eslabones['coste_usd'] = [(fila.tokens_entrada * precios[fila.modelo][0] + fila.tokens_salida * precios[fila.modelo][1]) / 1e6
                          for fila in eslabones.itertuples()]
pd.set_option('display.float_format', lambda v: f'{v:.7f}')
print(eslabones)
print(f'Total de la cadena: {eslabones["coste_usd"].sum():.7f} USD')

# Diagrama de la cadena con el modelo y el coste en cada caja:
fig, ax = plt.subplots(figsize = (12, 3.6))
ax.set_xlim(0, 12.2)
ax.set_ylim(0, 3.2)
ax.axis('off')
cajas = [(0.2, 'Nota de Sofía\n(texto)', '#f3f2ee'),
         (2.65, 'Extraer\nHaiku 5.5\n{:.6f} USD'.format(eslabones.loc['extraer', 'coste_usd']), '#d2f0e4'),
         (5.1, 'Clasificar\nHaiku 5.5\n{:.6f} USD'.format(eslabones.loc['clasificar', 'coste_usd']), '#d2f0e4'),
         (7.55, 'Redactar\nSonnet 5.5\n{:.6f} USD'.format(eslabones.loc['redactar', 'coste_usd']), '#fde0d3'),
         (10.0, 'Tarjeta de\nrepaso', '#cde2fb')]
for x0, texto, relleno in cajas:
    ax.add_patch(FancyBboxPatch((x0, 1.0), 2.0, 1.3, boxstyle = 'round,pad=0.05,rounding_size=0.12',
                                facecolor = relleno, edgecolor = '#52514e', linewidth = 1.2))
    ax.text(x0 + 1.0, 1.65, texto, ha = 'center', va = 'center', fontsize = 10, color = '#0b0b0b')
for x0, etiqueta_flecha in [(2.2, 'texto'), (4.65, 'conceptos'), (7.1, 'Etiqueta'), (9.55, 'pregunta')]:
    ax.add_patch(FancyArrowPatch((x0 + 0.02, 1.65), (x0 + 0.43, 1.65), arrowstyle = '-|>',
                                 mutation_scale = 14, color = '#52514e', linewidth = 1.3))
    ax.text(x0 + 0.22, 2.45, etiqueta_flecha, ha = 'center', fontsize = 9, color = '#52514e')
ax.text(6.1, 0.45, 'Cada eslabón valida su salida (revisar y Pydantic) antes de pasarla al siguiente.',
        ha = 'center', fontsize = 9, color = '#52514e')
ax.set_title('Cadena de prompts del Cuaderno Vivo', fontsize = 16)
plt.tight_layout()
plt.show()

# Uso (requiere la API y ANTHROPIC_API_KEY): tarjeta = cadena(nota_12, anthropic.Anthropic())
                       modelo  tokens_entrada  tokens_salida  coste_usd
eslabon
extraer      claude-haiku-5-5              51             30  0.0000201
clasificar   claude-haiku-5-5             232             40  0.0000432
redactar    claude-sonnet-5-5              78            120  0.0013560
Total de la cadena: 0.0014193 USD
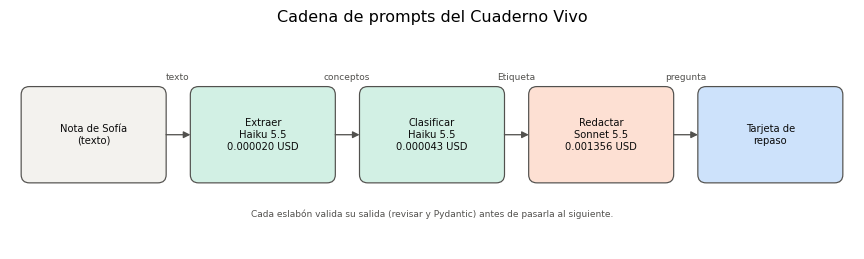
El diagrama muestra el recorrido de una nota: entra como texto, sale de extraer como lista de conceptos, de clasificar como un objeto Etiqueta validado y de redactar_pregunta como la tarjeta final. Cada caja lleva el modelo y su coste estimado, y el color repite el reparto: verde para los eslabones de Haiku 5.5 y naranja para el de Sonnet 5.5. La función revisar es el cinturón de seguridad de la cadena: si un eslabón termina por refusal o por max_tokens, lanza un error en lugar de pasar un dato incompleto al siguiente. En una cadena, un error que no se detiene en su eslabón se propaga y se disfraza: una lista de conceptos cortada produce una etiqueta rara y una pregunta absurda, y desde la tarjeta final es imposible saber dónde empezó el problema.
La Tabla 3 reúne las cifras del bloque.
Tabla 3. Cadena de tres eslabones para la nota 12: modelo, tokens estimados y coste por eslabón.
| Eslabón | Modelo | Effort | Tokens de entrada | Tokens de salida (supuestos) | Coste USD | Parte del total |
|---|---|---|---|---|---|---|
| Extraer | claude-haiku-5-5 | low | 51 | 30 | 0.0000201 | 1.4 % |
| Clasificar | claude-haiku-5-5 | low | 232 | 40 | 0.0000432 | 3.0 % |
| Redactar | claude-sonnet-5-5 | medium | 78 | 120 | 0.0013560 | 95.5 % |
| Cadena completa | Mixto | 361 | 190 | 0.0014193 | 100 % |
La tabla tiene una lectura que se repite en casi todos los sistemas con varios modelos: el coste lo decide el eslabón caro, no el número de eslabones. El eslabón de clasificar tiene el prompt más largo ($232$ tokens, por los tres ejemplos), pero como corre en Haiku 5.5 cuesta $0.0000432$ USD. El de redactar tiene un prompt corto, pero Sonnet 5.5 cobra $20$ veces más por token y la salida es la más larga: se lleva el $95.5%$ del total ($0.0013560$ de $0.0014193$ USD). Si Sofía quisiera abaratar la cadena, recortar ejemplos del clasificador no serviría de casi nada; acortar la tarjeta o probar Haiku 5.5 en la redacción, sí.
Falta la comparación que justifica la cadena: ¿no saldría más barato, o al menos igual, pedirlo todo de una vez? El siguiente código estima el coste de una sola llamada que haga los tres trabajos (el mismo prompt de tres ejemplos con una instrucción combinada y la suma de las tres salidas) con Sonnet 5.5 y con Fable 5.1, y lo compara con la cadena:
# Coste por eslabón frente a una sola llamada a Fable 5.1 en Python:
sistema_unico = ('Extraiga hasta tres conceptos clave de la nota, clasifíquela en uno de cuatro temas '
                 'y redacte una pregunta de repaso con su respuesta. Devuelva todo en JSON.')
t_ent_unico = estimar_tokens(sistema_unico) + estimar_tokens(prompt_few_shot(3, nota_12))
t_sal_unico = int(eslabones['tokens_salida'].sum())
unica = {modelo: (t_ent_unico * p_ent + t_sal_unico * p_sal) / 1e6 for modelo, (p_ent, p_sal) in precios.items()}

comparacion = pd.Series({
    'Extraer (Haiku 5.5)': eslabones.loc['extraer', 'coste_usd'],
    'Clasificar (Haiku 5.5)': eslabones.loc['clasificar', 'coste_usd'],
    'Redactar (Sonnet 5.5)': eslabones.loc['redactar', 'coste_usd'],
    'Cadena completa': eslabones['coste_usd'].sum(),
    'Una llamada (Sonnet 5.5)': unica['claude-sonnet-5-5'],
    'Una llamada (Fable 5.1)': unica['claude-fable-5-1'],
})
print('Tokens de la llamada única:', t_ent_unico, 'de entrada,', t_sal_unico, 'de salida')
print(comparacion.to_string())
print(f'Fable 5.1 cuesta {comparacion.iloc[-1] / comparacion["Cadena completa"]:.1f} veces la cadena')
print(f'600 tarjetas al mes: cadena {600 * comparacion["Cadena completa"]:.3f} USD | '
      f'Fable 5.1 {600 * comparacion.iloc[-1]:.3f} USD')

colores_barras = ['#1baf7a', '#1baf7a', '#eb6834', '#52514e', '#eb6834', '#2a78d6']
fig, ax = plt.subplots(figsize = (8, 4.6))
ax.barh(comparacion.index[::-1], comparacion.values[::-1] * 1000, color = colores_barras[::-1])
for i, valor in enumerate(comparacion.values[::-1] * 1000):
    ax.text(valor + 0.05, i, f'{valor:.3f}', va = 'center', fontsize = 9, color = '#52514e')
ax.set_xlim(0, comparacion.max() * 1000 * 1.18)
ax.set_xlabel('Coste por tarjeta (milésimas de USD)')
ax.set_title('Coste de la cadena frente a una sola llamada', fontsize = 16)
ax.grid(True, axis = 'x', color = '#e6e5e1', linewidth = 0.8)
ax.set_axisbelow(True)
plt.tight_layout()
plt.show()
Tokens de la llamada única: 209 de entrada, 190 de salida
Extraer (Haiku 5.5)        0.0000201
Clasificar (Haiku 5.5)     0.0000432
Redactar (Sonnet 5.5)      0.0013560
Cadena completa            0.0014193
Una llamada (Sonnet 5.5)   0.0023180
Una llamada (Fable 5.1)    0.0115900
Fable 5.1 cuesta 8.2 veces la cadena
600 tarjetas al mes: cadena 0.852 USD | Fable 5.1 6.954 USD
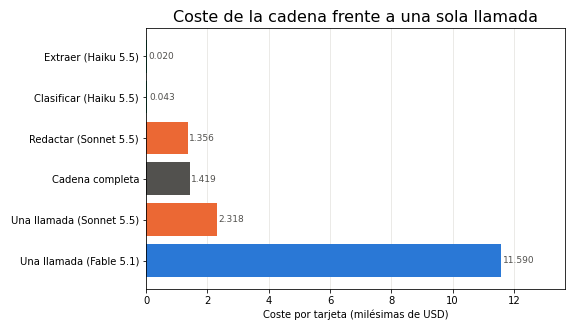
La llamada única ocupa $209$ tokens de entrada, menos que la suma de los tres eslabones ($361$), porque no repite la nota ni las instrucciones tres veces. Aun así, la cadena es más barata: $0.0014193$ USD por tarjeta frente a $0.0023180$ USD de una sola llamada a Sonnet 5.5 y $0.0115900$ USD de una sola llamada a Fable 5.1, que cuesta $8.2$ veces la cadena. La razón está en la fórmula: en la llamada única, todos los tokens, incluidos los de la parte mecánica, se cobran al precio del modelo caro; en la cadena, solo los de la redacción.
Al volumen de Sofía, $600$ tarjetas al mes, la cadena costaría $0.852$ USD y la llamada única a Fable 5.1 $6.954$ USD, casi el $70%$ del presupuesto mensual de 10 USD para una sola función del Cuaderno Vivo. Y la cifra de Fable está subestimada: es el modelo en el que el pensamiento siempre está activo, y sus tokens de pensamiento, que esta estimación no incluye, se cobrarían también a $50$ USD por millón.
En la gráfica, las barras verdes casi no se ven: los dos eslabones de Haiku 5.5 juntos cuestan $0.063$ milésimas de dólar. La barra gris de la cadena completa es apenas más larga que la naranja de la redacción, y la azul de Fable 5.1 domina la figura. Es la versión visual de la Tabla 3: lo que se paga es el modelo, no la cantidad de llamadas.
Diego, fiel a su papel, no se deja impresionar: “Tres llamadas son tres esperas, tres puntos de fallo y tres veces la nota viajando por internet”. Las tres objeciones son ciertas y conviene tenerlas en la balanza. La latencia de la cadena es la suma de las latencias, porque cada eslabón espera al anterior; para una tarjeta de repaso que Sofía leerá mañana da igual, pero para una respuesta en vivo puede no dar igual. Los puntos de fallo son más, pero cada uno está vigilado por revisar y por su contrato, y cuando algo falla se sabe dónde. Y la privacidad no cambia en esencia: la nota sale del equipo una vez o tres, pero hacia el mismo proveedor; lo que sí cambia es que el Día 19 tendrá que filtrar datos personales antes del primer eslabón, no en cada uno.
Comparativa de técnicas
Con todas las piezas sobre la mesa, la Tabla 4 resume cuándo conviene cada técnica. Ninguna es “la mejor”; son herramientas con costes y ventajas distintos, y en un sistema real se combinan (la cadena de hoy usa few-shot, salidas estructuradas y effort a la vez).
Tabla 4. Comparativa de técnicas de prompts para el Cuaderno Vivo.
| Técnica | Qué añade al prompt | Coste relativo | Ventaja principal | Cuándo usarla |
|---|---|---|---|---|
| Zero-shot | Solo la instrucción | El más bajo | Línea base rápida y barata | Siempre como primera prueba; tareas con fronteras evidentes |
| Few-shot | Pares resueltos de entrada y salida | Crece con cada ejemplo | Enseña fronteras y formato a la vez | Cuando zero-shot falla en casos concretos; mida hasta la meseta |
Razonamiento (CoT y effort) | Pensamiento previo a la respuesta | Tokens de pensamiento al precio de salida | Mejora problemas de varios pasos | Lógica, cálculo, planificación; no para clasificar o formatear |
| Salida estructurada | Un esquema (modelo Pydantic) | Casi nulo | Respuestas que el programa puede leer y validar | Siempre que la salida alimente código o se guarde en un archivo |
| Cadena de prompts | Varias llamadas pequeñas encadenadas | Suma de eslabones; baja si se usa el modelo justo | Depuración por eslabón y modelo adecuado a cada paso | Tareas compuestas con partes mecánicas y partes difíciles |
Lea la tabla como una secuencia de decisiones más que como un catálogo. Empiece en zero-shot y mida. Si falla, mire la matriz de confusión y añada ejemplos donde están los errores, hasta que la exactitud deje de subir. Si la salida va a ser leída por un programa, pida una salida estructurada desde el primer día; no hay ningún motivo para dejarlo para después. Suba effort solo cuando la tarea tenga pasos de razonamiento de verdad. Y cuando un prompt empiece a hacer tres cosas a la vez, pártalo en una cadena y asigne a cada eslabón el modelo más barato que lo resuelva bien.
Consideraciones finales
La tentación al descubrir el few-shot es pensar que más ejemplos siempre ayudan, y la entrada de hoy muestra con números que no es así. De tres a cinco ejemplos la exactitud no se movió, el coste subió y la frontera se desplazó hacia un error nuevo. Lo mismo vale para el pensamiento (más effort en una clasificación es gasto sin retorno) y para las cadenas (más eslabones no son mejores si cada uno repite contexto). La técnica no sustituye a la medida: cada decisión de prompt es una hipótesis que se comprueba con un conjunto de prueba, una métrica y su coste.
Las cifras de hoy tienen límites que conviene no olvidar. Las predicciones son de juguete, fijadas en el código para que la entrada sea reproducible; sirven para aprender a leer una tabla de exactitud y una matriz de confusión, no para afirmar cómo se comporta Claude Haiku 5.5 con estas notas. Los tokens son estimaciones con una regla de caracteres, no conteos del tokenizador real. Y doce notas son pocas: la diferencia entre dos configuraciones puede ser de una sola nota. Antes de tomar una decisión que dure, conviene preguntarse:
- ¿Mi conjunto de prueba se parece a las notas que de verdad escribiré mañana, en temas, longitud y estilo?
- ¿Alguno de mis ejemplos aparece también en el conjunto de prueba?
- ¿La mejora que veo es mayor que la incertidumbre de medir con tan pocos casos?
- ¿Qué parte del coste de cada consulta se va en ejemplos, en pensamiento y en el modelo elegido?
Un gran libro que habla de esto es Prompt Engineering for LLMs: The Art and Science of Building Large Language Model-Based Applications (2024), en el que John Berryman y Albert Ziegler, que trabajaron en GitHub Copilot, tratan el prompt como una pieza de ingeniería: cómo elegir y ordenar ejemplos, cómo pedir formatos que el programa pueda leer, cómo dividir una tarea en varios pasos y, sobre todo, cómo evaluar cada cambio en lugar de fiarse de la intuición. Es la continuación natural de lo que la serie hace en este módulo.
Un ejemplo en el prompt no es un adorno, es un dato de entrenamiento que usted paga en cada consulta. Elíjalo por la frontera que enseña, mida lo que aporta y retírelo cuando deje de aportar; y cuando la respuesta tenga que entenderla un programa, no la pida en prosa: pídala con un contrato.
Conclusiones clave
Ejemplos
- Zero-shot es la línea base; en el ejemplo de juguete acierta $8$ de $12$ notas ($0.667$) y todos sus errores caen en estadística, el tema “imán”.
- Con tres ejemplos la exactitud llega a $0.917$; con cinco no mejora, cuesta $78.6$ tokens más por consulta y un caso frontera desplaza el error a otra nota.
- La matriz de confusión dice dónde falla el clasificador: con tres ejemplos, el único error es una nota de música (sensibilidad $0.67$).
- Los ejemplos nunca salen del conjunto de prueba y deben cubrir todas las clases y su variedad real, porque también transmiten sesgos.
Estructura
- En los modelos actuales de Claude no hay prefill: un último turno de asistente devuelve 400, y el JSON se pide con salidas estructuradas.
client.messages.parsecon un modelo Pydantic envía el esquema y devuelve el objeto validado enparsed_output.- El contrato no evita las respuestas cortadas ni los rechazos: compruebe
stop_reasony recupérese con másmax_tokenso con revisión manual. - El razonamiento se regula con
effort, no conbudget_tokens; los tokens de pensamiento se cobran como salida, así que se reserva para tareas de varios pasos.
Cadenas
- Una cadena divide la tarea en eslabones con su propio prompt, contrato y modelo, y su coste es la suma de los eslabones.
- En la cadena del Cuaderno Vivo, la redacción con Sonnet 5.5 se lleva el $95.5%$ del coste; optimice primero el eslabón caro.
- La cadena cuesta $0.852$ USD por $600$ tarjetas, frente a $6.954$ USD de una sola llamada a Fable 5.1: el modelo pesa más que el número de llamadas.
Mañana, en el Día 7: Memoria persistente: historial, perfiles y recuperación (RAG). La API no recuerda nada entre llamadas, así que el Cuaderno Vivo aprenderá a guardar lo que importa y a recuperar, entre sus notas ya etiquetadas, solo las pocas que cada pregunta necesita.
Referencias
- Wei, J., Wang, X., Schuurmans, D., Bosma, M., Ichter, B., Xia, F., Chi, E., Le, Q. y Zhou, D. (2022). Chain-of-Thought Prompting Elicits Reasoning in Large Language Models. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://arxiv.org/abs/2201.11903
- Kojima, T., Gu, S. S., Reid, M., Matsuo, Y. e Iwasawa, Y. (2022). Large Language Models are Zero-Shot Reasoners. Advances in Neural Information Processing Systems 35 (NeurIPS 2022). https://arxiv.org/abs/2205.11916
- Anthropic (2026). Structured outputs. Documentación de Claude. https://platform.claude.com/docs
- Brown, T. et al. (2020). Language Models are Few-Shot Learners. Advances in Neural Information Processing Systems 33. https://arxiv.org/abs/2005.14165
- Zhao, T. Z., Wallace, E., Feng, S., Klein, D. y Singh, S. (2021). Calibrate Before Use: Improving Few-Shot Performance of Language Models. Proceedings of the 38th International Conference on Machine Learning (ICML 2021). https://arxiv.org/abs/2102.09690
- Lu, Y., Bartolo, M., Moore, A., Riedel, S. y Stenetorp, P. (2022). Fantastically Ordered Prompts and Where to Find Them: Overcoming Few-Shot Prompt Order Sensitivity. Proceedings of the 60th Annual Meeting of the Association for Computational Linguistics (ACL 2022). https://arxiv.org/abs/2104.08786
- Berryman, J. y Ziegler, A. (2024). Prompt Engineering for LLMs: The Art and Science of Building Large Language Model-Based Applications. O’Reilly Media.