IA generativa en proyectos personales: Día 9
 Jeshua Romero Guadarrama
- 47 Min para leer
- 09 Jan, 2026
Índice de contenido
Resumen:
Los generadores de imágenes actuales no pintan: parten de ruido aleatorio y lo van quitando paso a paso hasta que aparece una forma. En esta entrada se desmonta ese mecanismo, llamado difusión, con numpy y sin GPU: el proceso directo que destruye una imagen, los calendarios de ruido lineal y coseno, la relación señal-ruido, el proceso inverso guiado por la puntuación de los datos y la difusión latente que usan SDXL y FLUX.1. Al terminar, usted sabrá leer las fórmulas de un modelo de difusión, simularlas sobre una imagen de juguete de 32×32 píxeles y estimar si un modelo real cabe en su laptop.
¿Cómo citar el presente artículo?
Romero, J. (9 de enero de 2026). IA generativa en proyectos personales: Día 9. python-data-engineer. https://www.python-data-engineer.com/post/iag/dia_9/.
IA generativa en proyectos personales: Día 9 by Jeshua Romero Guadarrama, available under Attribution 4.0 International (CC BY 4.0) at https://www.python-data-engineer.com/post/iag/dia_9/.
Modelos, precios y regulación revisados en octubre de 2026.
Día 9. Cómo nace una imagen: del ruido a la forma con difusión
Introducción
Ayer, en el Día 8, ensambló el prompt de sistema, la memoria, la recuperación y las salidas estructuradas en un tutor que programa repasos con las cajas de Leitner y cuesta menos de un dólar al mes, y el Cuaderno Vivo ganó su primera pieza persistente: cuaderno_v1.py, con las órdenes tarjetas y repasar. Hoy comienza el módulo 3/6: IA Visual (Text-to-Image) y Estética, en el que el Cuaderno Vivo aprenderá a ver y a producir imágenes.
Sofía dibuja en los márgenes de sus apuntes desde que era niña, y quiere que cada semana del Cuaderno Vivo abra con una portada: una imagen que resuma de qué trató la semana, con una paleta y una composición reconocibles. Ya probó un par de generadores de imágenes en el navegador y le sorprendió lo rápido que aparece algo bonito, pero también lo difícil que es obtener lo que tenía en la cabeza. Diego, como siempre, llega con dos preguntas: ¿Qué está haciendo esa máquina por dentro? y ¿Cabe en su laptop o tendrá que pagar por cada portada? La primera es la que responde esta entrada; la segunda, con cifras, se cierra en el Día 11.
La respuesta corta a la primera pregunta sorprende a casi todo el mundo: un modelo de difusión no dibuja, quita ruido. Durante el entrenamiento ve millones de imágenes a las que se les ha añadido ruido en distintas cantidades, y aprende a estimar qué parte de lo que ve es ruido. Para generar, parte de una imagen hecha solo de ruido aleatorio y le aplica esa estimación muchas veces seguidas; con cada paso la imagen se vuelve un poco menos caótica, hasta que aparece una forma.
En la presente entrada, descubrirá las dos mitades de ese mecanismo. Verá el proceso directo, que destruye una imagen añadiendo ruido gaussiano según un calendario, y lo calculará con dos calendarios distintos, el lineal y el coseno, comparándolos con la relación señal-ruido. Simulará con numpy cómo se disuelve una imagen de juguete de 32×32 píxeles con un círculo y un cuadrado. Después estudiará el proceso inverso con un caso en una dimensión donde el desruidor perfecto se conoce con una fórmula, y verá a 50 partículas viajar desde el ruido puro hasta los dos modos de los datos. Por último, ubicará las piezas de un modelo real (autoencoder, desruidor y codificador de texto), entenderá por qué trabajan en un espacio comprimido y estimará cuánta memoria piden SDXL y FLUX.1 schnell. La pieza que gana hoy el Cuaderno Vivo no es todavía una portada, sino algo previo y más duradero: el modelo mental que explica cada parámetro que Sofía ajustará mañana.
Objetivos de aprendizaje
Al terminar esta entrada, usted podrá:
- Explicar el proceso directo de difusión (añadir ruido) y el inverso (quitarlo) con sus fórmulas.
- Comparar calendarios de ruido lineal y coseno mediante $\bar{\alpha}_t$ y la relación señal-ruido.
- Simular la difusión de una imagen de juguete de 32×32 píxeles con numpy.
- Ubicar las piezas de un modelo real: autoencoder (espacio latente), red de eliminación de ruido (U-Net o transformador) y codificador de texto.
La idea: destruir para aprender a construir
Piense en una gota de tinta que cae en un vaso de agua. Al principio la gota tiene una forma nítida; segundos después se deshace en hilos; al cabo de un minuto el agua tiene un tono uniforme y ya no queda rastro de la forma original. Ese proceso físico se llama difusión, y tiene una propiedad que lo hace útil: es fácil de simular hacia adelante. Cualquiera puede escribir el código que lleva de la gota al agua turbia. Lo difícil es el camino de vuelta: dado un vaso de agua uniformemente teñida, reconstruir la gota.
Los modelos de difusión, propuestos por Sohl-Dickstein y sus coautores en 2015 y popularizados por Ho, Jain y Abbeel en 2020, toman esa asimetría y la convierten en un método de aprendizaje. El razonamiento tiene tres pasos:
- Destruir una imagen es trivial: basta con sumarle ruido gaussiano en pequeñas dosis, muchas veces. Después de unos mil pasos, de la imagen solo queda ruido.
- Si el ruido se añadió en dosis pequeñas, cada paso individual es casi reversible: la imagen del paso $t-1$ se parece mucho a la del paso $t$. Deshacer un paso pequeño es un problema mucho más fácil que deshacer mil de golpe.
- Una red neuronal puede aprender a deshacer ese paso pequeño, porque durante el entrenamiento se conoce exactamente qué ruido se añadió. Una vez entrenada, se encadenan mil pasos inversos partiendo de ruido puro, y aparece una imagen nueva.
Fíjese en lo que esto tiene de ingenioso: el problema de “inventar una imagen” se ha convertido en una secuencia de problemas de regresión supervisada, cada uno con su respuesta correcta conocida. No hace falta que nadie etiquete nada; las propias imágenes, más el ruido que el programa añade, generan los ejemplos de entrenamiento.
Antes de la difusión existían ya otras dos familias de modelos generativos de imágenes, y conviene situarlas para entender por qué la difusión se impuso hacia 2022. La red generativa antagónica (o GAN, por sus siglas en inglés: “Generative Adversarial Network”), propuesta por Goodfellow y sus coautores en 2014, enfrenta a dos redes: un generador que fabrica imágenes y un discriminador que intenta distinguirlas de las reales. El autocodificador variacional (o VAE, por sus siglas en inglés: “Variational Autoencoder”), de Kingma y Welling (2013), comprime cada imagen en un vector de pocas dimensiones y aprende a reconstruirla desde ahí. La Tabla 1 resume las tres familias.
Tabla 1. GAN, VAE y difusión: idea central, ventajas y problemas típicos.
| Familia | Idea central | Ventajas | Problemas típicos |
|---|---|---|---|
| GAN (2014) | Un generador engaña a un discriminador | Muestreo en un solo paso, imágenes nítidas | Entrenamiento inestable; colapso de modos (genera pocas variantes) |
| VAE (2013) | Codificar en un espacio latente y decodificar | Entrenamiento estable, espacio latente útil | Imágenes borrosas cuando se usa solo |
| Difusión (2015, 2020) | Aprender a quitar ruido paso a paso | Entrenamiento estable, gran diversidad y calidad | Muestreo lento (muchos pasos), mucho cómputo |
La lectura de la tabla deja una lección que se repetirá durante todo el módulo: ninguna familia gana en todo. Las GAN generan en un solo paso, pero su entrenamiento es un duelo que puede no converger, y tienden a olvidar parte de la variedad de los datos; es el llamado colapso de modos. Los VAE entrenan con calma, pero sus imágenes salen borrosas porque su función de pérdida premia el promedio. La difusión hereda la estabilidad de un problema de regresión y, como cada paso solo corrige un poco, puede cubrir toda la variedad de los datos; el precio es que generar exige repetir la red decenas o cientos de veces.
Observe también que la tabla no es una competencia cerrada. Los modelos actuales combinan familias: Stable Diffusion, SDXL y FLUX.1 usan un autocodificador (pariente del VAE) para comprimir la imagen y aplican la difusión dentro de ese espacio comprimido; y varios métodos para reducir el número de pasos se apoyan en ideas de las GAN. Volverá a ver esta combinación en la sección de difusión latente.
El proceso directo
El proceso directo es la mitad fácil: la que destruye. Se define como una cadena de $T$ pasos en la que, en cada paso $t$, la imagen se encoge un poco y se le suma ruido gaussiano de varianza $\beta_t$. A la secuencia $\beta_1, \beta_2, \ldots, \beta_T$ se le llama calendario de ruido (en inglés, “noise schedule”), y es la primera decisión de diseño de cualquier modelo de difusión.
Encadenar mil pasos parece costoso, pero tiene un atajo. Como la suma de variables gaussianas independientes es otra gaussiana, se puede saltar directamente de la imagen original $x_0$ a la imagen ruidosa del paso $t$ sin pasar por los intermedios:
$$ q(x_t \mid x_0) = \mathcal{N}!\left(\sqrt{\bar{\alpha}_t},x_0,,(1-\bar{\alpha}_t)\mathbf{I}\right), \qquad \bar{\alpha}t = \prod{s=1}^{t}(1-\beta_s) $$
La lógica detrás de esta fórmula es múltiple:
- $\alpha_s = 1 - \beta_s$ es la fracción de varianza que conserva la señal en el paso $s$. Como cada $\beta_s$ es pequeño, cada $\alpha_s$ está muy cerca de $1$, pero el producto de mil números ligeramente menores que $1$ puede ser diminuto.
- $\bar{\alpha}_t$ (se lee “alfa barra”) es, por tanto, la fracción de la señal original que sobrevive en el paso $t$. Empieza en $1$ y cae hacia $0$.
- La media $\sqrt{\bar{\alpha}_t},x_0$ dice que la imagen no se borra de golpe: se atenúa. La varianza $1-\bar{\alpha}_t$ dice que el ruido ocupa el hueco que deja la señal, de modo que la varianza total se mantiene cerca de $1$ si los píxeles ya estaban normalizados.
- $\mathbf{I}$ es la matriz identidad: cada píxel recibe su propio ruido, independiente del de sus vecinos.
- En conclusión, todo el proceso directo queda resumido en un solo número por paso, $\bar{\alpha}_t$, y comparar calendarios es comparar curvas de $\bar{\alpha}_t$.
En la práctica, la fórmula se usa en su forma de muestreo, que es la que aparecerá en el código:
$$ x_t = \sqrt{\bar{\alpha}_t},x_0 + \sqrt{1-\bar{\alpha}_t},\epsilon, \qquad \epsilon \sim \mathcal{N}(0, \mathbf{I}) $$
Es una mezcla ponderada de la imagen y de ruido puro, con pesos que dependen solo de $t$. Comencemos por preparar el entorno con las importaciones base y la semilla global de la serie, $2026$. Este día no necesita las notas de Sofía ni la API: todo el código que produce cifras y figuras corre con numpy, pandas y matplotlib en cualquier laptop:
# Importaciones base y semilla del día en Python:
import warnings
warnings.filterwarnings('ignore')
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt

# Generador aleatorio con la semilla global de la serie:
rng = np.random.default_rng(2026)
pd.set_option('display.width', 120)
plt.rcParams.update({'figure.facecolor': '#fcfcfb', 'axes.facecolor': '#fcfcfb',
                     'axes.edgecolor': '#52514e', 'axes.labelcolor': '#0b0b0b',
                     'xtick.color': '#52514e', 'ytick.color': '#52514e',
                     'axes.spines.top': False, 'axes.spines.right': False})
AZUL, NARANJA = '#2a78d6', '#eb6834'   # lineal y coseno en todas las figuras
print('numpy', np.__version__, '| pandas', pd.__version__, '| matplotlib', matplotlib.__version__)
numpy 2.4.6 | pandas 3.0.3 | matplotlib 3.10.9
La salida confirma las versiones con las que se ejecutaron todas las cifras de esta entrada. Las dos constantes AZUL y NARANJA fijan un color para cada calendario: el lineal será siempre azul y el coseno siempre naranja, en todas las figuras del día.
Calendario lineal
El calendario de Ho, Jain y Abbeel (2020) es el más sencillo posible: $T = 1000$ pasos y $\beta_t$ creciendo en línea recta desde $\beta_1 = 10^{-4}$ hasta $\beta_T = 0.02$. La idea es añadir muy poco ruido al principio, cuando la imagen todavía es nítida y cualquier perturbación se nota, y más al final, cuando ya casi todo es ruido.
El calendario coseno, que se presenta en el siguiente apartado, se calcula en el mismo bloque para poder compararlos en una sola tabla. El siguiente código construye ambos, calcula $\bar{\alpha}_t$ con un producto acumulado y lo imprime en cinco pasos:
# Calendarios de ruido lineal y coseno en Python:
T = 1000

def calendario_lineal(T, beta_inicio = 1e-4, beta_fin = 0.02):
    return np.linspace(beta_inicio, beta_fin, T)

def calendario_coseno(T, s = 0.008):
    t = np.arange(T + 1)
    f = np.cos((t / T + s) / (1 + s) * np.pi / 2) ** 2
    alpha_bar = f / f[0]
    # Nichol y Dhariwal recortan beta en 0.999 para evitar la singularidad en t = T:
    return np.clip(1 - alpha_bar[1:] / alpha_bar[:-1], 0, 0.999)

def alpha_acumulada(betas):
    # alpha_bar[t] para t = 0, 1, ..., T; en t = 0 la imagen está intacta:
    return np.concatenate([[1.0], np.cumprod(1 - betas)])

betas_lineal, betas_coseno = calendario_lineal(T), calendario_coseno(T)
alpha_bar_lineal = alpha_acumulada(betas_lineal)
alpha_bar_coseno = alpha_acumulada(betas_coseno)

# Tabla 2: alpha_bar en cinco pasos para ambos calendarios:
pasos = [1, 250, 500, 750, 1000]
tabla_2 = pd.DataFrame({'t': pasos,
                        'alpha_bar_lineal': alpha_bar_lineal[pasos],
                        'alpha_bar_coseno': alpha_bar_coseno[pasos]})
print(tabla_2.to_string(index = False, float_format = lambda v: f'{v:.5g}'))
print('beta lineal en t = 1 y t = T:', betas_lineal[0], betas_lineal[-1])
print('beta coseno en t = 1 y t = T:', round(betas_coseno[0], 6), betas_coseno[-1])
   t  alpha_bar_lineal  alpha_bar_coseno
   1            0.9999           0.99996
 250           0.52409           0.84701
 500          0.078587           0.49384
 750         0.0033506           0.14427
1000        4.0358e-05        2.4288e-09
beta lineal en t = 1 y t = T: 0.0001 0.02
beta coseno en t = 1 y t = T: 4.1e-05 0.999
Para el calendario lineal, la salida reproduce los valores calculados al planear la serie: $\bar{\alpha}1 = 0.9999$, $\bar{\alpha}{250} = 0.524$, $\bar{\alpha}{500} = 0.0786$, $\bar{\alpha}{750} = 0.00335$ y $\bar{\alpha}_{1000} = 0.0000404$. Dicho en palabras: a un cuarto del camino ya se perdió casi la mitad de la señal, y a la mitad del camino solo sobrevive un $7.9%$. La segunda mitad del calendario lineal, de $t = 500$ a $t = 1000$, trabaja sobre una imagen que ya es casi todo ruido.
Observe un detalle de implementación: la función alpha_acumulada antepone un $1$ al producto acumulado, de modo que alpha_bar[t] corresponde exactamente al paso $t$ de las fórmulas y alpha_bar[0] es la imagen intacta. Muchas bibliotecas indexan desde $0$ sin ese $1$ inicial, y confundir ambos convenios desplaza todo el calendario un paso, un error silencioso que conviene evitar desde el principio.
Calendario coseno
Nichol y Dhariwal (2021) observaron que el calendario lineal destruye la información demasiado pronto: en imágenes pequeñas, como las de 32×32 píxeles, los últimos cientos de pasos son ruido casi puro y aportan poco al entrenamiento. Propusieron entonces diseñar directamente la curva de $\bar{\alpha}_t$, en lugar de las $\beta_t$, con una forma de coseno al cuadrado:
$$ \bar{\alpha}_t = \frac{f(t)}{f(0)}, \qquad f(t) = \cos^2!\left(\frac{t/T + s}{1+s}\cdot\frac{\pi}{2}\right), \qquad s = 0.008 $$
La lógica detrás de esta fórmula es múltiple:
- $\cos^2$ vale $1$ en $0$ y $0$ en $\pi/2$; al recorrer $t$ de $0$ a $T$, el argumento va casi de $0$ a $\pi/2$ y $\bar{\alpha}_t$ baja de $1$ a $0$.
- La forma de coseno hace que la caída sea lenta al principio, casi lineal en el centro y lenta otra vez al final, en lugar de desplomarse en la primera mitad.
- El desplazamiento $s = 0.008$ evita que $\beta_t$ sea demasiado pequeño cerca de $t = 0$, donde una señal casi intacta haría que la red tuviera que predecir un ruido minúsculo.
- Dividir entre $f(0)$ garantiza que $\bar{\alpha}_0 = 1$ exactamente.
- Como en $t = T$ el coseno vale cero, la $\beta_T$ correspondiente sería $1$ y el paso dejaría de ser invertible; por eso los autores recortan cada $\beta_t$ en $0.999$. Ese es el
np.clipdel Bloque 2.
En la salida anterior, la columna del coseno cuenta otra historia: en $t = 250$ sobrevive el $84.7%$ de la señal y en $t = 500$ todavía el $49.4%$, casi exactamente la mitad. El recorte de $0.999$ se ve en la última línea: la $\beta$ del último paso del coseno es precisamente $0.999$, frente al $0.02$ del lineal. La gráfica de la Figura 1 lo hace visible; la genera el siguiente código:
# Gráfico de alpha_bar frente a t para ambos calendarios en Python:
t = np.arange(T + 1)
fig, ax = plt.subplots(figsize = (8, 4.5))
ax.plot(t, alpha_bar_lineal, color = AZUL, linewidth = 2, label = 'Lineal (Ho et al., 2020)')
ax.plot(t, alpha_bar_coseno, color = NARANJA, linewidth = 2, label = 'Coseno (Nichol y Dhariwal, 2021)')
ax.axhline(0.5, color = '#9a9994', linewidth = 1, linestyle = ':')
ax.text(1000, 0.52, 'mitad señal, mitad ruido', ha = 'right', color = '#52514e', fontsize = 9)
ax.set_title(r'Señal que sobrevive: $\bar{\alpha}_t$ frente a $t$', fontsize = 16)
ax.set_xlabel('Paso de difusión $t$')
ax.set_ylabel(r'$\bar{\alpha}_t$')
ax.grid(alpha = 0.25)
ax.legend(frameon = False)
plt.tight_layout()
cruce_lineal = int(np.argmax(alpha_bar_lineal < 0.5))
cruce_coseno = int(np.argmax(alpha_bar_coseno < 0.5))
print('Primer t con alpha_bar < 0.5: lineal', cruce_lineal, '| coseno', cruce_coseno)

# Curvas de alpha_bar de los calendarios lineal y coseno:
plt.show()
Primer t con alpha_bar < 0.5: lineal 260 | coseno 497
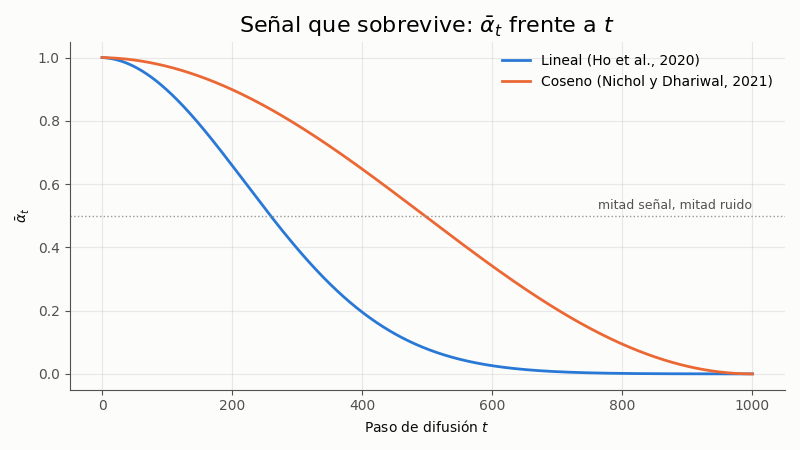
El gráfico anterior muestra las dos curvas. La azul (lineal) cae deprisa y cruza la línea de $0.5$ en $t = 260$; la naranja (coseno) baja con suavidad y la cruza en $t = 497$, justo a la mitad del calendario. Esa diferencia tiene una consecuencia práctica: con el calendario coseno, el modelo pasa aproximadamente el mismo número de pasos en la zona “más señal que ruido” que en la zona “más ruido que señal”, y por eso aprende mejor los detalles finos de imágenes pequeñas.
Relación señal-ruido
$\bar{\alpha}_t$ mide la señal, pero lo que de verdad importa al desruidor es cuánta señal hay en comparación con el ruido. Esa comparación se llama relación señal-ruido (o SNR, por sus siglas en inglés: “Signal-to-Noise Ratio”):
$$ \text{SNR}(t) = \frac{\bar{\alpha}_t}{1-\bar{\alpha}_t} $$
La lógica detrás de esta fórmula es múltiple:
- El numerador es la varianza de la señal en $x_t$ y el denominador la varianza del ruido; ambas salen directamente de $q(x_t \mid x_0)$.
- $\text{SNR}(t) = 1$ significa mitad señal y mitad ruido, es decir, $\bar{\alpha}_t = 0.5$.
- La SNR abarca muchos órdenes de magnitud (de miles a millonésimas), así que se grafica en escala logarítmica: $\log_{10}\text{SNR} = 0$ es el punto de equilibrio, valores positivos indican que domina la señal y negativos que domina el ruido.
- En conclusión, un calendario es una forma de repartir los pasos entre niveles de SNR, y comparar calendarios en esta escala muestra dónde concentra cada uno su esfuerzo.
Puede calcular y graficar la SNR de ambos calendarios con el siguiente código:
# Relación señal-ruido en escala logarítmica en Python:
def snr(alpha_bar):
    return alpha_bar / (1 - alpha_bar)

t_pos = t[1:]   # en t = 0 la SNR es infinita
log_snr_lineal = np.log10(snr(alpha_bar_lineal[1:]))
log_snr_coseno = np.log10(snr(alpha_bar_coseno[1:]))
fig, ax = plt.subplots(figsize = (8, 4.5))
ax.plot(t_pos, log_snr_lineal, color = AZUL, linewidth = 2, label = 'Lineal')
ax.plot(t_pos, log_snr_coseno, color = NARANJA, linewidth = 2, label = 'Coseno')
ax.axhline(0, color = '#9a9994', linewidth = 1, linestyle = ':')
ax.set_title('Relación señal-ruido a lo largo de la difusión', fontsize = 16)
ax.set_xlabel('Paso de difusión $t$')
ax.set_ylabel(r'$\log_{10}\,\mathrm{SNR}(t)$')
ax.grid(alpha = 0.25)
ax.legend(frameon = False)
plt.tight_layout()
for nombre, valores in [('lineal', log_snr_lineal), ('coseno', log_snr_coseno)]:
    print(f'{nombre}: log10 SNR en t = 1: {valores[0]:.2f} | t = 500: {valores[499]:.2f} | t = 1000: {valores[-1]:.2f}')
print(f'Pasos con más señal que ruido: lineal {(log_snr_lineal > 0).sum()} | coseno {(log_snr_coseno > 0).sum()}')

# Caída de la SNR en escala logarítmica para ambos calendarios:
plt.show()
lineal: log10 SNR en t = 1: 4.00 | t = 500: -1.07 | t = 1000: -4.39
coseno: log10 SNR en t = 1: 4.38 | t = 500: -0.01 | t = 1000: -8.61
Pasos con más señal que ruido: lineal 259 | coseno 496
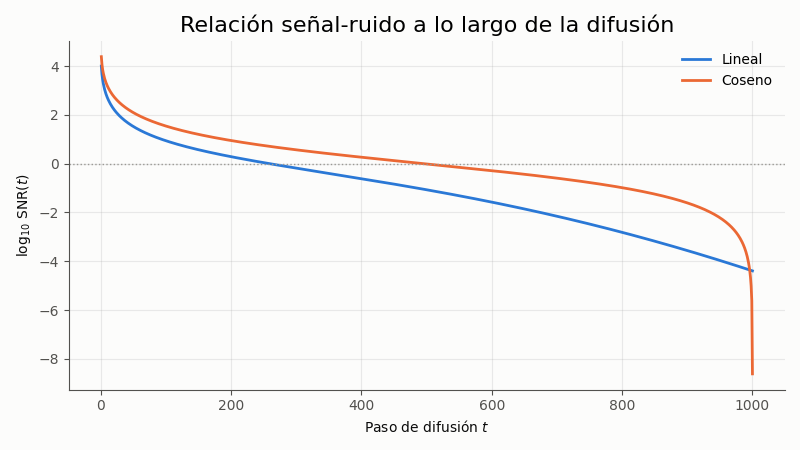
Las cifras confirman lo que sugiere la Figura 2. Ambos calendarios empiezan con una SNR de unos $10^{4}$ (señal diez mil veces mayor que el ruido), pero el lineal pasa solo $259$ pasos con más señal que ruido, frente a $496$ del coseno. En $t = 500$, el lineal ya está en $\log_{10}\text{SNR} = -1.07$ (el ruido es unas $12$ veces la señal), mientras que el coseno está prácticamente en el equilibrio, $-0.01$.
El final de las curvas merece atención. El coseno se desploma en los últimos pasos hasta $10^{-8.61}$ por efecto del recorte en $0.999$: su último paso es casi ruido puro. El lineal, en cambio, se queda en $10^{-4.39}$: nunca llega del todo al ruido puro. Con $\bar{\alpha}{1000} = 0.0000404$, en $x{1000}$ queda todavía un factor $\sqrt{0.0000404} = 0.0064$ de la imagen original. Parece despreciable, y para este calendario lo es en la práctica, pero el fenómeno tiene nombre propio y consecuencias en modelos reales.
Atención aquí: Un calendario cuya SNR final no es cero deja una “fuga de señal”: durante el entrenamiento, la imagen más ruidosa todavía contiene un rastro de la original (sobre todo su brillo medio), pero al generar se parte de ruido puro, sin ese rastro. Lin y sus coautores (2024) mostraron que varios calendarios de uso común, entre ellos el de Stable Diffusion 1.x, tienen este defecto, y que por eso esos modelos tienden a generar imágenes de brillo medio y no consiguen fondos totalmente negros o blancos. Si algún día entrena o ajusta un modelo, compruebe que $\bar{\alpha}_T$ es lo bastante pequeño para el tamaño de sus imágenes.
Una imagen de juguete que se disuelve
Las curvas de $\bar{\alpha}_t$ son abstractas; veamos qué le hacen a una imagen. Sofía dibujó en una hoja cuadriculada de 32×32 casillas dos figuras sencillas: un círculo blanco arriba a la izquierda y un cuadrado gris claro abajo a la derecha, sobre fondo negro. Es una imagen deliberadamente pobre: así se ve con claridad qué sobrevive al ruido y qué no.
Los modelos de difusión trabajan con píxeles normalizados al intervalo $[-1, 1]$, de modo que el negro vale $-1$ y el blanco $1$. El siguiente código construye la imagen con np.meshgrid, que da a cada casilla su fila y su columna, y con dos máscaras booleanas, una para el círculo y otra para el cuadrado:
# Imagen de juguete de 32 x 32: un círculo y un cuadrado en Python:
lado = 32
filas, columnas = np.meshgrid(np.arange(lado), np.arange(lado), indexing = 'ij')
x0 = np.full((lado, lado), -1.0)                     # fondo negro
circulo = (filas - 11) ** 2 + (columnas - 11) ** 2 <= 7 ** 2
cuadrado = (filas >= 17) & (filas <= 27) & (columnas >= 17) & (columnas <= 27)
x0[circulo] = 1.0                                    # círculo blanco
x0[cuadrado] = 0.3                                   # cuadrado gris claro
valores, cuentas = np.unique(x0, return_counts = True)
print('Forma:', x0.shape, '| píxeles por valor:', dict(zip(valores.tolist(), cuentas.tolist())))
print(f'Media: {x0.mean():.4f} | desviación: {x0.std():.4f}')

# Vista rápida en 8 x 8 (promedio de bloques de 4 x 4 píxeles):
reducida = x0.reshape(8, 4, 8, 4).mean(axis = (1, 3))
for fila in reducida:
    print(''.join('#' if v > 0.5 else '+' if v > -0.5 else '.' for v in fila))
Forma: (32, 32) | píxeles por valor: {-1.0: 754, 0.3: 121, 1.0: 149}
Media: -0.5554 | desviación: 0.7642
........
..#+....
.###+...
.+##+...
..+++++.
....+++.
....+++.
........
La imagen tiene $754$ píxeles de fondo, $149$ de círculo y $121$ de cuadrado (un cuadrado de $11 \times 11$). Su media es $-0.555$ porque domina el fondo negro, y su desviación estándar es $0.764$. La vista reducida de 8×8 caracteres (# para zonas claras, + para intermedias y . para oscuras) confirma que las dos figuras están donde Sofía las dibujó.
Ahora llega el proceso directo. La función difundir aplica la forma de muestreo $x_t = \sqrt{\bar{\alpha}_t},x_0 + \sqrt{1-\bar{\alpha}_t},\epsilon$ en un solo salto, sin recorrer los pasos intermedios, y devuelve también el ruido $\epsilon$ que usó (que, como verá en la sección siguiente, es justo lo que la red aprende a predecir). El código la aplica en cinco pasos con cada calendario, imprime la correlación entre la imagen ruidosa y la original, y dibuja la rejilla de la Figura 3:
# Proceso directo en un solo salto y rejilla de 2 x 5 en Python:
def difundir(x0, t, alpha_bar, rng):
    epsilon = rng.standard_normal(x0.shape)
    xt = np.sqrt(alpha_bar[t]) * x0 + np.sqrt(1 - alpha_bar[t]) * epsilon
    return xt, epsilon

pasos_rejilla = [0, 250, 500, 750, 1000]
calendarios = {'Lineal': alpha_bar_lineal, 'Coseno': alpha_bar_coseno}
fig, ejes = plt.subplots(2, 5, figsize = (11, 5.4))
for i, (nombre, alpha_bar) in enumerate(calendarios.items()):
    for j, paso in enumerate(pasos_rejilla):
        xt, _ = difundir(x0, paso, alpha_bar, rng)
        correlacion = np.corrcoef(xt.ravel(), x0.ravel())[0, 1]
        print(f'{nombre:6s} t = {paso:4d} | correlación con x0: {correlacion:.3f}')
        ejes[i, j].imshow(xt, cmap = 'gray', vmin = -2.5, vmax = 2.5)
        ejes[i, j].set_xticks([]); ejes[i, j].set_yticks([])
        ejes[i, j].set_title(f'{nombre}, t = {paso}', fontsize = 10)
fig.suptitle('La imagen de juguete se disuelve en ruido', fontsize = 16)
plt.tight_layout()

# Rejilla de la imagen ruidosa en cinco pasos para cada calendario:
plt.show()
Lineal t =    0 | correlación con x0: 1.000
Lineal t =  250 | correlación con x0: 0.655
Lineal t =  500 | correlación con x0: 0.200
Lineal t =  750 | correlación con x0: 0.041
Lineal t = 1000 | correlación con x0: 0.035
Coseno t =    0 | correlación con x0: 1.000
Coseno t =  250 | correlación con x0: 0.868
Coseno t =  500 | correlación con x0: 0.603
Coseno t =  750 | correlación con x0: 0.298
Coseno t = 1000 | correlación con x0: 0.003
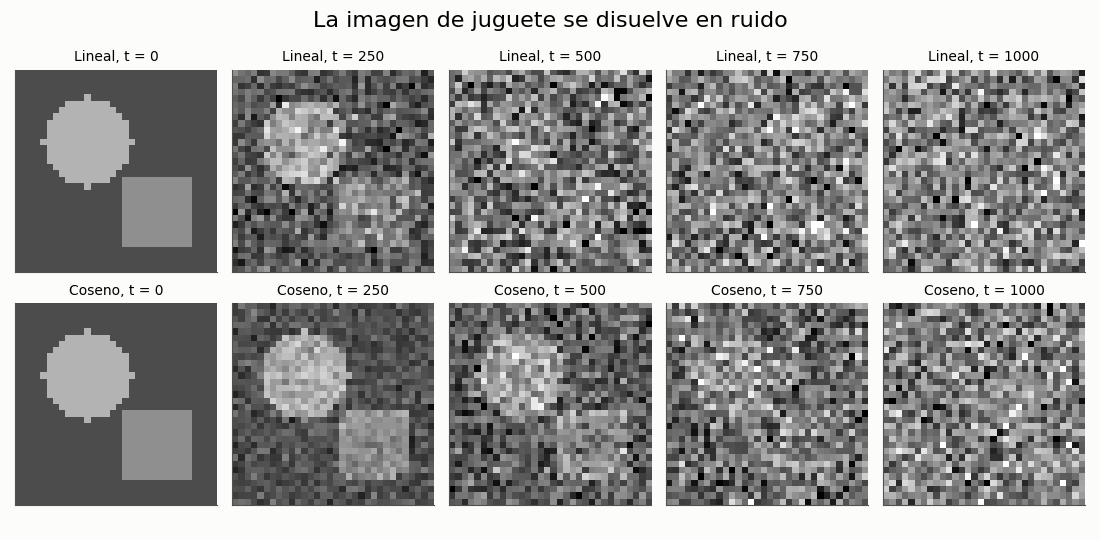
La rejilla es la versión visual de la Figura 1. En la fila del calendario lineal, el círculo y el cuadrado todavía se reconocen en $t = 250$, pero en $t = 500$ ya cuesta adivinarlos y en $t = 750$ no queda nada visible. En la fila del coseno, ambas figuras siguen claras en $t = 500$ y solo en $t = 750$ quedan como manchas tenues. La Tabla 2 reúne los valores de $\bar{\alpha}_t$ de ambos calendarios y las correlaciones con la imagen original que imprimió el bloque.
Tabla 2. Señal que sobrevive ($\bar{\alpha}_t$) y correlación con la imagen original en cinco pasos.
| Paso $t$ | $\bar{\alpha}_t$ lineal | $\bar{\alpha}_t$ coseno | Correlación lineal | Correlación coseno |
|---|---|---|---|---|
| 0 | 1 | 1 | 1.000 | 1.000 |
| 1 | 0.9999 | 0.99996 | no simulado | no simulado |
| 250 | 0.524 | 0.847 | 0.655 | 0.868 |
| 500 | 0.0786 | 0.494 | 0.200 | 0.603 |
| 750 | 0.00335 | 0.144 | 0.041 | 0.298 |
| 1000 | 0.0000404 | 0.0000000024 | 0.035 | 0.003 |
La tabla permite contrastar la teoría con la simulación. Si la imagen original tiene desviación $\sigma_0 = 0.764$, la correlación esperada entre $x_t$ y $x_0$ es $\sqrt{\bar{\alpha}_t},\sigma_0 / \sqrt{\bar{\alpha}_t \sigma_0^2 + 1 - \bar{\alpha}_t}$; para el lineal en $t = 250$ da $0.63$ y para el coseno en $t = 500$ da $0.60$, cerca de los $0.655$ y $0.603$ observados (la pequeña diferencia del lineal es ruido de muestreo, como se explica a continuación).
Hay un valor que parece desobedecer a la teoría: el lineal en $t = 1000$ marca una correlación de $0.035$, cuando la esperada es apenas $0.005$. No es un error. Con solo $1,024$ píxeles, la correlación entre dos señales independientes fluctúa con una desviación de aproximadamente $1/\sqrt{1024} = 0.031$, de modo que $0.035$ es puro azar de muestreo. Con imágenes pequeñas, las medidas también tienen ruido: si repite el bloque con otra semilla, esa cifra cambiará, mientras que las de $t = 250$ y $t = 500$ apenas se moverán.
El proceso inverso
El proceso directo no necesita aprender nada: es una fórmula. Todo el aprendizaje está en el inverso, que parte de $x_T$ (ruido) y debe llegar a una imagen. Ho, Jain y Abbeel (2020) mostraron que la forma más eficaz de plantearlo es pedir a una red neuronal que, dada la imagen ruidosa $x_t$ y el paso $t$, prediga el ruido $\epsilon$ que se le añadió. A esa red se le llama $\epsilon_\theta(x_t, t)$, donde $\theta$ son sus parámetros, y se entrena minimizando el error cuadrático entre el ruido verdadero y el predicho:
$$ L = \mathbb{E}{x_0,,t,,\epsilon}\left[\lVert \epsilon - \epsilon\theta(x_t, t) \rVert^2\right], \qquad x_t = \sqrt{\bar{\alpha}_t},x_0 + \sqrt{1-\bar{\alpha}_t},\epsilon $$
La lógica detrás de esta fórmula es múltiple:
- Es un error cuadrático medio, la misma métrica que se usa para evaluar pronósticos, solo que aplicado píxel a píxel al ruido.
- El entrenamiento es un bucle sencillo: tomar una imagen $x_0$ del conjunto de datos, elegir un paso $t$ al azar, generar $\epsilon$, construir $x_t$ con la fórmula del proceso directo y ajustar $\theta$ para que $\epsilon_\theta(x_t, t)$ se acerque a $\epsilon$.
- La red recibe $t$ como entrada porque la misma imagen ruidosa se interpreta distinto según cuánto ruido se sabe que contiene.
- Si la red sabe qué parte de $x_t$ es ruido, puede despejar una estimación de la imagen limpia: $\hat{x}_0 = (x_t - \sqrt{1-\bar{\alpha}t},\epsilon\theta) / \sqrt{\bar{\alpha}_t}$.
- En conclusión, generar una imagen se reduce a aplicar repetidamente un predictor de ruido, quitando en cada paso solo una fracción de lo que predice.
¿Y si la red fuera perfecta, la pérdida sería cero? No, y entender por qué ayuda mucho. Una misma imagen ruidosa puede venir de muchas combinaciones distintas de imagen limpia y ruido; la red solo puede predecir el ruido promedio compatible con lo que ve. Hay una parte del error que ningún modelo puede eliminar, y es mayor cuanto más ambigua es la situación. Para comprobarlo hace falta un caso en el que el desruidor perfecto se conozca con exactitud.
Un desruidor perfecto en una dimensión
Con imágenes reales, el desruidor perfecto es desconocido; por eso hay que entrenar una red. Pero si los “datos” son números sueltos que siguen una distribución conocida, el desruidor perfecto se puede escribir con una fórmula. Suponga que los datos vienen de una mezcla de dos gaussianas con medias $-2$ y $+2$, desviación $0.5$ y pesos iguales: la mitad de los valores ronda el $-2$ y la otra mitad el $+2$. Es el equivalente en una dimensión de un conjunto de imágenes con dos tipos muy distintos, como “círculos” y “cuadrados”.
La herramienta clave es la puntuación (en inglés, “score”) de una distribución: la derivada del logaritmo de su densidad, $\nabla_x \log p(x)$. Indica, desde cada punto, hacia dónde aumenta la probabilidad. En una gaussiana de media $\mu$ y varianza $\sigma^2$ vale $-(x-\mu)/\sigma^2$: apunta siempre hacia la media, con más fuerza cuanto más lejos se está. En una mezcla, la puntuación es el promedio de las puntuaciones de cada componente, ponderado por la probabilidad de que el punto pertenezca a cada una.
Song y Ermon (2019) y, después, Song y sus coautores (2021) mostraron que predecir el ruido y estimar la puntuación son el mismo problema visto desde dos ángulos:
$$ \epsilon_\theta(x_t, t) \approx -\sqrt{1-\bar{\alpha}t};\nabla{x_t} \log p_t(x_t) $$
donde $p_t$ es la distribución de los datos después de $t$ pasos de ruido. En la mezcla de gaussianas, $p_t$ sigue siendo una mezcla, con medias $\pm 2\sqrt{\bar{\alpha}_t}$ y varianza $0.25,\bar{\alpha}_t + 1 - \bar{\alpha}_t$, así que su puntuación es exacta. Con ella, generar consiste en dar pasos de dinámica de Langevin:
$$ x \leftarrow x + \frac{\eta}{2},\nabla_x \log p_t(x) + \sqrt{\eta},z, \qquad z \sim \mathcal{N}(0, 1) $$
La lógica detrás de esta fórmula es múltiple:
- El término $\frac{\eta}{2}\nabla_x \log p_t(x)$ empuja cada partícula cuesta arriba en la probabilidad, hacia el modo más cercano.
- El término $\sqrt{\eta},z$ añade un poco de ruido nuevo para que las partículas no se amontonen todas en el centro de cada modo, sino que reproduzcan también la dispersión de los datos.
- $\eta$ es el tamaño del paso; en el código es proporcional a la varianza de $p_t$, para que los pasos sean largos cuando hay mucho ruido y cortos cerca de los datos.
- La versión recocida (en inglés, “annealed”) recorre los niveles de ruido de mayor a menor, $t = 1000, 990, \ldots, 0$, y da varios pasos en cada uno; así las partículas primero se reparten entre los modos con trazos gruesos y luego afinan.
- En conclusión, conocer la puntuación en todos los niveles de ruido basta para generar; lo que aprende una red de difusión es precisamente una aproximación de esas puntuaciones.
El siguiente bloque implementa la puntuación exacta de la mezcla en cualquier paso $t$ del calendario lineal y la función paso_langevin. Además, mide la pérdida $L$ de dos desruidores sobre $20,000$ ejemplos en $t = 500$: uno ingenuo que siempre predice cero y el desruidor perfecto que sale de la fórmula anterior:
# Puntuación analítica de una mezcla de dos gaussianas y paso de Langevin en Python:
medias = np.array([-2.0, 2.0])
pesos = np.array([0.5, 0.5])
desv = 0.5

def puntuacion(x, t, alpha_bar = alpha_bar_lineal):
    # Distribución ruidosa en el paso t: medias sqrt(ab) * mu y varianza ab * desv^2 + 1 - ab:
    m = np.sqrt(alpha_bar[t]) * medias
    var = alpha_bar[t] * desv ** 2 + 1 - alpha_bar[t]
    d = x[:, None] - m[None, :]
    log_p = -0.5 * d ** 2 / var + np.log(pesos)
    resp = np.exp(log_p - log_p.max(axis = 1, keepdims = True))
    resp /= resp.sum(axis = 1, keepdims = True)        # peso de cada componente
    return (resp * (-d / var)).sum(axis = 1), var

def paso_langevin(x, t, eta_rel, rng):
    s, var = puntuacion(x, t)
    eta = eta_rel * var                                 # tamaño de paso proporcional a la varianza
    return x + 0.5 * eta * s + np.sqrt(eta) * rng.standard_normal(x.shape)

# La puntuación empuja hacia el modo más cercano:
puntos = np.array([-3.0, -2.0, -1.0, 0.0, 1.0, 2.0, 3.0])
print('x          :', puntos)
print('score t=0  :', np.round(puntuacion(puntos, 0)[0], 2) + 0.0)
print('score t=500:', np.round(puntuacion(puntos, 500)[0], 2) + 0.0)

# Pérdida L = ||epsilon - epsilon_theta||^2 de un desruidor ingenuo y del perfecto:
n = 20000
x0_1d = rng.choice(medias, size = n) + desv * rng.standard_normal(n)
t_ej = 500
epsilon = rng.standard_normal(n)
xt_1d = np.sqrt(alpha_bar_lineal[t_ej]) * x0_1d + np.sqrt(1 - alpha_bar_lineal[t_ej]) * epsilon
eps_perfecto = -np.sqrt(1 - alpha_bar_lineal[t_ej]) * puntuacion(xt_1d, t_ej)[0]
print(f'Pérdida si predice cero: {np.mean(epsilon ** 2):.4f}')
print(f'Pérdida del desruidor perfecto: {np.mean((epsilon - eps_perfecto) ** 2):.4f}')
x          : [-3. -2. -1.  0.  1.  2.  3.]
score t=0  : [ 4.  0. -4.  0.  4.  0. -4.]
score t=500: [ 2.62  1.63  0.74  0.   -0.74 -1.63 -2.62]
Pérdida si predice cero: 1.0029
Pérdida del desruidor perfecto: 0.2661
La primera parte de la salida muestra la puntuación en siete puntos. Con los datos limpios ($t = 0$), la puntuación vale $0$ exactamente en los modos $\pm 2$ (allí no hay hacia dónde subir), vale $+4$ en $x = -3$ y en $x = 1$ (empuja hacia la derecha, hacia $-2$ y $+2$, respectivamente) y $-4$ en $x = -1$ y $x = 3$. En $x = 0$ también vale $0$, pero por otra razón: es el punto de equilibrio entre los dos modos, una cima de indecisión de la que cualquier empujón aleatorio saca a la partícula. En $t = 500$, las puntuaciones son más suaves ($\pm 2.62$ en los extremos) y ya no se anulan en $\pm 2$: con tanto ruido, la distribución es más ancha y sus modos están más cerca del cero.
La segunda parte responde a la pregunta de antes. El desruidor ingenuo obtiene una pérdida de $1.0029$, que es simplemente la varianza del ruido (predecir cero equivale a no saber nada). El desruidor perfecto, que conoce la distribución exacta, baja a $0.2661$, pero no a cero. Ese $0.27$ es el error irreducible del paso $t = 500$: con un $\bar{\alpha}_{500} = 0.0786$, una misma $x_t$ es compatible con muchos pares de dato y ruido. La pérdida de un modelo de difusión nunca llega a cero, y no debe hacerlo: lo que se compara es cuánto se acerca a ese límite.
Con la puntuación en la mano, el siguiente código lanza 50 partículas desde ruido puro $\mathcal{N}(0, 1)$, las hace recorrer 101 niveles de ruido (de $t = 1000$ a $t = 0$, de 10 en 10) con cinco pasos de Langevin por nivel y dibuja sus trayectorias, coloreadas según el modo en el que terminan, junto al histograma final y la densidad verdadera de los datos:
# Trayectorias del proceso inverso con Langevin recocido en una dimensión en Python:
particulas = 50
x = rng.standard_normal(particulas)                  # ruido puro N(0, 1)
niveles = list(range(T, 0, -10)) + [0]               # 101 niveles de ruido, de t = 1000 a t = 0
historia = [x.copy()]
for nivel in niveles:
    for _ in range(5):                                # cinco pasos de Langevin por nivel
        x = paso_langevin(x, nivel, 0.1, rng)
    historia.append(x.copy())
historia = np.array(historia)
final = historia[-1]

fig, (ax, ax_hist) = plt.subplots(1, 2, figsize = (9, 4.8), sharey = True,
                                  gridspec_kw = {'width_ratios': [4, 1]})
for k in range(particulas):
    color = NARANJA if final[k] > 0 else AZUL
    ax.plot(np.arange(len(historia)), historia[:, k], color = color, linewidth = 0.8, alpha = 0.6)
ax.set_title('Del ruido a los modos: proceso inverso en 1D', fontsize = 16)
ax.set_xlabel('Nivel recorrido (0 = ruido puro, 101 = datos)')
ax.set_ylabel('$x$')
ax.grid(alpha = 0.25)
ancho_barra = 0.25
ax_hist.hist(final, bins = np.arange(-4, 4.01, ancho_barra), orientation = 'horizontal', color = '#9a9994')
malla = np.linspace(-4, 4, 400)
densidad = sum(w * np.exp(-0.5 * ((malla - m) / desv) ** 2) / (desv * np.sqrt(2 * np.pi))
               for w, m in zip(pesos, medias))
ax_hist.plot(densidad * particulas * ancho_barra, malla, color = '#0b0b0b', linewidth = 1.5)
ax_hist.set_xlabel('Partículas')
ax_hist.set_title('Final', fontsize = 11)
plt.tight_layout()
print(f'Partículas en el modo +2: {(final > 0).sum()} | en el modo -2: {(final < 0).sum()}')
print(f'Modo +2: media {final[final > 0].mean():.3f}, desviación {final[final > 0].std():.3f}')
print(f'Modo -2: media {final[final < 0].mean():.3f}, desviación {final[final < 0].std():.3f}')

# Trayectorias de 50 partículas y su histograma final:
plt.show()
Partículas en el modo +2: 19 | en el modo -2: 31
Modo +2: media 1.927, desviación 0.397
Modo -2: media -2.074, desviación 0.523
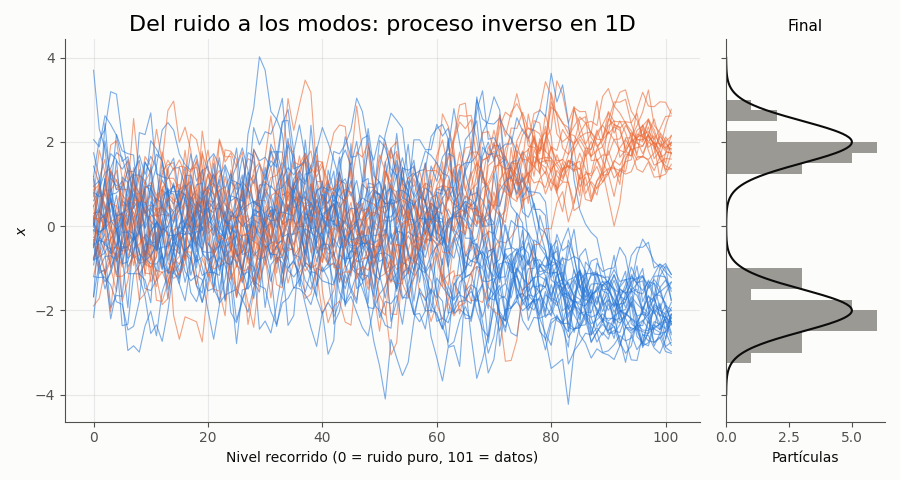
La Figura 4 es la imagen más importante del día, aunque no contenga ninguna imagen. Durante los primeros 60 niveles, las 50 trayectorias se mezclan en una banda alrededor de cero: con tanto ruido, la distribución $p_t$ es casi una sola campana y nada distingue un modo del otro. Entre los niveles 60 y 80 ocurre la decisión: las trayectorias se separan en dos haces, uno hacia $+2$ y otro hacia $-2$. En los últimos niveles, cada haz se estrecha alrededor de su modo, mientras el ruido de Langevin mantiene su dispersión.
El resultado reproduce la distribución de los datos. El modo $+2$ recibió $19$ partículas, con media $1.927$ y desviación $0.397$; el modo $-2$ recibió $31$, con media $-2.074$ y desviación $0.523$. Las medias y desviaciones están cerca de los valores verdaderos ($\pm 2$ y $0.5$). El reparto de $19$ a $31$, en vez de $25$ a $25$, es variabilidad de muestreo con solo 50 partículas: una prueba binomial con probabilidad $0.5$ da un reparto así o más desigual en aproximadamente el $12%$ de los casos. El proceso inverso no copia ningún dato: produce valores nuevos que siguen la misma distribución. En una imagen pasa lo mismo, pero en miles de dimensiones a la vez, y el momento de “decisión” de la figura es cuando se fija la composición general (dónde va cada forma), mientras que los últimos pasos afinan texturas y bordes.
Diego mira la figura con desconfianza y pregunta lo obvio: Si el desruidor es una fórmula, ¿para qué la red? La respuesta es que esta fórmula solo existe porque los datos son una mezcla de dos gaussianas escogida a propósito. Nadie conoce la distribución de “todas las portadas posibles de un cuaderno”; por eso se entrena una red con miles de millones de parámetros para aproximar su puntuación a partir de ejemplos. El algoritmo de generación, en cambio, es esencialmente el mismo que acaba de ejecutar.
Difusión latente
Hasta aquí, el ruido se añadía y se quitaba directamente sobre los píxeles. Funciona, pero es caro: una portada de 512×512 píxeles en color tiene $512 \times 512 \times 3 = 786,432$ valores, y la red tiene que procesarlos todos en cada uno de los pasos del proceso inverso. Rombach y sus coautores (2022) propusieron separar el problema en dos. Primero, un autocodificador aprende a comprimir cada imagen en un espacio latente mucho más pequeño y a reconstruirla desde ahí con pérdidas casi imperceptibles. Después, la difusión se aplica dentro de ese espacio latente. A esto se le llama difusión latente, y es la base de Stable Diffusion, de SDXL y de FLUX.1.
Falta la tercera pieza: el texto. Para que Sofía pueda pedir “una portada de cuaderno con tonos de otoño”, un codificador de texto convierte el prompt en una secuencia de vectores, y el desruidor los recibe como condición en cada paso, a través de capas de atención cruzada (el mismo mecanismo de atención que vio en los modelos de lenguaje del módulo 1). Así, el desruidor no predice “el ruido” en general, sino “el ruido, sabiendo que la imagen debe parecerse a esta descripción”. El siguiente código dibuja el flujo completo con FancyBboxPatch y FancyArrowPatch y calcula el factor de compresión del espacio latente de Stable Diffusion:
# Diagrama de un modelo de difusión latente con patches en Python:
from matplotlib.patches import FancyBboxPatch, FancyArrowPatch

def caja(ax, x, y, texto, color, ancho = 2.3, alto = 1.0):
    ax.add_patch(FancyBboxPatch((x, y), ancho, alto, boxstyle = 'round,pad=0.05,rounding_size=0.15',
                                facecolor = color, edgecolor = '#52514e', linewidth = 1.2))
    ax.text(x + ancho / 2, y + alto / 2, texto, ha = 'center', va = 'center', fontsize = 9.5, color = '#0b0b0b')

def flecha(ax, origen, destino, texto = ''):
    ax.add_patch(FancyArrowPatch(origen, destino, arrowstyle = '-|>', mutation_scale = 14,
                                 color = '#52514e', linewidth = 1.3))
    if texto:
        ax.text((origen[0] + destino[0]) / 2 + 0.15, (origen[1] + destino[1]) / 2, texto,
                ha = 'left', va = 'center', fontsize = 8.5, color = '#52514e')

fig, ax = plt.subplots(figsize = (11, 4.6))
ax.set_xlim(0, 13.5); ax.set_ylim(0, 5.6); ax.axis('off')
caja(ax, 0.1, 3.9, 'Prompt de Sofía:\n"portada de cuaderno"', '#f0efec', ancho = 2.6)
caja(ax, 3.4, 3.9, 'Codificador de texto\n(CLIP o T5)', '#cde2fb', ancho = 2.6)
caja(ax, 0.1, 1.3, 'Ruido latente\n64 x 64 x 4', '#f0efec')
caja(ax, 3.4, 1.3, 'Desruidor\n(U-Net o transformador)', '#fbd9c9', ancho = 2.6)
caja(ax, 7.0, 1.3, 'Latente limpio\n64 x 64 x 4', '#f0efec')
caja(ax, 10.2, 1.3, 'Decodificador\ndel VAE', '#d3f0e4')
caja(ax, 10.2, 3.9, 'Imagen\n512 x 512 x 3', '#f0efec')
flecha(ax, (2.8, 4.4), (3.35, 4.4))
flecha(ax, (4.7, 3.85), (4.7, 2.4), 'condición')
flecha(ax, (2.45, 1.8), (3.35, 1.8))
flecha(ax, (6.05, 1.8), (6.95, 1.8))
flecha(ax, (9.35, 1.8), (10.15, 1.8))
flecha(ax, (11.35, 2.4), (11.35, 3.85))
ax.add_patch(FancyArrowPatch((5.6, 1.25), (3.8, 1.25), connectionstyle = 'arc3,rad=-0.6',
                             arrowstyle = '-|>', mutation_scale = 12, color = NARANJA, linewidth = 1.5))
ax.text(4.7, 0.2, 'se repite N pasos (de t = T a t = 0)', ha = 'center', fontsize = 9, color = '#52514e')
ax.text(6.75, 5.35, 'Difusión latente: el ruido se quita en un espacio comprimido', ha = 'center', fontsize = 16)
pixeles, latente = 512 * 512 * 3, 64 * 64 * 4
print(f'Valores en píxeles: {pixeles:,} | en el latente: {latente:,} | compresión: {pixeles / latente:.0f}x')

# Flujo de texto, ruido latente, desruidor y decodificador:
plt.show()
Valores en píxeles: 786,432 | en el latente: 16,384 | compresión: 48x
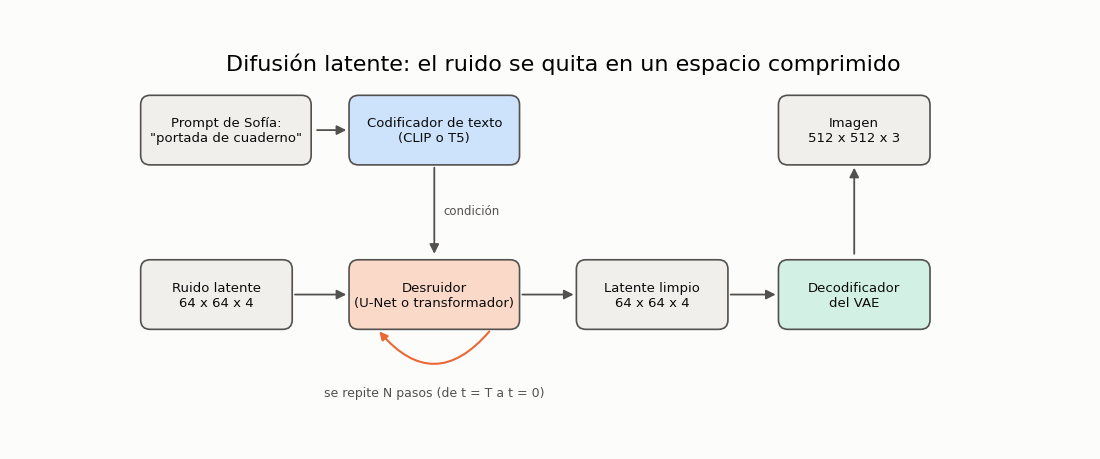
La Figura 5 muestra el recorrido. Arriba, el prompt de Sofía pasa por el codificador de texto y baja como condición al desruidor. Abajo, un tensor de ruido latente de 64×64×4 entra al desruidor, que se aplica $N$ veces (la flecha curva naranja) hasta obtener un latente limpio; solo entonces el decodificador del autocodificador lo convierte en una imagen de 512×512×3 píxeles. Observe que el decodificador se ejecuta una sola vez, al final; el desruidor, en cambio, se ejecuta en cada paso.
La cifra que imprime el bloque explica la ventaja: el latente tiene $16,384$ valores frente a $786,432$ de la imagen, una compresión de $48$ veces. Como el desruidor es la pieza que se repite, trabajar en el latente abarata cada paso en un factor parecido. El autocodificador reduce cada lado de la imagen ocho veces (512 entre 8 es 64) y guarda cuatro canales en lugar de tres; esos canales ya no son “rojo, verde y azul”, sino rasgos aprendidos que resumen bloques de 8×8 píxeles. La Tabla 3 resume las tres piezas de un modelo de difusión latente.
Tabla 3. Componentes de un modelo de difusión latente y su función.
| Componente | Entrada y salida | Cuándo se ejecuta | Ejemplos reales |
|---|---|---|---|
| Codificador de texto | Prompt → secuencia de vectores | Una vez por imagen | CLIP ViT-L y OpenCLIP ViT-bigG (SDXL); T5-XXL y CLIP ViT-L (FLUX.1) |
| Desruidor | Latente ruidoso, $t$ y texto → ruido predicho | En cada paso (de 4 a 50 o más) | U-Net (Stable Diffusion, SDXL); transformador (FLUX.1) |
| Autocodificador (VAE) | Imagen ↔ latente | El codificador al entrenar; el decodificador una vez al generar | VAE de 4 canales (SD y SDXL) o de 16 canales (FLUX.1) |
Tres matices de la tabla conviene tenerlos presentes. Primero, el desruidor no tiene por qué ser una U-Net (una red convolucional en forma de U, con conexiones entre la rama que comprime y la que expande): los modelos más recientes, como FLUX.1, usan un transformador que trata el latente como una secuencia de parches. Segundo, FLUX.1 no se entrena exactamente con la pérdida de predicción de ruido que vio hoy, sino con una variante llamada flujo rectificado (en inglés, “rectified flow”), que aprende a transportar el ruido hacia los datos por caminos casi rectos; la intuición de “partir del ruido y quitarlo paso a paso” se mantiene intacta. Tercero, SDXL genera de forma nativa a 1024×1024 píxeles, así que su latente es de 128×128×4, y FLUX.1 usa 16 canales latentes en lugar de 4.
Del laboratorio a su laptop
Todo lo anterior se puede calcular en cualquier computadora. Generar una portada real con SDXL o FLUX.1 es otra cosa: cada paso del proceso inverso pasa el latente por una red de miles de millones de parámetros, y esa red tiene que caber en la memoria de la tarjeta gráfica (GPU). Antes de llegar ahí, vale la pena comprobar que las fórmulas de hoy son las mismas que usa la biblioteca de referencia, diffusers de Hugging Face.
La clase DDPMScheduler de diffusers implementa el calendario de Ho, Jain y Abbeel. Instanciarla no descarga pesos ni necesita GPU: solo construye los arreglos de $\beta_t$ y $\bar{\alpha}_t$ (que la biblioteca llama alphas_cumprod). El siguiente bloque no se ejecutó al escribir la entrada, porque diffusers no forma parte de las dependencias que se ejecutan en esta serie; su salida es un ejemplo comentado. Fíjese en el índice: diffusers numera los pasos desde $0$, de modo que el paso $t$ de las fórmulas es la posición t - 1 del arreglo:
# Inspección del calendario real de diffusers en Python:
from diffusers import DDPMScheduler

planificador = DDPMScheduler(num_train_timesteps = 1000, beta_start = 0.0001,
                             beta_end = 0.02, beta_schedule = 'linear')
alphas_cumprod = planificador.alphas_cumprod.numpy()

# El paso t de las fórmulas es la posición t - 1 del arreglo:
for paso in [1, 250, 500, 750, 1000]:
    print(f't = {paso:4d} | alpha_bar = {alphas_cumprod[paso - 1]:.4g} | numpy: {alpha_bar_lineal[paso]:.4g}')

# Salida de ejemplo (puede variar):
# t =    1 | alpha_bar = 0.9999 | numpy: 0.9999
# t =  250 | alpha_bar = 0.5241 | numpy: 0.5241
# t =  500 | alpha_bar = 0.07859 | numpy: 0.07859
# t =  750 | alpha_bar = 0.003351 | numpy: 0.003351
# t = 1000 | alpha_bar = 4.036e-05 | numpy: 4.036e-05
Si ejecuta el bloque con diffusers instalado, los cinco valores coinciden con la Tabla 2 salvo, a lo sumo, en la última cifra, porque la biblioteca calcula en precisión simple (float32) con PyTorch y numpy en precisión doble. Esa coincidencia es la mejor prueba de que lo que calculó hoy no es una versión de juguete del mecanismo, sino el mismo calendario con el que se entrenó el modelo original de Ho y sus coautores. La biblioteca ofrece también beta_schedule = 'squaredcos_cap_v2', que es el calendario coseno con el recorte en $0.999$, y 'scaled_linear', el que usa Stable Diffusion.
Cuánta memoria pide un modelo real
La memoria que ocupan los pesos de una red se estima con una multiplicación: número de parámetros por bytes por parámetro. En precisión simple cada parámetro ocupa 4 bytes; en media precisión (float16 o bfloat16), 2; cuantizado a 8 bits, 1. El siguiente código aplica esa cuenta a las piezas de SDXL base 1.0 y de FLUX.1 schnell, con recuentos de parámetros aproximados tomados de los artículos y fichas de cada modelo:
# Estimación de la memoria que ocupan los pesos de SDXL y FLUX.1 schnell en Python:
componentes = pd.DataFrame([
    ('SDXL base 1.0', 'U-Net', 2.567),
    ('SDXL base 1.0', 'CLIP ViT-L (texto)', 0.123),
    ('SDXL base 1.0', 'OpenCLIP ViT-bigG (texto)', 0.695),
    ('SDXL base 1.0', 'VAE', 0.084),
    ('FLUX.1 schnell', 'Transformador', 11.9),
    ('FLUX.1 schnell', 'T5-XXL (texto)', 4.76),
    ('FLUX.1 schnell', 'CLIP ViT-L (texto)', 0.123),
    ('FLUX.1 schnell', 'VAE', 0.084),
], columns = ['modelo', 'componente', 'miles_de_millones'])
bytes_por_parametro = {'float32': 4, '16 bits': 2, '8 bits': 1}
resumen = componentes.groupby('modelo')['miles_de_millones'].sum().to_frame('parametros_mm')
for precision, b in bytes_por_parametro.items():
    resumen[f'GB {precision}'] = resumen['parametros_mm'] * b
print(resumen.round(1).to_string())

# Solo el desruidor en 16 bits (lo mínimo que debe vivir en la GPU durante el bucle):
desruidor = componentes[componentes['componente'].isin(['U-Net', 'Transformador'])]
print((desruidor.set_index('modelo')['miles_de_millones'] * 2).round(1).rename('GB desruidor 16 bits').to_string())
                parametros_mm  GB float32  GB 16 bits  GB 8 bits
modelo
FLUX.1 schnell           16.9        67.5        33.7       16.9
SDXL base 1.0             3.5        13.9         6.9        3.5
modelo
SDXL base 1.0      5.1
FLUX.1 schnell    23.8
La Tabla 4 ordena la salida. Las cifras son estimaciones de los pesos, no mediciones: durante la generación hacen falta además memoria para las activaciones, el latente y el propio entorno de PyTorch, que en la práctica añaden de uno a varios GB según la resolución.
Tabla 4. Memoria aproximada de los pesos de SDXL base 1.0 y FLUX.1 schnell según la precisión (GB).
| Modelo | Parámetros (miles de millones) | float32 | 16 bits | 8 bits | Solo el desruidor en 16 bits |
|---|---|---|---|---|---|
| SDXL base 1.0 | 3.5 | 13.9 | 6.9 | 3.5 | 5.1 |
| FLUX.1 schnell | 16.9 | 67.5 | 33.7 | 16.9 | 23.8 |
La lectura para Sofía es directa. SDXL en 16 bits necesita unos $6.9$ GB solo para los pesos, así que cabe en una GPU de 8 GB con margen escaso y cómodamente en una de 12 GB. FLUX.1 schnell, con sus 12 mil millones de parámetros del transformador más los 4.76 mil millones del codificador T5-XXL, suma casi $34$ GB en 16 bits; ni siquiera el transformador solo ($23.8$ GB) cabe en una GPU doméstica de 16 GB. Las técnicas para que quepa existen (descargar a la memoria del sistema las piezas que no se están usando, cuantizar a 8 o 4 bits), pero cambian memoria por tiempo de espera.
La laptop de Sofía tiene una GPU integrada sin memoria propia. Con esos datos, Diego hace la cuenta antes que ella: generar en local no es una opción razonable para FLUX.1 y apenas lo es para SDXL. El Día 11 comparará tres caminos (local y abierto, local con pesos descargables y servicio en la nube) con su coste por imagen. Para que vea cómo se ve el código cuando sí hay GPU, el siguiente bloque genera una portada de prueba con FLUX.1 schnell. Necesita una GPU con CUDA y descargar unos 30 GB de pesos, así que no se ejecutó al escribir la entrada; su salida es un ejemplo comentado:
# Portada de prueba con FLUX.1 schnell y diffusers (requiere GPU) en Python:
import torch
from diffusers import FluxPipeline

tubo = FluxPipeline.from_pretrained('black-forest-labs/FLUX.1-schnell', torch_dtype = torch.bfloat16)
tubo.enable_model_cpu_offload()   # mueve a la GPU solo la pieza que se está usando

prompt = ('Portada ilustrada de un cuaderno de estudio: una taza de café, una guitarra '
          'y hojas con gráficas, acuarela en tonos ocres y azules, luz suave de tarde')
imagen = tubo(
    prompt,
    guidance_scale = 0.0,           # schnell está destilado y no usa guía
    num_inference_steps = 4,        # schnell está pensado para 1 a 4 pasos
    max_sequence_length = 256,      # límite de tokens del codificador T5 en schnell
    generator = torch.Generator('cpu').manual_seed(2026),
).images[0]

# Guardar la portada de prueba e informar de su tamaño:
imagen.save('cuaderno_vivo/portadas/prueba_dia_9.png')
print('Tamaño:', imagen.size, '| modo:', imagen.mode)

# Salida de ejemplo (puede variar):
# Tamaño: (1024, 1024) | modo: RGB
Cada argumento corresponde a algo que ya conoce. num_inference_steps = 4 es el número de pasos del proceso inverso: FLUX.1 schnell es una versión destilada, entrenada para recorrer el camino del ruido a la imagen en solo cuatro saltos, frente a los 50 habituales en SDXL. guidance_scale = 0.0 desactiva la guía sin clasificador, una técnica que refuerza el peso del prompt y que se estudiará mañana; schnell no la necesita porque ya se destiló con ella. max_sequence_length = 256 limita la longitud del prompt que procesa el codificador T5, y manual_seed(2026) fija el ruido inicial: con la misma semilla, el mismo prompt y los mismos parámetros, la portada es la misma, porque todo lo aleatorio del proceso nace del ruido de partida.
Licencias de los modelos citados, según sus fichas en Hugging Face: FLUX.1 [schnell] se publica bajo Apache 2.0 (permite uso comercial); FLUX.1 [dev] bajo la FLUX.1-dev Non-Commercial License; SDXL base 1.0 bajo CreativeML Open RAIL++-M, que permite el uso comercial con restricciones de uso. Antes de publicar una imagen generada, revise la ficha del modelo exacto que usó y añada la etiqueta visible “Generado con IA”, como exige la regla ética de la serie.
Consideraciones finales
Entender el mecanismo de la difusión explica de golpe los parámetros que Sofía verá mañana en cualquier generador. El número de pasos es cuántas veces se aplica el desruidor: más pasos permiten correcciones más finas, hasta que dejan de aportar. La semilla fija el ruido de partida, y por eso dos imágenes con el mismo prompt y distinta semilla comparten estilo pero no composición: como vio en la Figura 4, la composición se decide en los primeros pasos, cuando el ruido todavía manda. La escala de guía controla cuánto pesa el texto en cada predicción de ruido. Y el calendario de ruido decide cuánto esfuerzo se dedica a la forma general y cuánto al detalle.
Antes de pasar a los prompts visuales, conviene hacerse algunas preguntas:
- ¿Sabría explicar con sus palabras por qué una red que solo predice ruido acaba produciendo imágenes nuevas?
- ¿Qué calendario dedica más pasos a la zona en que la imagen todavía se reconoce, y por qué importa en imágenes pequeñas?
- ¿Por qué la pérdida del desruidor perfecto de hoy fue $0.27$ y no cero?
- Para su propio proyecto, ¿cabe el modelo que le interesa en la memoria de su GPU, o necesita un servicio externo?
Hay además una pregunta que no se responde con fórmulas. Un modelo de difusión aprende la distribución de sus datos de entrenamiento, y esos datos son, en los grandes modelos, cientos de millones de imágenes recogidas de internet, muchas de ellas con autor, con licencia o con personas identificables. Lo que el modelo genera es nuevo en el mismo sentido en que lo eran las partículas de la Figura 4: no copia un dato concreto, pero solo puede producir lo que su distribución de entrenamiento hace probable. ¿Quién tiene derechos sobre esa distribución? La serie retomará la pregunta en los días 11 y 12, al elegir herramientas y escribir la guía de estilo del Cuaderno Vivo, y a fondo en el Día 20. Por ahora, Sofía adopta dos reglas: no pedir imágenes “al estilo de” artistas vivos nombrados y etiquetar como “Generado con IA” toda portada que publique.
Las cifras de hoy tienen límites claros. La imagen de 32×32 y la mezcla de dos gaussianas son ejemplos de juguete elegidos para que todo se pueda calcular; las correlaciones y los repartos de partículas dependen de la semilla; y la memoria de la Tabla 4 se estimó a partir de recuentos de parámetros aproximados, no se midió en una GPU. Ninguno de esos límites afecta al mecanismo, que es exactamente el que usan los modelos reales.
Un gran libro que habla de esto es Understanding Deep Learning (2023), en el que Simon J. D. Prince dedica capítulos completos a las GAN, a los autocodificadores variacionales y a los modelos de difusión, con la misma progresión de hoy: del proceso directo a la pérdida, y de ahí a la generación. Su lectura le ayudará a pasar de la intuición a las demostraciones sin perderse, y el autor ofrece gratuitamente el libro y sus cuadernos de ejercicios en su sitio web.
Un modelo de difusión no es un pintor que imagina, es un predictor de ruido que se aplica muchas veces sobre ruido. Entender eso le permite usar un generador de imágenes como lo que es, un proceso con parámetros que usted controla, y no como una caja que a veces acierta.
Conclusiones clave
Proceso directo
- El proceso directo añade ruido gaussiano según un calendario $\beta_t$, y todo él se resume en $\bar{\alpha}t = \prod{s=1}^{t}(1-\beta_s)$, la fracción de señal que sobrevive.
- La forma $x_t = \sqrt{\bar{\alpha}_t},x_0 + \sqrt{1-\bar{\alpha}_t},\epsilon$ permite saltar a cualquier paso sin recorrer los intermedios.
- En la imagen de juguete de 32×32, la correlación con el original baja de $0.655$ en $t = 250$ a $0.200$ en $t = 500$ con el calendario lineal.
Calendarios
- El calendario lineal ($\beta$ de $10^{-4}$ a $0.02$, $T = 1000$) deja solo un $7.9%$ de señal a mitad del camino y pasa $259$ pasos con más señal que ruido.
- El calendario coseno conserva el $49.4%$ en $t = 500$ y reparte $496$ pasos en la zona de más señal que ruido, por eso preserva mejor el detalle en imágenes pequeñas.
- Un calendario cuya SNR final no llega a cero deja una fuga de señal que limita el brillo de las imágenes generadas.
Proceso inverso y latentes
- La red aprende a predecir el ruido con la pérdida $L = \lVert \epsilon - \epsilon_\theta(x_t, t) \rVert^2$; predecir el ruido equivale a estimar la puntuación de los datos.
- Ni un desruidor perfecto llega a pérdida cero: en $t = 500$ baja de $1.003$ a $0.266$, el error irreducible.
- Con la puntuación exacta, 50 partículas pasan del ruido puro a los modos $\pm 2$ con medias de $1.927$ y $-2.074$.
- La difusión latente trabaja en un espacio $48$ veces menor que los píxeles; SDXL ocupa unos $6.9$ GB en 16 bits y FLUX.1 schnell unos $34$ GB.
Mañana, en el Día 10: Prompts visuales: composición, estilo y guía por texto. Con el mecanismo ya entendido, Sofía aprenderá a escribir prompts de imagen con estructura (sujeto, entorno, composición, luz, paleta y estilo) y a controlar los parámetros que hoy solo se nombraron, desde la escala de guía hasta la semilla.
Referencias
- Ho, J., Jain, A. y Abbeel, P. (2020). Denoising Diffusion Probabilistic Models. Advances in Neural Information Processing Systems 33 (NeurIPS 2020).
- Nichol, A. y Dhariwal, P. (2021). Improved Denoising Diffusion Probabilistic Models. Proceedings of the 38th International Conference on Machine Learning (ICML 2021).
- Rombach, R., Blattmann, A., Lorenz, D., Esser, P. y Ommer, B. (2022). High-Resolution Image Synthesis with Latent Diffusion Models. Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR 2022).
- Sohl-Dickstein, J., Weiss, E., Maheswaranathan, N. y Ganguli, S. (2015). Deep Unsupervised Learning using Nonequilibrium Thermodynamics. Proceedings of the 32nd International Conference on Machine Learning (ICML 2015).
- Song, Y. y Ermon, S. (2019). Generative Modeling by Estimating Gradients of the Data Distribution. Advances in Neural Information Processing Systems 32 (NeurIPS 2019).
- Song, Y., Sohl-Dickstein, J., Kingma, D. P., Kumar, A., Ermon, S. y Poole, B. (2021). Score-Based Generative Modeling through Stochastic Differential Equations. International Conference on Learning Representations (ICLR 2021).
- Lin, S., Liu, B., Li, J. y Yang, X. (2024). Common Diffusion Noise Schedules and Sample Steps are Flawed. Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision (WACV 2024).
- Podell, D. et al. (2023). SDXL: Improving Latent Diffusion Models for High-Resolution Image Synthesis. arXiv:2307.01952.
- Prince, S. J. D. (2023). Understanding Deep Learning. MIT Press.